RAG(Retrieval-Augmented Generation)는 이제 생성형 AI 서비스를 만들 때 가장 많이 사용되는 아키텍처 중 하나가 되었다.
기업 내부 문서를 검색하거나, 매뉴얼을 기반으로 질문에 답하거나, 수많은 보고서에서 필요한 정보를 찾아주는 AI 서비스를 생각해보자.
일반적인 RAG 시스템은 대략 다음과 같이 동작한다.
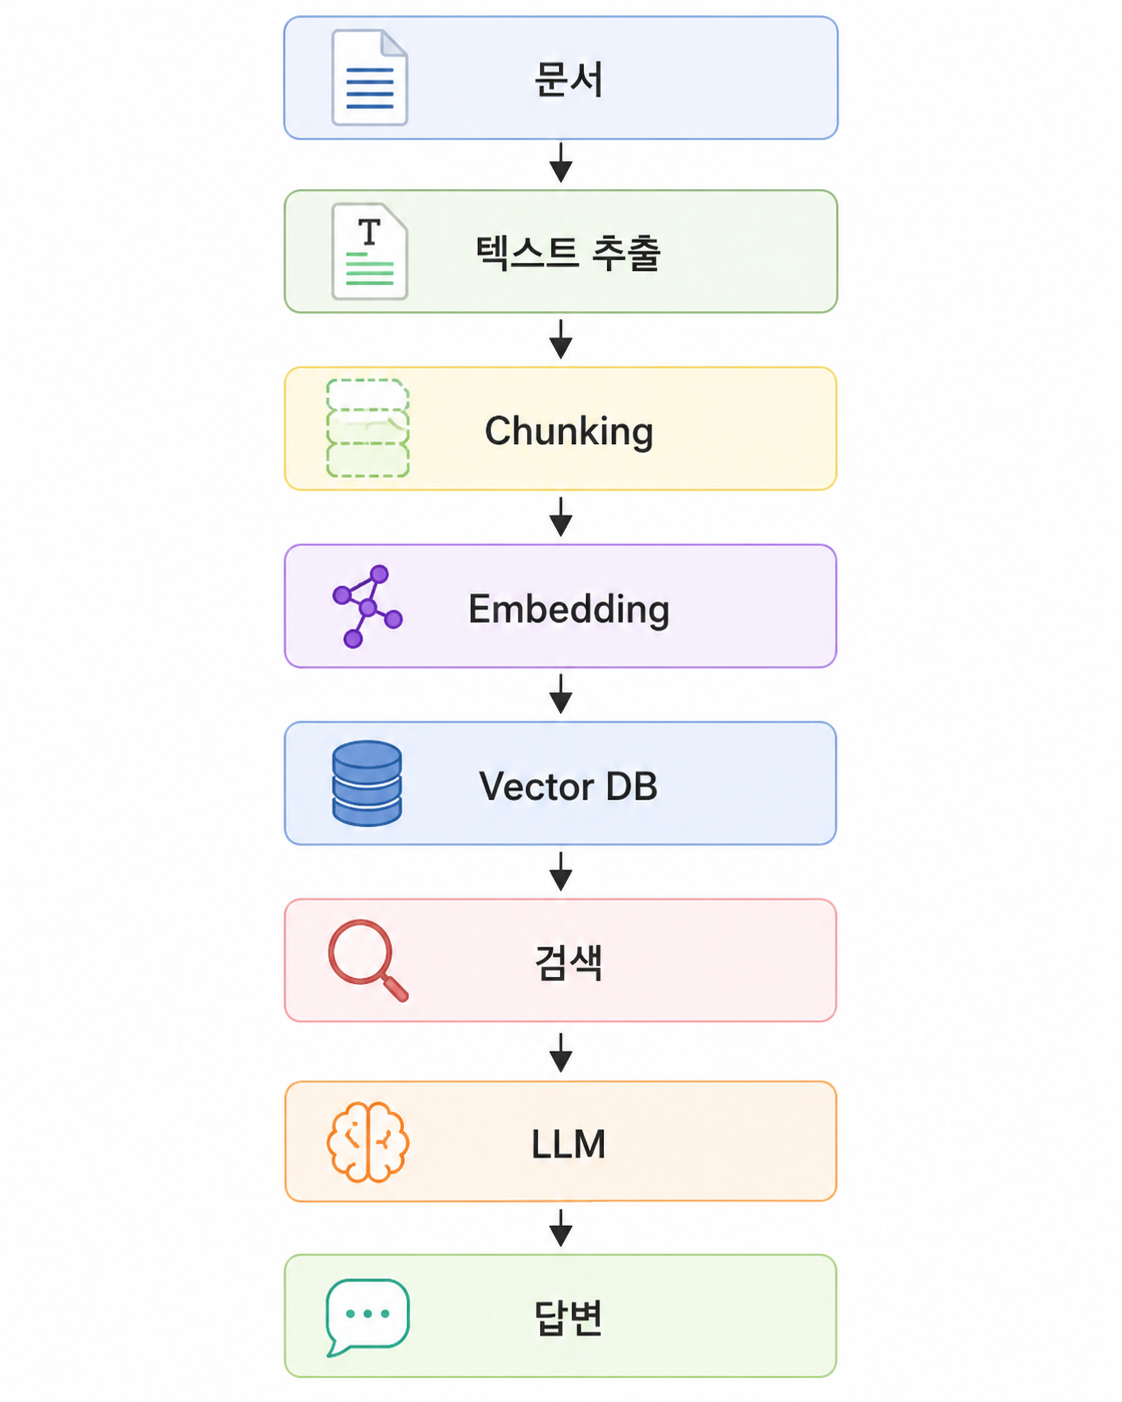
그런데 여기에는 한 가지 중요한 전제가 숨어 있다.
문서의 의미를 텍스트로 변환할 수 있다.
과연 항상 그럴까?
PDF 보고서, 논문, 프레젠테이션, 재무제표처럼 표와 그래프가 많은 문서를 생각해보면 이야기가 달라진다.
문서에는 글자만 있는 것이 아니다.
표의 행과 열, 그래프의 높이, 이미지와 설명의 위치, 제목과 본문의 계층 관계까지 모두 정보다.
그런데 기존 RAG는 이 문서를 먼저 텍스트로 바꾼 뒤 검색한다.
바로 이 지점에서 Pixel RAG라는 새로운 접근이 등장한다.
1. 기존 RAG는 실제 문서를 검색하지 않는다
PDF 파일을 RAG에 넣는다고 생각해보자.
사용자 입장에서는 PDF를 AI에게 전달했으니 AI가 PDF를 읽는다고 생각하기 쉽다.
하지만 대부분의 RAG 시스템 내부에서는 그렇지 않다.
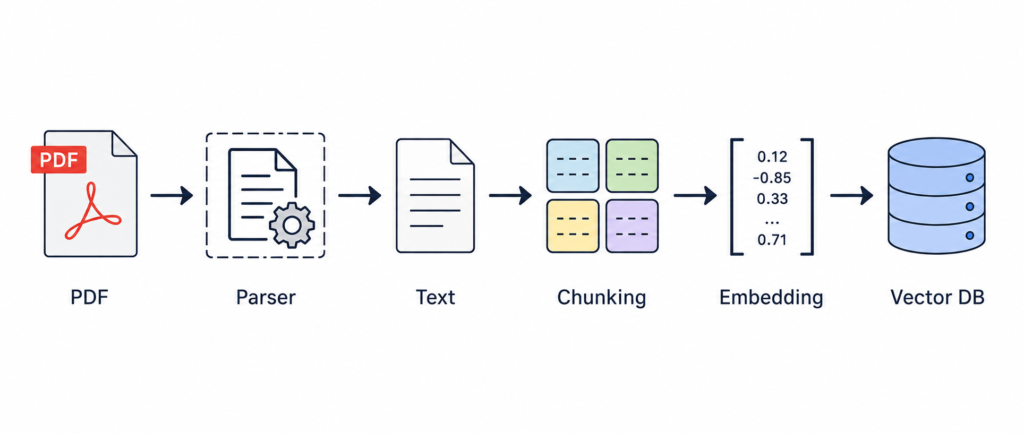
즉 PDF 자체를 검색하는 것이 아니다.
PDF에서 추출된 텍스트를 검색한다.
이 차이는 매우 중요하다.
2. 텍스트 중심 문서에서는 별 문제가 없다
예를 들어 다음과 같은 사내 규정이 있다고 하자.
------------------------------------------------
제17조 개인정보 보관

회사는 계약 종료 후 개인정보를 3년간 보관한다.

보관 기간이 종료된 개인정보는 복구할 수 없는 방법으로
즉시 파기한다.
-------------------------------------------------
이 문서를 Parser가 처리하면 거의 동일한 텍스트를 얻을 수 있다.
회사는 계약 종료 후 개인정보를 3년간 보관한다.
보관 기간이 종료된 개인정보는 복구할 수 없는 방법으로
즉시 파기한다.
이것을 Chunk로 나누고 Embedding하면 된다.
사용자가
개인정보는 몇 년 동안 보관하나요?
라고 질문하면 관련 Chunk를 쉽게 검색할 수 있다.
이런 문서는 기존 Text RAG가 매우 잘 처리한다.
3. 그런데 표를 만나면 이야기가 달라진다
이번에는 다음과 같은 페이지를 생각해보자.
2026년 제품별 매출
제품 | 2025년 | 2026년 | 증가율 |
| A | 100 | 180 | +80% |
| B | 200 | 150 | -25% |
| C | 80 | 160 | +100% |
※ 해외 매출 제외
사람은 이 표를 보는 순간 구조를 이해한다.
제품 C가 80에서 160으로 증가했고 증가율이 100%라는 것도 쉽게 알 수 있다.
그런데 PDF Parser가 다음처럼 텍스트를 추출했다고 해보자.
2026년 제품별 매출

제품
2025년
2026년
증가율

A
B
C

100
200
80

180
150
160

80%
-25%
100%

해외 매출 제외
모든 글자는 살아 있다.
그런데 중요한 것이 사라졌다.
글자 사이의 관계다.
어떤 숫자가 어떤 제품에 해당하는지, 어떤 숫자가 어느 연도인지, 증가율이 어느 행과 연결되는지 알기 어려워진다.
4. 그래프에서는 문제가 더 커진다
다음과 같은 페이지가 있다고 하자.
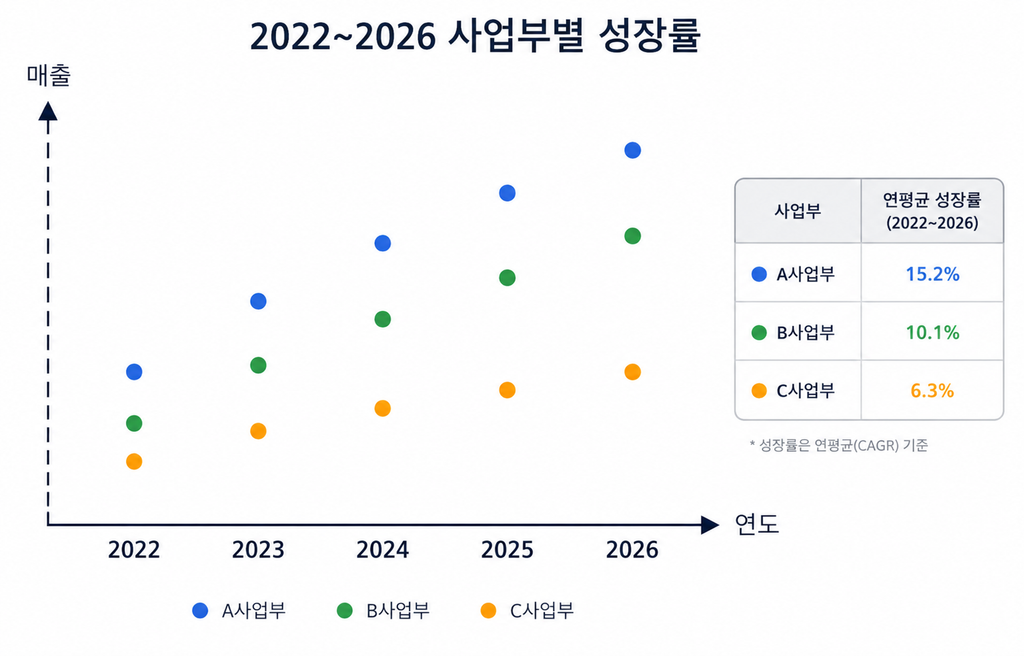
사람은 그래프의 모양 자체에서 정보를 얻는다.
하지만 Text Parser 입장에서는 추출할 텍스트가 거의 없다.
결국 이런 결과가 나올 수도 있다.
2022~2026 사업부별 성장률

매출

2022
2023
2024
2025
2026
그래프가 보여주던 핵심 정보는 사라졌다.
5. 문서는 텍스트 이상의 정보를 가지고 있다
문서를 사람이 볼 때 실제로 사용하는 정보는 훨씬 다양하다.
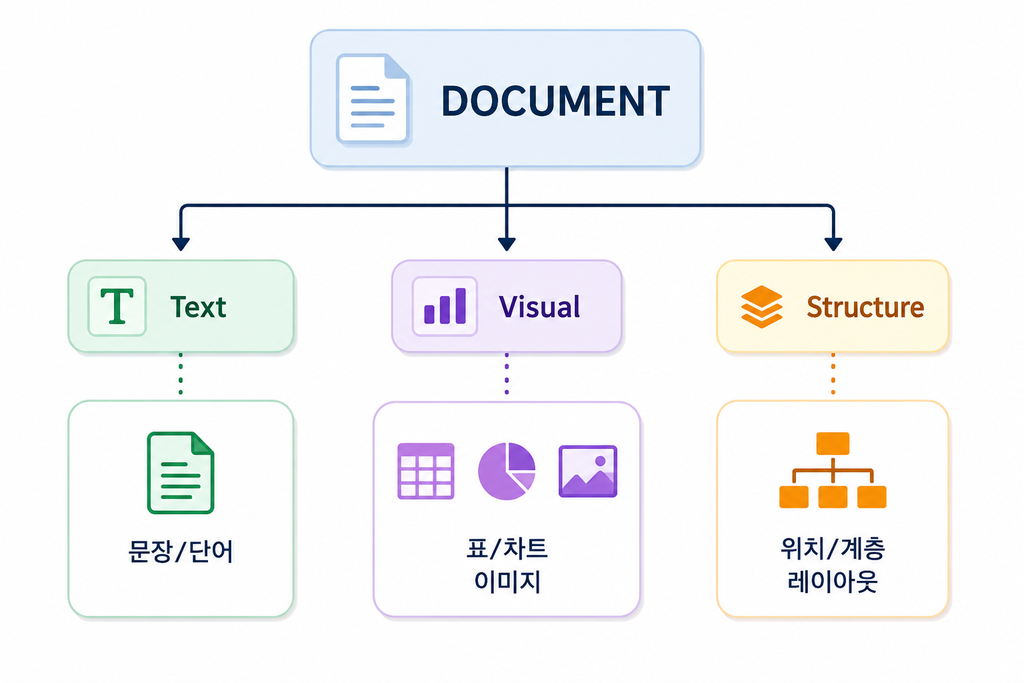
예를 들어
- 제목이 어디에 있는가?
- 표에서 어떤 값이 같은 행에 있는가?
- 그래프에서 어떤 막대가 가장 높은가?
- 이미지 옆의 설명은 무엇인가?
- 어떤 각주가 어떤 표를 설명하는가?
같은 정보는 텍스트만 추출해서는 완전히 보존하기 어렵다.
그래서 이런 질문을 해볼 수 있다.
문서를 굳이 텍스트로 바꾼 다음 검색해야 할까?
6. Pixel RAG의 아이디어
Pixel RAG의 아이디어는 놀랄 만큼 단순하다.
문서를 사람이 보는 모습 그대로 검색해보자는 것이다.
PDF 페이지를 이미지로 변환한다.
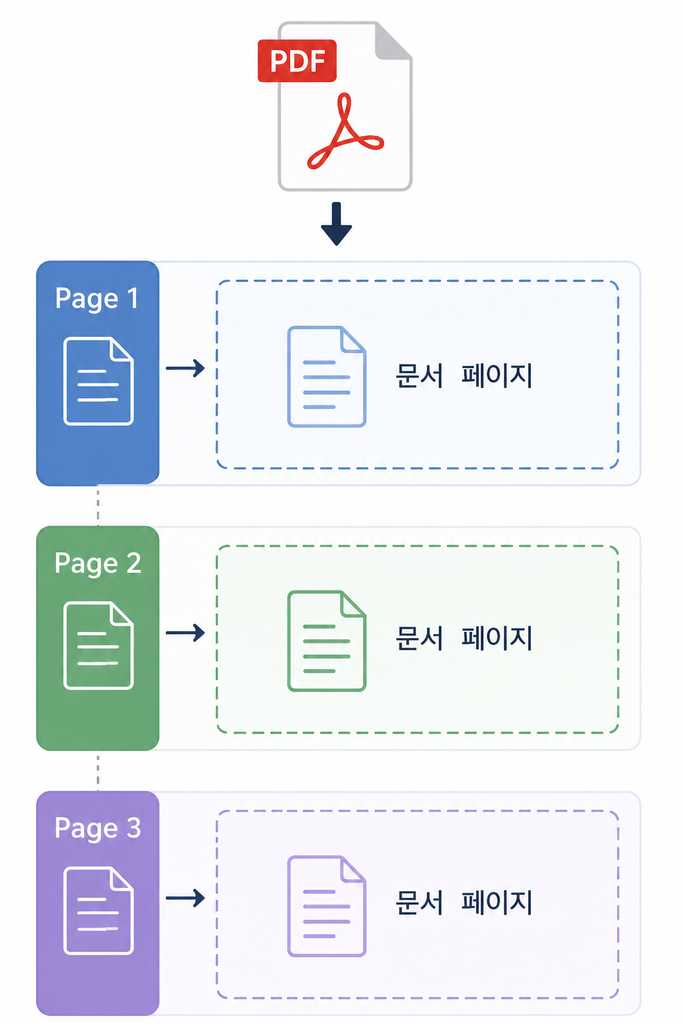
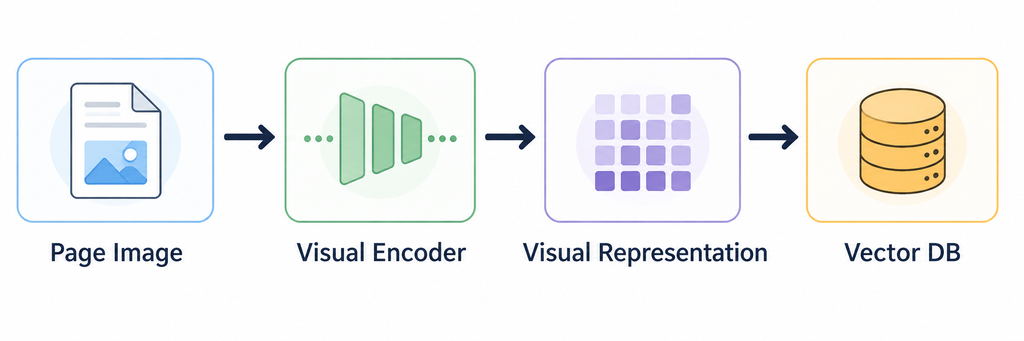
그리고 페이지 이미지 자체를 검색할 수 있는 표현으로 변환한다.
사용자가 질문하면 질문과 관련 있는 페이지를 찾는다.
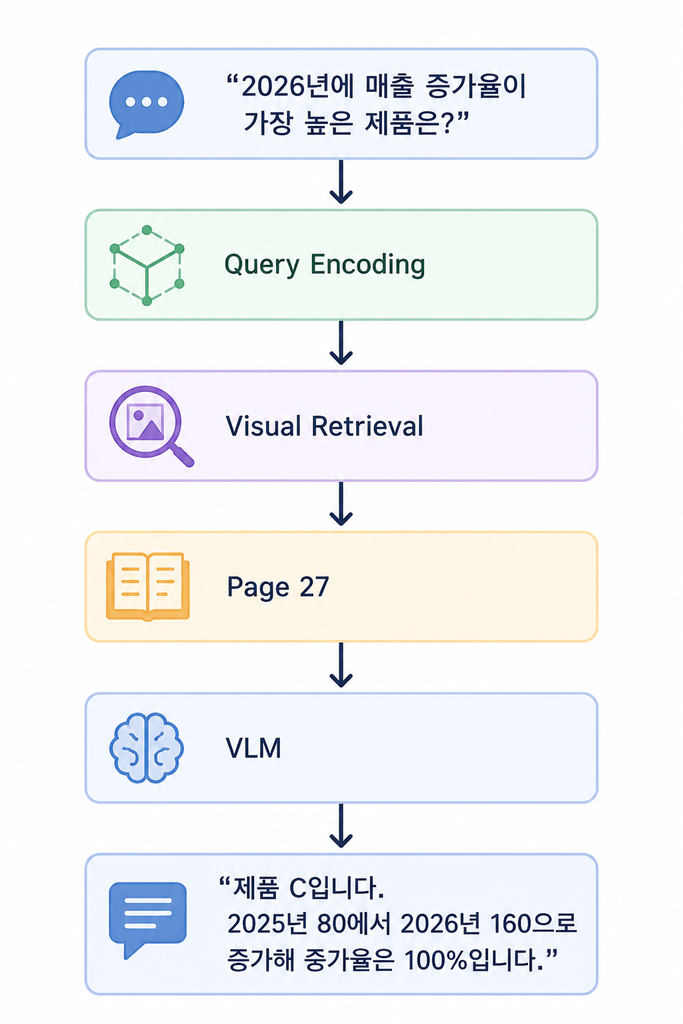
이것이 Pixel RAG를 이해하는 가장 기본적인 그림이다.
7. OCR과 Pixel RAG는 무엇이 다를까?
여기서 자연스럽게 이런 의문이 생긴다.
“그냥 OCR을 잘하면 되는 것 아닌가?”
OCR은 이미지 속 글자를 텍스트로 변환하는 기술이다.
Image
  ↓
OCR
  ↓
Text
예를 들어
[문서 이미지]

"2026년 매출 보고서"
를
2026년 매출 보고서로 바꾼다.
좋은 OCR과 Layout Parser를 사용하면 표와 문서 구조를 상당 부분 복원할 수도 있다.
하지만 결국 목표는 문서를 구조화된 텍스트 또는 데이터로 변환하는 것이다.
Pixel RAG 계열의 Visual Retrieval은 접근 방향이 다르다.
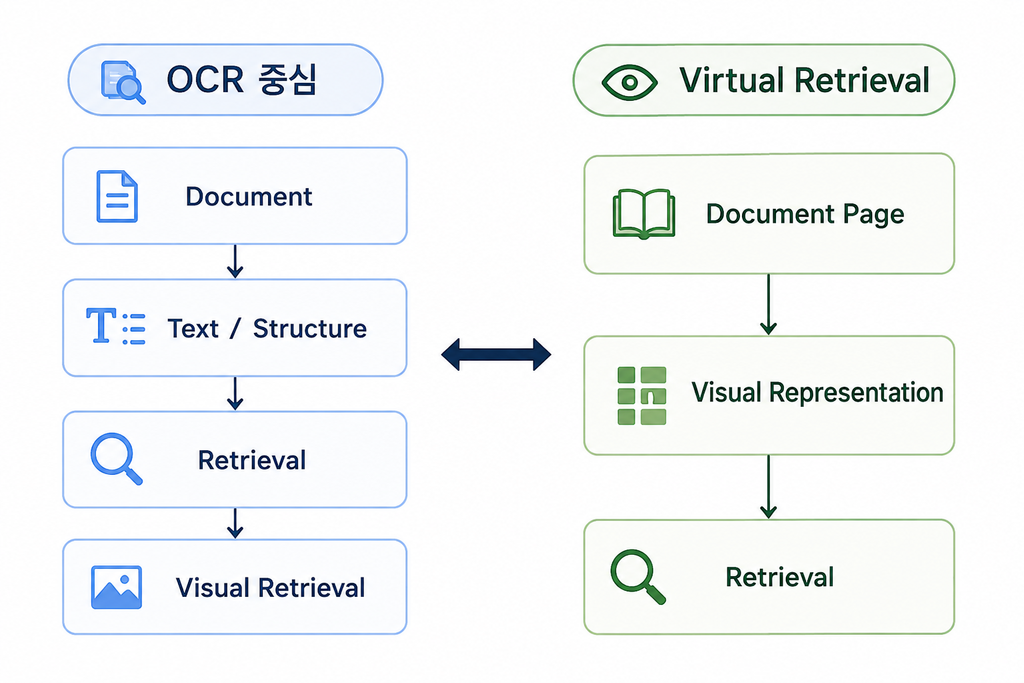
즉 문서를 반드시 텍스트로 완전히 복원한 다음 검색해야 한다는 전제에서 벗어난다.
8. 그렇다고 OCR이 필요 없어지는 것은 아니다
여기서 오해하면 안 되는 부분이 있다.
Pixel RAG가 등장했다고 해서
OCR은 이제 필요 없다.
는 뜻은 아니다.
실제 시스템에서는 오히려 둘을 함께 사용하는 것이 자연스럽다.
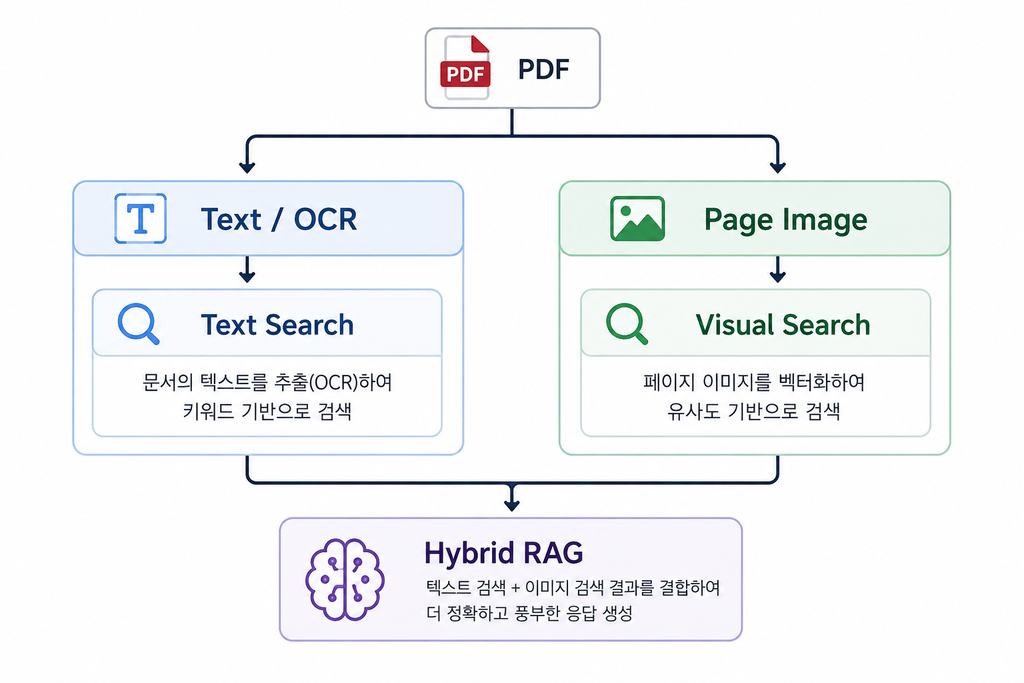
텍스트 검색은 빠르고 저렴하다.
Visual Retrieval은 표, 그래프, 이미지, 레이아웃을 이해하는 데 강점이 있다.
두 방법의 장점을 같이 사용하는 것이다.
9. Pixel RAG가 특히 유용한 문서는?
Pixel RAG가 모든 문서에 필요한 것은 아니다.
예를 들어 TXT 파일이나 Markdown 문서처럼 애초부터 구조가 명확한 텍스트라면 굳이 이미지로 바꿀 이유가 없다.
반대로 다음과 같은 문서에서는 가치가 커진다.
재무 보고서
표와 그래프가 많고 숫자 사이의 관계가 중요하다.
논문
수식, 표, 그림, 그래프, 캡션이 함께 등장한다.
프레젠테이션
텍스트 자체보다 위치와 시각적 관계가 중요한 경우가 많다.
제품 카탈로그
제품 사진과 설명, 가격, 사양표의 관계가 중요하다.
매뉴얼
스크린샷, 다이어그램과 설명이 함께 등장한다.
스캔 문서
애초에 정상적인 Text Layer가 없을 수 있다.
복잡한 PDF
다단 레이아웃이나 표 때문에 Parser가 읽는 순서를 잘못 판단하기 쉽다.
10. Text RAG와 Pixel RAG를 비교하면
차이를 간단히 정리해보자.
| 구분 | Text RAG | Pixel / Visual RAG |
|---|---|---|
| 검색 대상 | Text Chunk | Document Page |
| 입력 | 추출된 텍스트 | 페이지 이미지 |
| Embedding | Text Embedding | Visual Document Representation |
| 표 | Parser 품질에 의존 | 원본 구조 활용 가능 |
| 차트 | 제한적 | 강점 |
| 이미지 | 대부분 손실 | 활용 가능 |
| 레이아웃 | 손실 가능 | 활용 가능 |
| 검색 비용 | 상대적으로 낮음 | 상대적으로 높음 |
| 저장량 | 작음 | 상대적으로 큼 |
| 생성 모델 | LLM | 주로 VLM |
| 적합한 문서 | 텍스트 중심 | 복잡한 시각 문서 |
따라서 둘 중 어느 것이 무조건 더 좋다고 말하기는 어렵다.
문서의 특성이 다르기 때문이다.
11. Pixel RAG는 ‘페이지를 VLM에 전부 보내는 것’이 아니다
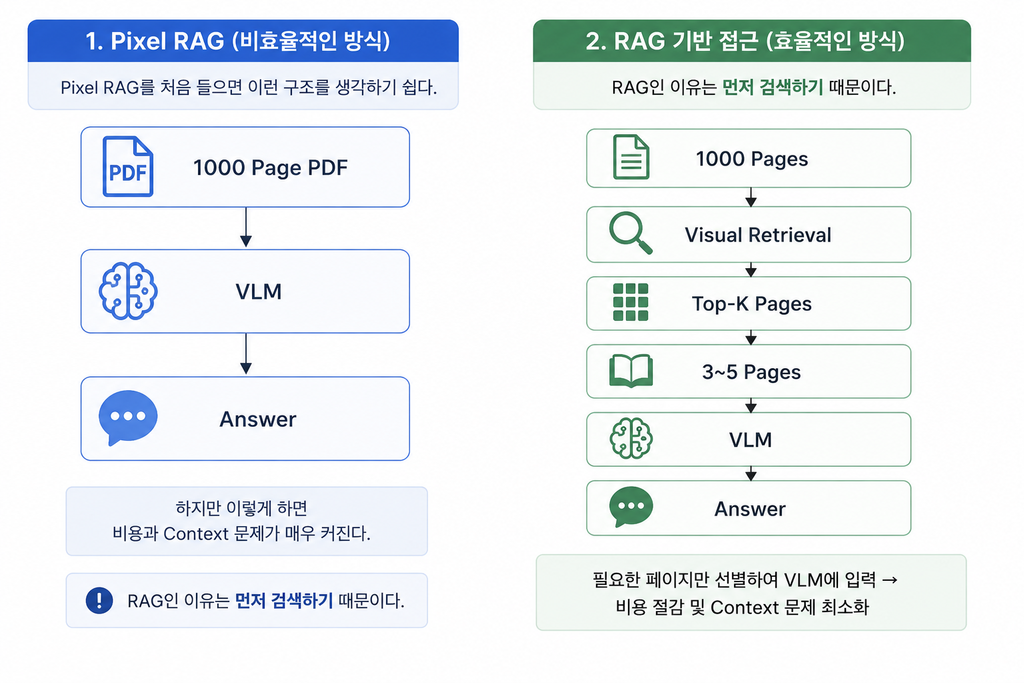
Pixel RAG를 처음 들으면 그림의 1과 같이 “1000 Page PDF -> VLM -> Answer” 이런 구조를 생각하기 쉽다.
하지만 이렇게 하면 비용과 Context 문제가 매우 커진다.
RAG인 이유는 먼저 검색하기 때문이다.
1000 Pages -> Visual Retrieval -> Top-K Pages -> 3~5 Pages ->
VLM -> Answer
즉 Visual Retriever의 역할은
수많은 페이지 중 VLM이 봐야 할 몇 장을 찾아주는 것
이다.
이 관점이 중요하다.
12. 그렇다면 Visual Retrieval은 어떻게 가능할까?
여기서부터 Pixel RAG의 기술적으로 재미있는 부분이 시작된다.
페이지 한 장에는 너무 많은 정보가 들어 있다.
이 페이지 전체를 하나의 Vector로 압축해버리면 세부적인 정보가 손실될 수 있다.
그래서 Visual Document Retrieval에서는 페이지를 여러 Vector로 표현하는 Multi-Vector 방식을 사용할 수 있다.
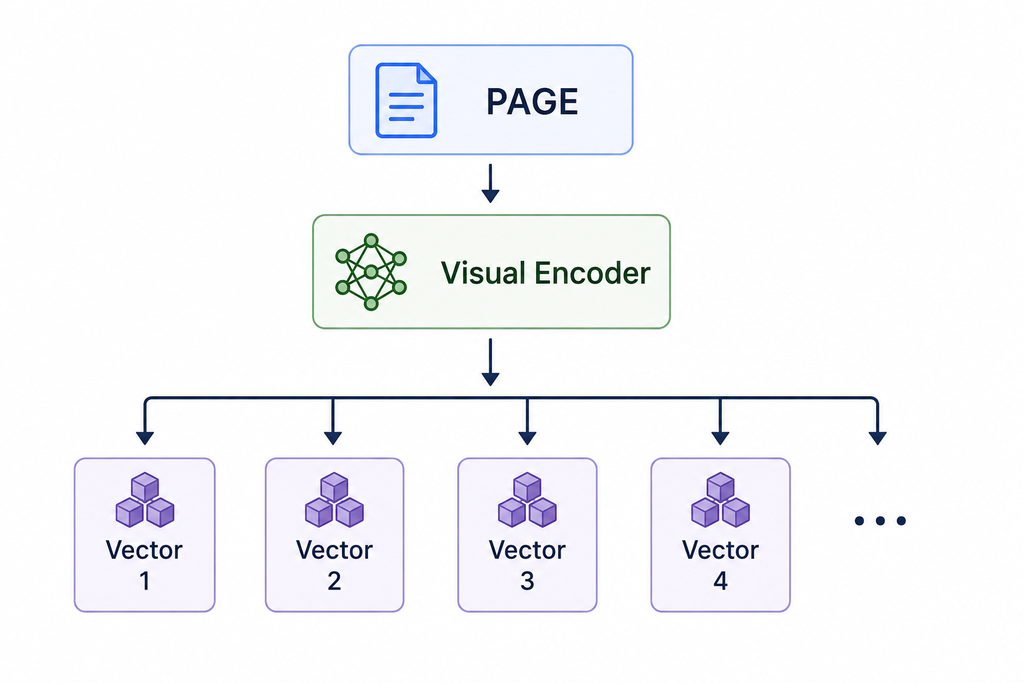
그리고 질문 역시 여러 표현을 가진다.
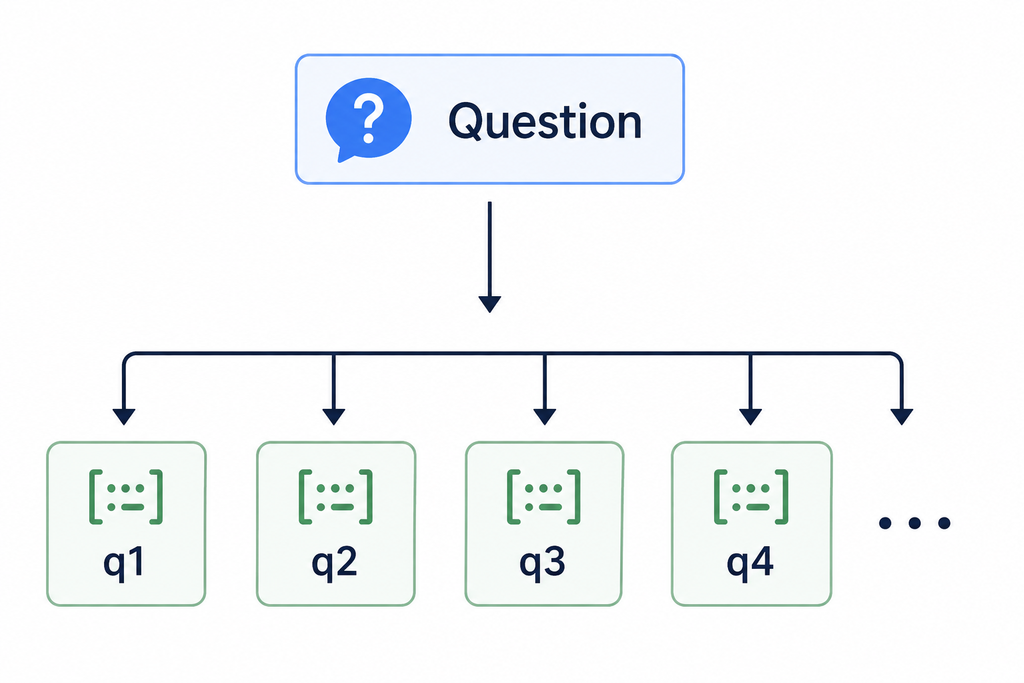
질문의 각 요소와 페이지의 여러 요소를 비교해서 관련성을 계산한다.
이 과정에서 Late Interaction이라는 개념이 등장한다.
그리고 바로 이 분야에서 자주 등장하는 이름이
ColPali, ColQwen 계열의 Visual Document Retrieval 모델이다.
이 부분부터는 조금 기술적인 이야기가 된다.
그래서 다음 편에서 자세히 다룬다.
13. Pixel RAG라는 말을 볼 때 주의할 점
‘Pixel RAG’라는 표현을 너무 엄격한 하나의 표준 기술명으로 받아들일 필요는 없다.
실제로 관련 분야에서는
Visual Document Retrieval
Visual RAG
Multimodal RAG
Vision-based Document Retrieval
Document Image Retrieval
등 여러 표현이 사용된다.
또한 구현 방식도 하나가 아니다.
어떤 시스템은 페이지 이미지를 직접 검색하고,
어떤 시스템은 OCR과 Layout 정보를 함께 사용하고,
어떤 시스템은 Text Retrieval로 먼저 후보 페이지를 찾은 뒤 VLM에게 원본 페이지를 보여준다.
따라서 중요한 것은 이름보다 검색 과정에서 문서의 시각적 표현을 활용한다는 개념이다.
14. RAG의 관점이 바뀌고 있다
기존 RAG의 중요한 질문은 이것이었다.
“문서를 어떻게 잘 Chunking할 것인가?”
그래서 우리는 계속 다음을 고민했다.
Chunk Size는 얼마가 좋은가?

Overlap은 얼마나 줘야 하는가?

Paragraph 단위로 나눌까?

Section 단위로 나눌까?

Semantic Chunking을 사용할까?
그런데 Pixel RAG는 조금 다른 질문을 던진다.
“애초에 모든 지식을 Text Chunk로 바꾸어야 하는가?”
이 질문은 꽤 중요하다.
사람은 문서를 볼 때 Chunk 단위로 읽지 않는다.
페이지를 보고,
표를 보고,
그래프를 보고,
제목과 본문의 관계를 보고,
그림과 설명을 함께 본다.
즉 사람이 이해하는 문서는 본래부터 Multimodal이다.
15. 결국 RAG는 이런 방향으로 확장되고 있다
초기의 RAG를 단순화하면 다음과 같았다.
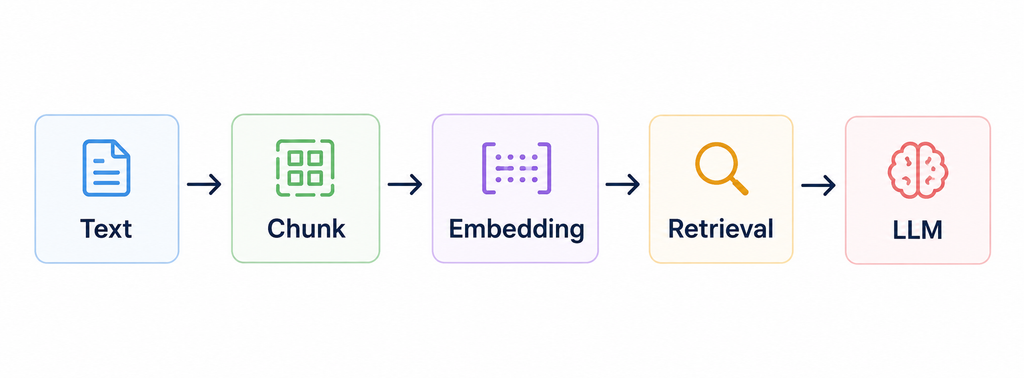
이후 Keyword Search와 Vector Search를 결합한 Hybrid Search가 등장하고, Reranker가 적극적으로 사용되기 시작했다.
그리고 이제 검색 대상 자체가 확장되고 있다.
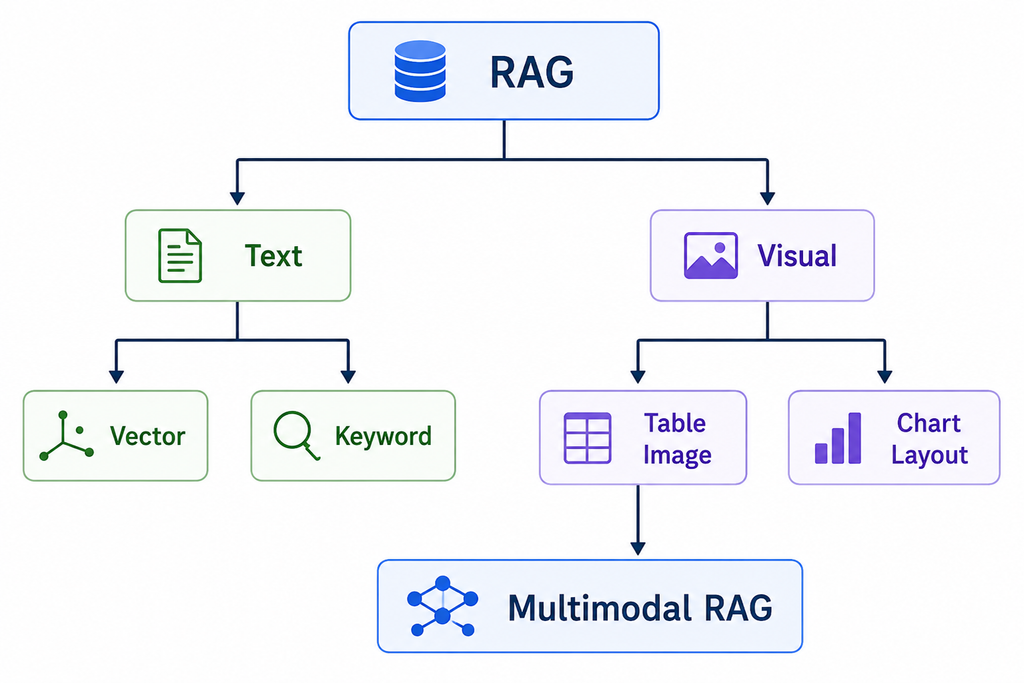
RAG가 단순한 Text Retrieval 시스템에서 Document Understanding 시스템으로 확장되는 과정이라고 볼 수도 있다.
마치며
Pixel RAG를 처음 접하면 기존 RAG와 완전히 다른 기술처럼 느껴질 수 있다.
하지만 핵심 아이디어는 의외로 간단하다.
기존 RAG는 문서를 먼저 텍스트로 변환하고 그 텍스트를 검색했다.
기존 Text RAG

Document
   ↓
Text Parsing
   ↓
Chunk
   ↓
Embedding
   ↓
Retrieval
   ↓
LLM
Pixel RAG 또는 Visual Document Retrieval은 여기에 새로운 길을 추가한다.
Pixel / Visual RAG

Document
   ↓
Page Image
   ↓
Visual Representation
   ↓
Visual Retrieval
   ↓
VLM
그리고 실제 시스템에서는 둘 중 하나만 선택해야 하는 것도 아니다.
오히려 다음과 같은 구조가 자연스럽다.
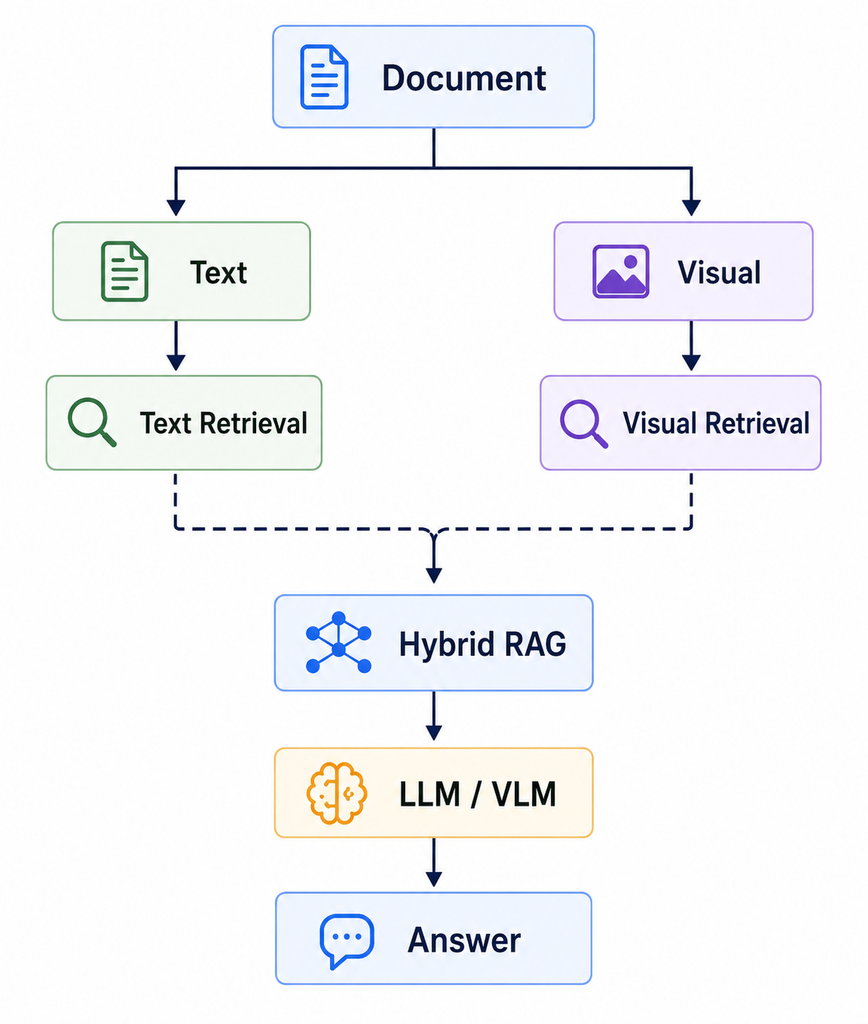
텍스트로 충분히 표현할 수 있는 정보는 Text RAG가 처리한다.
표, 차트, 이미지, 복잡한 레이아웃처럼 텍스트 변환 과정에서 의미가 손실될 수 있는 정보는 Visual Retrieval이 보완한다.
그래서 Pixel RAG의 핵심을 한 문장으로 정리하면 다음과 같다.
문서를 텍스트로 변환한 결과만 검색하지 말고, 사람이 보는 문서의 모습 자체도 검색 대상으로 사용하자.
Pixel RAG가 흥미로운 진짜 이유
개인적으로 Pixel RAG에서 가장 흥미로운 부분은 단순히 검색 정확도가 좋아질 수 있다는 점만은 아니다.
RAG 시스템에서 ’문서란 무엇인가?’라는 관점 자체가 달라진다는 것이다.
기존에는 사실상 이렇게 생각했다.
Document ≒ Text하지만 실제 문서는 그렇지 않다.
Document

 ├── Text
 ├── Table
 ├── Chart
 ├── Image
 ├── Diagram
 ├── Layout
 ├── Position
 └── Visual Relationship
예를 들어 표에서는 숫자 자체보다 어느 행과 어느 열에 있는가가 중요할 수 있다.
그래프에서는 글자보다 막대의 높이나 선의 변화가 중요한 정보일 수 있다.
제품 카탈로그에서는 제품 사진과 옆에 위치한 설명의 관계가 중요할 수 있다.
사람은 이런 정보를 자연스럽게 함께 본다.
하지만 기존 Text RAG는 문서를 텍스트로 변환하는 순간 그중 일부를 포기해야 했다.
Pixel RAG는 그 손실을 줄이려는 접근이라고 볼 수 있다.
그렇다면 기존 RAG를 Pixel RAG로 바꿔야 할까?
그럴 필요는 없다.
오히려 기존 RAG 시스템을 운영하고 있다면 Text RAG를 그대로 유지하는 것이 좋다.
Text Retrieval은 여전히 빠르고 저렴하며 강력하다.
대신 기존 시스템에 새로운 검색 경로를 하나 추가하는 것이다.
기존 시스템

Text RAG
   │
   ▼
Answer


확장된 시스템

        ┌── Text RAG ────┐
Question│                ├── Answer
        └── Pixel RAG ───┘
그리고 질문이나 문서의 특성에 따라 적절한 Retrieval을 선택할 수 있다.
"휴가 규정은?"
      ↓
Text RAG


"이 표에서 매출이 가장 높은 제품은?"
      ↓
Pixel RAG


"보고서 내용을 분석하고
 차트까지 고려해서 설명해줘."
      ↓
Hybrid RAG
이렇게 보면 Pixel RAG는 기존 RAG의 경쟁자라기보다는 확장 기능에 가깝다.
1부 핵심 정리
이번 글의 내용을 다섯 가지로 정리해보자.
첫째. 기존 RAG는 대부분 원본 문서를 직접 검색하지 않는다.
문서에서 추출한 Text Chunk를 검색한다.
둘째. 문서를 텍스트로 변환하는 과정에서 정보가 손실될 수 있다.
특히 표, 차트, 이미지, 다이어그램, 레이아웃에서 문제가 발생한다.
셋째. Pixel RAG는 페이지의 시각적 표현을 검색에 활용한다.
문서를 사람이 보는 형태에 더 가까운 상태로 다룬다.
넷째. Pixel RAG가 OCR이나 Text RAG를 없애는 것은 아니다.
실제 시스템에서는 Text Retrieval과 Visual Retrieval을 함께 사용하는 Hybrid 구조가 유용하다.
다섯째. Pixel RAG의 중요한 변화는 검색 기술 하나가 아니다.
RAG의 검색 대상을 Text Chunk 에서 Document 자체로 확장하려는 시도라는 점이다.
다음 글
Pixel RAG 2부 — 기존 RAG 시스템에 Pixel RAG를 붙이면 무엇이 달라질까?
개념을 이해했다면 다음 질문은 자연스럽다.
“이미 만들어 놓은 RAG 시스템에 Pixel RAG를 어떻게 추가하지?”
2부에서는 실제 시스템 아키텍처 관점에서 살펴본다.
기존의
Document
   ↓
Parser
   ↓
Chunking
   ↓
Embedding
   ↓
Vector DB
파이프라인이 Pixel RAG를 추가하면서 어떻게
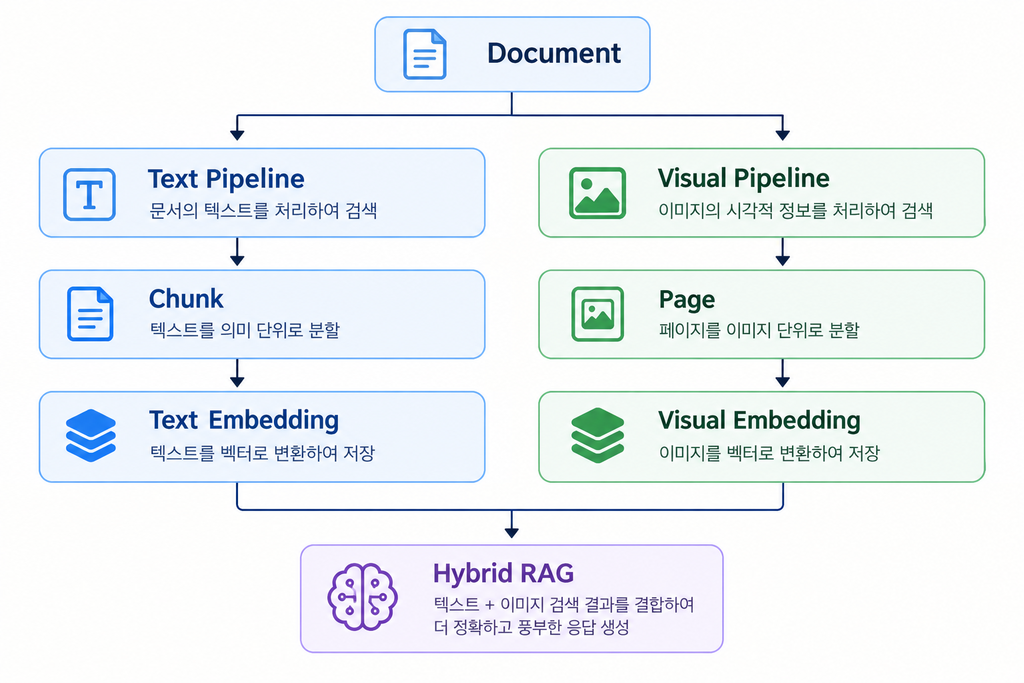
구조로 확장되는지 살펴본다.
또한 다음 문제들도 다룬다.
- Chunk와 Page의 관계를 어떻게 저장할 것인가?
- 페이지 이미지는 어디에 저장할 것인가?
- Vector DB를 분리해야 하는가?
- 모든 질문에 Visual Search를 해야 하는가?
- Text와 Visual 검색 결과는 어떻게 합칠 것인가?
- VLM에는 어떤 페이지를 전달해야 하는가?
- Pixel RAG 때문에 증가하는 비용은 어떻게 줄일 것인가?
- 기존 RAG에 가장 적은 변경으로 도입하려면 어디서부터 시작해야 하는가?
2부부터는 본격적으로 Pixel RAG의 시스템 구조를 뜯어보자.