FastAPI로 API 서버를 개발하다 보면 처음에는 대부분의 요청을 API 서버 안에서 처리하게 된다.
예를 들어 일반적인 조회 API라면 구조는 매우 단순하다.
Client
   │
   ▼
FastAPI
   │
   ▼
Database
   │
   ▼
Response
데이터베이스에서 데이터를 조회하고 약간의 비즈니스 로직을 수행한 뒤 결과를 반환한다.
이런 요청은 대부분 수십 ms에서 수백 ms 정도면 끝난다.
그런데 최근 RAG나 LLM 기반 서비스를 개발하다 보면 조금 다른 종류의 API를 만나게 된다.
바로 Long Task다.
1. FastAPI는 빠른데 AI 작업은 느리다
RAG 서비스를 예로 들어보자.
사용자가 질문 하나를 입력했다고 해서 바로 LLM을 호출하고 끝나는 것은 아니다.
보통 다음과 같은 과정이 필요하다.
 사용자 질문
     │
     ▼
Query Embedding
     │
     ▼
Vector Search
     │
     ▼
Reranking
     │
     ▼
Prompt 구성
     │
     ▼
LLM 호출
     │
     ▼
 답변 생성
각각의 작업에는 시간이 걸린다.
Embedding API를 호출해야 할 수도 있고 Vector DB를 검색해야 할 수도 있다. 검색된 문서를 Reranker에 다시 보내야 할 수도 있으며 마지막에는 LLM이 답변을 생성할 때까지 기다려야 한다.
전체 작업에 5초가 걸릴 수도 있고 10초, 경우에 따라서는 수십 초가 걸릴 수도 있다.
여기서 한 가지 고민이 생긴다.
FastAPI가 이 작업을 전부 수행하고 끝날 때까지 요청을 붙잡고 있어야 할까?
물론 기술적으로는 가능하다.
FastAPI는 비동기 처리를 지원하기 때문에 외부 LLM API나 Vector DB의 응답을 기다리는 동안 다른 요청을 처리할 수도 있다.
@app.post("/rag")
async def rag(request: RagRequest):

    embedding = await embedding_api(request.question)

    documents = await vector_search(embedding)

    answer = await llm_api(
        question=request.question,
        documents=documents
    )

    return {
        "answer": answer
    }
코드만 보면 아무 문제가 없어 보인다.
실제로 트래픽이 많지 않고 작업 시간이 짧다면 이런 구조도 충분히 사용할 수 있다.
하지만 서비스 규모가 커지기 시작하면 이야기가 달라진다.
2. async라고 해서 Long Task 문제가 모두 해결되는 것은 아니다
여기서 흔히 생기는 오해가 하나 있다.
FastAPI가 async를 지원하니까 오래 걸리는 작업도 그냥 async로 실행하면 되는 것 아닌가?
async는 매우 유용하다.
특히 다음과 같이 I/O 대기가 많은 작업에서 효과적이다.
Database
HTTP API
LLM API
Vector DB
Redis
S3
한 요청이 외부 API 응답을 기다리는 동안 Event Loop는 다른 요청을 처리할 수 있다.
하지만 비동기 처리와 작업 분리는 서로 다른 문제다.
예를 들어 동시에 1,000개의 RAG 요청이 들어왔다고 생각해보자.
Request 1   ─── RAG ─── LLM ───
Request 2   ─── RAG ─── LLM ───
Request 3   ─── RAG ─── LLM ───
...
Request 1000 ── RAG ─── LLM ───
각 작업이 대부분 I/O라고 해도 FastAPI 프로세스는 여전히 이 작업들의 상태를 관리해야 한다.
여기에 다음과 같은 문제들이 추가될 수 있다.
- 외부 LLM API의 Rate Limit
- Embedding API 호출 제한
- Vector DB Connection 증가
- 메모리 사용량 증가
- 요청 Timeout
- Worker 프로세스 장애
- 작업 재시도
- 특정 작업의 비정상적인 장시간 실행
특히 RAG 파이프라인이 복잡해지면 API 서버가 담당해야 하는 책임이 지나치게 많아진다.
그래서 시스템의 역할을 나눠볼 수 있다.
3. API 서버와 Worker를 분리해보자
FastAPI에게 모든 일을 시키는 대신 역할을 다음과 같이 나눈다.
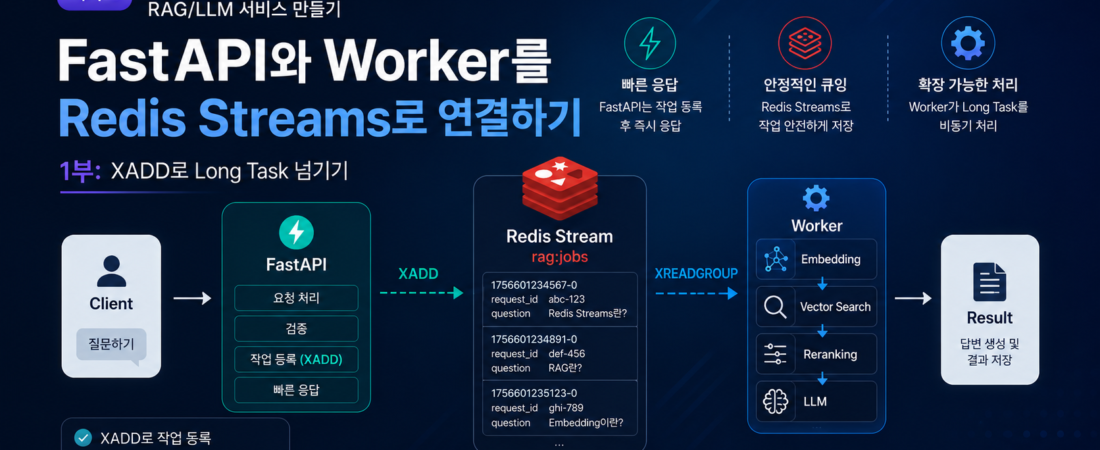
FastAPI

- HTTP 요청 처리
- 인증
- 입력값 검증
- 작업 등록
- 빠른 응답
그리고 실제 시간이 오래 걸리는 작업은 별도의 Worker가 담당한다.
Worker

- Embedding
- Vector Search
- Reranking
- LLM 호출
- 결과 저장
전체 구조는 이렇게 된다.
 Client
      │
      ▼
┌──────────────┐
│   FastAPI    │
└──────┬───────┘
       │
       │ 작업 등록
       ▼
┌──────────────┐
│    Queue     │
└──────┬───────┘
       │
       ▼
┌──────────────┐
│    Worker    │
├──────────────┤
│ Embedding    │
│ Vector Search│
│ Reranking    │
│ LLM          │
└──────────────┘
이제 FastAPI는 RAG 작업을 직접 실행하지 않는다.
대신 이런 요청이 들어왔다고 Queue에 작업을 등록한다.
그리고 Worker가 Queue에서 작업을 가져가 처리한다.
FastAPI와 Worker의 역할이 명확하게 분리된 것이다.
4. 그런데 FastAPI와 Worker는 어떻게 통신할까?
여기서 새로운 문제가 하나 생긴다.
FastAPI와 Worker가 서로 다른 프로세스라면 데이터를 어떻게 전달해야 할까?
가장 단순하게 생각하면 Database를 사용할 수도 있다.
FastAPI
   │
   ▼
Database
   │
   ▼
Worker
FastAPI가 job 테이블에 작업을 INSERT하고 Worker가 주기적으로 SELECT하는 방법이다.
실제로 이런 방식도 사용할 수 있다.
하지만 Worker가 계속 Database를 조회해야 한다.
SELECT ...
   ↓
작업 없음

1초 대기

SELECT ...
   ↓
작업 없음

1초 대기

SELECT ...
전형적인 Polling 구조가 된다.
그렇다면 메시지 전달에 특화된 Queue를 사용하는 방법을 생각해볼 수 있다.
RabbitMQ나 Kafka 같은 별도의 메시징 시스템을 도입할 수도 있다.
하지만 이미 서비스에서 Redis를 사용하고 있다면 Redis를 활용하는 방법도 있다.
바로 Redis Streams다.
5. Redis는 Cache만 있는 것이 아니다
Redis라고 하면 보통 가장 먼저 떠오르는 것이 Cache다.
Key → Value예를 들어:
user:1001 → {"name":"Simon"}TTL을 설정해 세션이나 캐시 데이터를 저장하는 용도로 많이 사용한다.
하지만 Redis에는 이외에도 여러 가지 데이터 구조가 존재한다.
String
Hash
List
Set
Sorted Set
Stream
그중 Stream은 메시지를 시간 순서대로 저장하고 처리할 수 있도록 만들어진 데이터 구조다.
개념적으로 다음과 같이 생각할 수 있다.
Redis Stream

──────────────────────────────────────→

Message 1
Message 2
Message 3
Message 4
Message 5
...
각 메시지에는 고유한 ID가 있고 여러 개의 Field와 Value를 저장할 수 있다.
이 특징을 이용하면 FastAPI와 Worker 사이의 작업 Queue를 만들 수 있다.
6. Redis Stream에 메시지를 넣는 XADD
Redis Stream에 새로운 메시지를 추가할 때 사용하는 명령이 바로 XADD다.
가장 간단한 형태는 다음과 같다.
XADD rag:jobs * request_id 123 question "Redis Streams란?"하나씩 살펴보자.
rag:jobs는 Stream의 이름이다.
rag:jobsRAG 작업을 저장하는 Stream이라고 생각하면 된다.
그다음 *가 있다.
*Stream의 각 메시지에는 고유한 ID가 필요한데 *를 사용하면 Redis가 자동으로 ID를 생성한다.
그리고 그 뒤에는 메시지에 저장할 데이터가 온다.
request_id 123

question "Redis Streams란?"
즉 전체 메시지는 개념적으로 다음과 같다.
Stream

rag:jobs

    Message
       │
       ├── request_id = 123
       │
       └── question = "Redis Streams란?"
Redis가 메시지를 저장하면 다음과 비슷한 ID가 생성된다.
1756601234567-0결과적으로 Stream은 다음과 같은 모습이 된다.
rag:jobs

1756601234567-0
    request_id = 123
    question   = Redis Streams란?

1756601234891-0
    request_id = 124
    question   = RAG란?

1756601235123-0
    request_id = 125
    question   = Embedding이란?
Redis Stream은 이렇게 메시지를 계속 뒤에 추가한다.
그래서 명령어 이름도:
X + ADD즉 Stream에 새로운 Entry를 추가하는 명령이다.
7. FastAPI에서 XADD를 사용해보자
Python에서는 redis 라이브러리를 이용해 Redis Streams를 사용할 수 있다.
비동기 FastAPI 서버라면 redis.asyncio를 사용할 수 있다.
import redis.asyncio as redis

redis_client = redis.Redis(
    host="localhost",
    port=6379,
    decode_responses=True
)
그리고 작업을 등록하는 함수를 하나 만든다.
import uuid

async def enqueue_rag(question: str):

    request_id = str(uuid.uuid4())

    message_id = await redis_client.xadd(
        "rag:jobs",
        {
            "request_id": request_id,
            "question": question
        }
    )

    return request_id, message_id
여기서 핵심은 이 부분이다.
await redis_client.xadd(...)Redis 명령으로 보면 사실상 다음과 같다.
XADD rag:jobs *
    request_id ...
    question ...
FastAPI Endpoint에서 이 함수를 호출해보자.
from fastapi import FastAPI
from pydantic import BaseModel

app = FastAPI()


class RagRequest(BaseModel):
    question: str


@app.post("/rag")
async def rag(request: RagRequest):

    request_id, message_id = await enqueue_rag(
        request.question
    )

    return {
        "request_id": request_id,
        "message_id": message_id,
        "status": "queued"
    }
사용자가 다음 질문을 보냈다고 하자.
{
    "question": "Redis Streams란 무엇인가?"
}
FastAPI는 LLM을 호출하지 않는다.
Embedding도 하지 않는다.
Vector Search도 하지 않는다.
단지 Redis Stream에 작업 하나를 등록한다.
FastAPI
   │
   │ XADD
   ▼
Redis Stream
그리고 바로 다음과 같은 응답을 반환할 수 있다.
{
    "request_id": "550e8400-e29b-41d4-a716-446655440000",
    "message_id": "1756601234567-0",
    "status": "queued"
}
Long Task를 FastAPI 요청 처리 영역 밖으로 밀어낸 것이다.
8. request_id와 Redis message_id는 왜 따로 둘까?
여기에서 한 가지 짚고 넘어갈 부분이 있다.
Redis가 이미 이런 Message ID를 만들어주는데:
1756601234567-0왜 별도로 UUID 기반 request_id를 만들었을까?
두 ID의 역할을 분리하기 위해서다.
request_id
    │
    └── 애플리케이션의 작업 ID

message_id
    │
    └── Redis Stream 내부 메시지 ID
예를 들어 나중에 RAG 결과를 Database에 저장한다고 해보자.
rag_jobs

request_id
status
question
answer
created_at
completed_at
애플리케이션은 request_id를 기준으로 작업을 추적할 수 있다.
반면 Redis의 Message ID는 Stream에서 메시지를 읽고 관리하는 데 사용할 수 있다.
즉 Redis 내부의 메시지 식별자와 비즈니스 영역의 작업 식별자를 분리하는 것이다.
실제 시스템에서는 이런 분리가 나중에 꽤 유용해진다.
9. 이제 FastAPI는 RAG 작업을 기다리지 않는다
구조를 다시 보면 처음에는 이랬다.
 Client
   │
   ▼
FastAPI
   │
   ▼
Embedding
   │
   ▼
Vector Search
   │
   ▼
Reranking
   │
   ▼
  LLM
   │
   ▼
Response
FastAPI 요청 하나가 전체 RAG Pipeline과 연결되어 있었다.
이제 구조를 바꿨다.
 Client
           │
           │ POST /rag
           ▼
    ┌──────────────┐
    │   FastAPI    │
    └──────┬───────┘
           │
           │ XADD
           ▼
┌──────────────────────┐
│ Redis Stream         │
│                      │
│ rag:jobs             │
│                      │
│ 1756601234567-0      │
│ 1756601234891-0      │
│ 1756601235123-0      │
└──────────┬───────────┘
           │
           ▼
       RAG Worker
FastAPI의 역할은 상당히 단순해졌다.
요청 받기
   ↓
검증
   ↓
request_id 생성
   ↓
XADD
   ↓
응답
반면 무거운 작업은 Worker 영역으로 이동한다.
Worker

Embedding
   ↓
Vector Search
   ↓
Reranking
   ↓
  LLM
   ↓
Result 저장
이렇게 API 서버와 AI 작업 실행 영역을 분리하면 둘을 독립적으로 확장하기도 쉬워진다.
예를 들어 API 요청이 많다면 FastAPI 인스턴스를 늘릴 수 있다.
FastAPI
FastAPI
FastAPI
RAG 처리량이 부족하다면 Worker를 늘릴 수 있다.
Worker 1
Worker 2
Worker 3
Worker 4
API 서버와 Worker의 Scaling 전략을 서로 다르게 가져갈 수 있는 것이다.
10. 그런데 아직 중요한 문제가 하나 남았다
FastAPI가 Redis Stream에 작업을 넣는 데까지는 성공했다.
FastAPI
   │
   │ XADD
   ▼
Redis Stream

Message 1
Message 2
Message 3
Message 4
...
그런데 아직 Worker 코드는 없다.
Worker는 Redis에 새로운 작업이 들어왔다는 것을 어떻게 알 수 있을까?
단순하게 생각하면 Stream을 계속 조회하면 된다.
Redis에는 Stream의 메시지를 읽는 명령도 있다.
XREAD하지만 Worker가 여러 개라면 문제가 조금 복잡해진다.
예를 들어 Worker가 세 개 있다고 하자.
 Redis Stream
                  │
        ┌─────────┼─────────┐
        ▼         ▼         ▼
     Worker 1  Worker 2  Worker 3
어떤 Worker가 어떤 메시지를 처리해야 할까?
Worker 1이 처리한 메시지를 Worker 2가 또 처리하면 어떻게 될까?
Worker가 메시지를 가져간 뒤 LLM을 호출하다가 죽어버리면 그 작업은 어떻게 해야 할까?
처리가 완료되었다는 것은 Redis에게 어떻게 알려줄까?
여기서 Redis Streams의 중요한 기능이 등장한다.
바로 Consumer Group이다.
그리고 다음과 같은 명령들이 등장한다.
XGROUP

XREADGROUP

XACK

XPENDING
이 기능들을 사용하면 Redis Stream을 단순한 메시지 저장소가 아니라 여러 Worker가 작업을 나눠 처리하는 Queue처럼 사용할 수 있다.
마치며
FastAPI가 async를 지원한다고 해서 모든 Long Task를 API 프로세스 안에서 처리해야 하는 것은 아니다.
특히 RAG나 LLM처럼 여러 외부 시스템을 호출하고 처리 시간이 길어질 수 있는 작업에서는 비동기 처리와 작업 분리를 별개의 문제로 생각할 필요가 있다.
이번 글에서는 FastAPI의 역할을 HTTP 요청 처리와 작업 등록으로 제한하고 실제 RAG 처리는 Worker에게 넘기는 구조를 살펴봤다.
그리고 FastAPI와 Worker 사이에서 작업을 전달하기 위한 방법으로 Redis Streams를 사용했다.
그 출발점이 바로 다음 한 줄이다.
XADD rag:jobs * ...단순한 명령이지만 시스템 구조에서는 중요한 경계가 된다.
HTTP Request
      │
      ▼
   FastAPI
      │
      │ XADD
      ▼
Redis Stream
      │
      ▼
    Worker
FastAPI는 “이 작업을 해줘”라고 메시지를 남기고 자신의 일을 끝낸다.
Worker는 그 메시지를 가져가 실제 작업을 수행한다.
하지만 이제 더 중요한 문제가 남는다.
Worker는 Redis Stream에 쌓인 메시지를 어떻게 안전하게 가져가고, 여러 Worker가 있다면 어떻게 작업을 나누며, 처리 중 Worker가 죽었을 때는 그 작업을 어떻게 복구할 것인가?
단순히 메시지를 읽는 것만으로는 실제 운영 환경에서 충분하지 않다.
예를 들어 다음과 같이 Worker가 세 개 있다고 해보자.
 Redis Stream
                    rag:jobs
                       │
              ┌────────┼────────┐
              │        │        │
              ▼        ▼        ▼
          Worker-1  Worker-2  Worker-3
우리가 원하는 것은 단순하다.
Job 1 → Worker-1
Job 2 → Worker-2
Job 3 → Worker-3
Job 4 → 비어 있는 Worker
...
그런데 여기에는 생각보다 많은 문제가 숨어 있다.
Worker-1이 Job 1을 가져간 뒤 LLM API를 호출하던 중 프로세스가 죽으면 어떻게 해야 할까?
Redis 입장에서는 Worker-1이 작업을 성공적으로 완료했는지 알 수 있을까?
Worker-2가 실수로 Job 1을 다시 가져가면 같은 질문에 대해 LLM을 두 번 호출하게 되는 것은 아닐까?
반대로 아무 Worker도 Job 1을 다시 가져가지 않는다면 작업이 영원히 사라지는 것은 아닐까?
이런 문제를 해결하기 위해 Redis Streams에는 Consumer Group이라는 기능이 있다.
Consumer Group을 사용하면 여러 Worker가 하나의 Stream을 함께 소비하면서 메시지를 나누어 처리할 수 있다.
 Redis Stream
                       rag:jobs
                          │
                          ▼
                  Consumer Group
                    rag-workers
                          │
             ┌────────────┼────────────┐
             ▼            ▼            ▼
         Worker-1      Worker-2      Worker-3
그리고 메시지를 가져가는 것에서 끝나는 것이 아니라,
메시지 수신
    │
    ▼
처리 중(Pending)
    │
    ▼
RAG 실행
    │
    ▼
처리 완료
    │
    ▼
   ACK
라는 상태를 관리할 수 있다.
여기서 등장하는 핵심 명령이 다음과 같다.
XGROUP
XREADGROUP
XACK
XPENDING
그리고 Worker 장애 시 다른 Consumer가 오래된 Pending 작업을 가져오기 위해 XAUTOCLAIM 같은 명령도 활용할 수 있다.
이때부터 Redis Stream은 단순히 메시지가 차곡차곡 쌓이는 저장 공간을 넘어 Worker 작업 분배와 처리 상태를 관리하는 Queue로 활용될 수 있다.
이번 1부에서는 FastAPI가 Long Task를 직접 수행하지 않고 Redis Stream에 작업을 등록하는 부분까지 살펴봤다.
핵심 구조는 이것 하나로 정리할 수 있다.
FastAPI
   │
   │ XADD
   ▼
Redis Stream
   │
   │ ?
   ▼
Worker
이제 ? 부분을 채워야 한다.
이번 1부에서 소개된 Redis 명령어는 다음과 같다. 기억해두자
- XADD — Stream에 새로운 메시지를 추가한다. FastAPI가 Worker에게 작업을 전달할 때 사용한다.
- XREAD — Stream에 저장된 메시지를 읽는다.
- XGROUP — 여러 Worker가 작업을 나눠 처리할 수 있도록 Consumer Group을 생성·관리한다.
- XREADGROUP — Consumer Group에 속한 Worker가 메시지를 가져온다.
- XACK — Worker가 메시지 처리를 완료했음을 Redis에 알린다.
- XPENDING — Worker가 가져갔지만 아직 XACK하지 않은 메시지를 조회한다.
- XAUTOCLAIM — 일정 시간 처리되지 않은 Pending 메시지를 다른 Worker가 넘겨받아 처리할 수 있게 한다.
2부에서는 Consumer Group과 XREADGROUP을 이용해 여러 Worker가 Redis Stream의 작업을 실제로 나누어 처리하는 방법을 살펴본다.