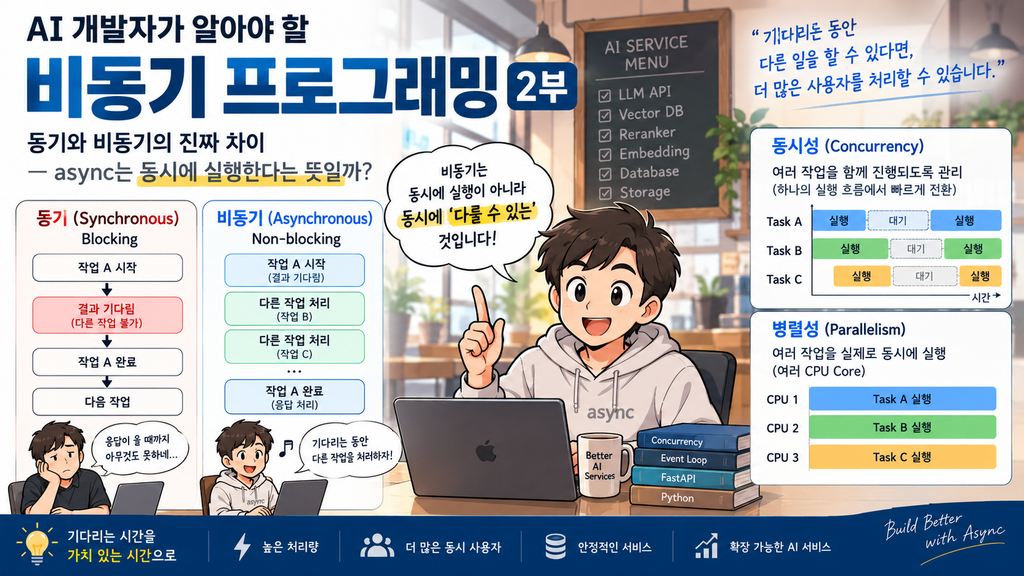
동기와 비동기의 진짜 차이 — async는 동시에 실행한다는 뜻일까?
1부에서는 AI 서비스를 개발할 때 왜 비동기 프로그래밍에 대한 이해가 중요한지 살펴봤다.
특히 FastAPI API Server가 하는 일을 보면 CPU로 직접 계산하는 시간보다 다른 시스템의 응답을 기다리는 시간이 상당히 많다는 이야기를 했다.
예를 들어 RAG 서비스 하나만 보더라도 다음과 같은 작업이 반복된다.
FastAPI API Server
        │
        ├──→ Embedding API ─── 기다림
        ├──→ Vector DB ─────── 기다림
        ├──→ Reranker API ──── 기다림
        ├──→ LLM API ───────── 기다림
        ├──→ RDB ───────────── 기다림
        └──→ Redis ─────────── 기다림
그리고 비동기의 핵심 아이디어를 아주 간단하게 정리했다.
기다리는 동안 다른 일을 하자.
그런데 Python 비동기 프로그래밍을 공부하기 시작하면 여기서부터 조금 혼란스러워진다.
갑자기 비슷해 보이는 용어들이 쏟아져 나오기 때문이다.
Synchronous
Asynchronous

Blocking
Non-blocking

Concurrency
Parallelism

async
await

Coroutine
Task
Event Loop
특히 이런 설명을 자주 접한다.
“async를 사용하면 여러 작업을 동시에 실행할 수 있습니다.”
완전히 틀린 말은 아니다.
하지만 이 표현만 기억하면 비동기를 잘못 이해하기 쉽다.
여러 작업을 동시에 다루는 것과 여러 작업을 실제로 동시에 실행하는 것은 같은 이야기가 아니기 때문이다.
이번 편에서는 이 차이를 하나씩 풀어보자.
1. 가장 먼저 동기(Synchronous)부터 이해하자
동기 방식은 우리가 일반적으로 프로그램을 작성할 때 가장 자연스럽게 생각하는 실행 흐름이다.
예를 들어 다음 코드가 있다고 하자.
result = call_llm()
save_to_db(result)
return result
코드를 읽는 순서와 실행되는 순서가 거의 같다.
call_llm()
    │
    ▼
결과를 받음
    │
    ▼
save_to_db()
    │
    ▼
저장 완료
    │
    ▼
return
call_llm()이 끝나야 save_to_db()를 실행할 수 있고,
save_to_db()가 끝나야 결과를 반환한다.
매우 직관적이다.
그래서 동기 프로그램은 이해하기 쉽고 디버깅하기도 상대적으로 쉽다.
문제는 call_llm()이 오래 걸릴 때다.
2. LLM API가 5초 걸린다면?
FastAPI API Server가 외부 LLM API를 호출한다고 생각해보자.
FastAPI API Server
        │
        │ HTTP Request
        ▼
     LLM API
        │
        │
        │ 5초 동안 추론
        │
        ▼
     Response
        │
        ▼
FastAPI API Server
LLM이 답변을 만드는 데 5초가 걸린다.
중요한 것은 이 5초 동안 누가 계산하고 있는가다.
외부 LLM 서비스를 사용한다면 실제 AI 추론은 LLM Provider의 시스템에서 수행된다.
우리 FastAPI API Server의 CPU가 5초 동안 LLM 추론을 하는 것이 아니다.
FastAPI 입장에서는 상당 부분이
요청 보냄
   ↓
기다림
   ↓
응답 도착
이다.
바로 이 기다림을 어떻게 처리할 것인가에서 동기와 비동기의 차이가 드러나기 시작한다.
3. 다시 식당으로 돌아가 보자
1부에서 사용했던 식당을 다시 생각해보자.
직원 한 명이 있고 손님 A가 주문한다.
손님 A
   │
   ▼
직원
   │
   │ 주문 전달
   ▼
주방
주방에서 음식을 만드는 데 10분이 걸린다.
첫 번째 방식은 직원이 주방 앞에서 기다리는 것이다.
손님 A
   ↓
직원
   ↓
주방

직원 : "음식 나올 때까지 여기 있어야지."

        10분...

음식 완성
   ↓
직원
   ↓
손님 A
그동안 손님 B가 들어왔다.
하지만 직원은 주방 앞에서 기다리고 있다.
손님 C도 들어왔다.
역시 기다린다.
손님 B ─┐
손님 C ─┤
손님 D ─┤──→ 직원은 주방 앞에서 기다리는 중
손님 E ─┘
이것이 우리가 이해하기 쉬운 Blocking 형태의 기다림이다.
현재 작업이 끝날 때까지 실행 흐름을 붙잡고 있다.
4. 그렇다면 비동기 방식은 어떻게 다를까?
이번에는 직원의 행동을 바꿔보자.
손님 A의 주문을 주방에 전달한다.
손님 A
   ↓
직원
   ↓
주방
그런데 직원이 주방 앞에서 기다리지 않는다.
직원은 이렇게 생각한다.
“음식이 완성되면 알려주세요.”
그리고 손님 B에게 간다.
손님 A 주문 → 주방

        음식 만드는 중...
              │
              │
직원 ─────────┼──→ 손님 B 주문 받기
              │
              ├──→ 손님 C 주문 받기
              │
              └──→ 손님 D 주문 받기
잠시 뒤 주방에서 알린다.
"A 주문 나왔습니다!"그러면 직원은 다시 A의 작업으로 돌아간다.
주방
 ↓
A 음식 완성
 ↓
직원
 ↓
손님 A
여기서 직원이 여러 명이 된 것은 아니다.
직원은 여전히 한 명이다.
달라진 것은 기다리는 방법이다.
이것이 비동기를 이해하는 핵심이다.
5. 비동기(Asynchronous)는 “동시에 실행”이라는 뜻이 아니다
여기서 가장 중요한 오해 하나를 정리하자.
비동기라고 해서 반드시 여러 코드가 물리적으로 같은 순간에 실행되는 것은 아니다.
앞의 식당을 보면 직원은 한 명이다.
시간 ─────────────────────────────→

직원

A 주문 처리
    ↓
A 주방 대기

        B 주문 처리
            ↓
        B 주방 대기

                C 주문 처리
                    ↓
                C 주방 대기

        A 음식 완성
             ↓
        A 응답 처리
직원 한 명이 매우 빠르게 여러 업무 사이를 이동하고 있을 뿐이다.
이 상태를 이해하려면 Concurrency, 즉 동시성이라는 개념이 필요하다.
6. Concurrency — 여러 일을 동시에 “다루는” 능력
Concurrency는 보통 여러 작업이 같은 시간 구간에 진행될 수 있도록 관리하는 것이라고 이해하면 좋다.
예를 들어 직원 한 명이 세 테이블을 담당한다.
직원 1명

Table A ──────── 기다림 ────── 처리
        \
Table B ── 처리 ─── 기다림 ───── 처리
             \
Table C ───── 처리 ─── 기다림 ─── 처리
어느 한 순간을 아주 잘게 잘라서 보면 직원은 한 가지 일을 하고 있을 수 있다.
하지만 조금 긴 시간 범위에서 보면 A, B, C 세 작업이 모두 진행되고 있다.
이것이 Concurrency다.
중요한 표현은 이것이다.
Concurrency는 여러 작업을 동시에 완료하는 것이 아니라 여러 작업이 함께 진행될 수 있도록 다루는 것이다.
7. Parallelism — 진짜 동시에 실행한다
이번에는 직원이 세 명이라고 생각해보자.
직원 A → Table A

직원 B → Table B

직원 C → Table C
세 직원이 같은 순간에 각각 다른 일을 할 수 있다.
컴퓨터로 생각하면 여러 CPU Core에서 실제 계산이 동시에 실행되는 상황과 비슷하다.
CPU Core 1 ─→ Task A

CPU Core 2 ─→ Task B

CPU Core 3 ─→ Task C

CPU Core 4 ─→ Task D
이것이 Parallelism, 병렬성이다.
그래서 둘을 간단히 비교하면 다음과 같다.
개념의미Concurrency여러 작업을 함께 진행되도록 관리Parallelism여러 작업을 실제 같은 순간에 실행
비동기 프로그래밍에서 우리가 주로 활용하는 것은 Concurrency다.
8. Concurrency와 Parallelism을 그림으로 비교해보자
Concurrency는 이런 모습에 가깝다.
CPU / Thread 1개

시간 ─────────────────────────────→

Task A ███───────███────────██

Task B ───███────────███──────

Task C ──────██──────────████
하나의 실행 자원이 여러 Task 사이를 오간다.
반면 Parallelism은 다음과 같다.
시간 ─────────────────────────────→

CPU Core 1 : Task A █████████████

CPU Core 2 : Task B █████████████

CPU Core 3 : Task C █████████████
실제로 여러 작업이 동시에 실행된다.
따라서
Async
   ≠
Parallel
이다.
비동기 코드를 작성했다고 CPU Core가 늘어나는 것은 아니다.
9. 그렇다면 Blocking과 Non-blocking은 무엇일까?
여기서 또 하나 헷갈리는 용어가 등장한다.
Synchronous / Asynchronous

Blocking / Non-blocking
이 둘을 같은 의미로 사용하는 경우가 많은데 정확히는 서로 다른 관점의 개념이다.
간단하게 접근하면 Blocking은
어떤 작업을 기다리는 동안 현재 실행 흐름을 붙잡고 있는가?
를 보는 것이다.
예를 들어 다음 코드가 있다고 하자.
import requests

response = requests.get(url)
HTTP 요청을 보낸 뒤 응답이 돌아올 때까지 현재 실행 흐름은 이 호출에서 기다린다.
개념적으로는 다음과 같다.
현재 실행 흐름
      │
      ▼
HTTP Request
      │
      ▼
████████████████
 응답 기다리는 중
████████████████
      │
      ▼
Response
      │
      ▼
다음 코드
이것이 Blocking I/O의 전형적인 모습이다.
10. Non-blocking은 기다림을 붙잡고 있지 않는다
비동기 HTTP Client를 사용하는 경우를 생각해보자.
response = await client.get(url)개념적으로는 이렇게 생각할 수 있다.
Task A
   │
   ▼
HTTP Request
   │
   ▼
응답 대기
   │
   └──────── 실행 기회 양보
                  │
                  ▼
               Task B
                  │
                  ▼
               Task C

        HTTP Response 도착
                  │
                  ▼
               Task A 재개
Task A는 여전히 결과를 기다리고 있다.
중요한 것은 Task A가 기다리는 동안 Event Loop 전체가 같이 기다리지 않는다는 것이다.
11. 여기서 Event Loop가 다시 등장한다
1부에서 Event Loop를 잠깐 설명했다.
다시 한 문장으로 정리하면 다음과 같다.
Event Loop는 지금 실행할 수 있는 작업을 실행하고, 기다려야 하는 작업은 잠시 내려놓았다가 준비되면 다시 이어서 실행하도록 관리하는 반복 실행 구조다.
예를 들어 세 개의 요청이 있다고 해보자.
Request A → LLM API
Request B → Vector DB
Request C → RDB
Event Loop 관점에서는 대략 이런 일이 반복된다.
Event Loop
    │
    ▼
Request A 실행
    │
    ▼
LLM 응답 기다려야 함
    │
    ▼
실행권 양보
    │
    ▼
Request B 실행
    │
    ▼
Vector DB 응답 기다려야 함
    │
    ▼
실행권 양보
    │
    ▼
Request C 실행
    │
    ▼
...
그러던 중 LLM 응답이 준비된다.
LLM 응답 도착
      │
      ▼
Event Loop
      │
      ▼
Request A 다시 실행
이 구조 덕분에 하나의 Event Loop가 많은 I/O-bound 작업을 효율적으로 다룰 수 있다.
12. 그렇다면 await는 정확히 무엇을 하는가?
이제 다음 코드가 조금 다르게 보일 것이다.
async def ask_llm():
    result = await call_llm()
    return result
처음 보면 await라는 단어 때문에 이런 느낌이 든다.
“여기서 기다리라는 뜻인가?”
맞다.
현재 Coroutine은 결과를 기다린다.
하지만 중요한 것이 빠져 있다.
어떻게 기다리는가?
개념적으로는 이렇게 이해하는 것이 좋다.
await
  │
  ▼
"나는 이 결과가 있어야
 다음 단계로 갈 수 있습니다."
  │
  ▼
"하지만 지금 당장 할 일이 없으니
 실행 기회를 다른 Task에 양보합니다."
즉,
await는 단순히 “멈춰서 기다려”가 아니라 “이 작업의 완료를 기다려야 하니, 그동안 다른 실행 가능한 작업이 있다면 실행 기회를 넘겨”에 가깝다.
물론 await 가능한 객체와 Coroutine의 실제 동작은 조금 더 복잡하다.
지금 단계에서는 이 정도 개념이면 충분하다.
13. await를 만나면 무엇이 멈추는가?
이 질문은 굉장히 중요하다.
다음 코드가 있다고 하자.
@app.get("/question")
async def question():
    result = await call_llm()
    return result
call_llm()의 결과가 필요하므로 현재 question() Coroutine의 진행은 잠시 멈춘다.
하지만 제대로 구현된 비동기 I/O라면 Event Loop 자체가 멈추는 것은 아니다.
question() Coroutine
        │
        ▼
await call_llm()
        │
        ├──────────────→ LLM API
        │
        │
        │  현재 Coroutine 대기
        │
        ▼
   Event Loop는
   다른 Task 처리
        │
        ├─ Request B
        ├─ Request C
        └─ Request D
이 차이를 반드시 기억해야 한다.
await

현재 Coroutine     → 기다릴 수 있음

Event Loop 전체    → 반드시 멈추는 것이 아님
바로 이 구조 때문에 비동기 I/O가 높은 동시성을 처리할 수 있다.
14. 그런데 async 함수 안에서 Blocking 코드를 실행하면?
이제 위험한 코드 하나를 보자.
import requests

@app.get("/question")
async def question():
    response = requests.get(
        "https://example.com/api"
    )

    return response.json()
Endpoint가 async def로 선언되어 있다.
그런데 내부에서는 동기 HTTP Client인 requests를 사용했다.
실행 흐름은 이렇게 될 수 있다.
Event Loop
    │
    ▼
Request A
    │
    ▼
requests.get()
    │
    ▼
██████████████████████
 HTTP Response 기다림
 Event Loop 진행 방해
██████████████████████
    │
    ▼
Response
이 동안 같은 Event Loop가 담당하는 다른 Task들이 영향을 받을 수 있다.
Request A ── requests.get() ─────────→

Request B ───────────── 기다림 ──────→

Request C ───────────── 기다림 ──────→

Request D ───────────── 기다림 ──────→
그래서 중요한 것은 함수 앞에 async를 붙였느냐가 아니다.
그 함수 안에서 Event Loop를 Blocking하는 코드가 실행되고 있는가를 봐야 한다.
15. CPU-bound 작업도 같은 문제가 생긴다
다음 Endpoint를 생각해보자.
@app.post("/parse")
async def parse_pdf():
    result = parse_large_pdf()
    return result
parse_large_pdf()가 CPU를 10초 동안 계속 사용하는 작업이라고 하자.
Event Loop
    │
    ▼
parse_large_pdf()
    │
    ▼
CPU 계산
████████████████████████
████████████████████████
████████████████████████
          10초
████████████████████████
████████████████████████
    │
    ▼
완료
여기에는 기다리면서 실행권을 양보할 지점이 없다.
CPU가 계속 Python 코드를 실행하고 있다.
그 결과 Event Loop가 다른 Task를 처리할 기회를 얻지 못할 수 있다.
Request A ─→ CPU-bound 작업 ─────────────────→ 완료
                    │
                    │ Event Loop 점유
                    │
Request B ──────────┼──────────── 기다림
Request C ──────────┼──────────── 기다림
Request D ──────────┴──────────── 기다림
여기서 중요한 차이가 있다.
앞에서 살펴본 LLM API 호출은 기다리는 작업이었다.
LLM API 호출
     ↓
외부 시스템이 처리
     ↓
우리 프로그램은 기다림
하지만 PDF Parsing과 같은 CPU-bound 작업은 다르다.
PDF Parsing
     ↓
우리 CPU가 직접 계산
     ↓
계속 실행 중
따라서 단순히 async를 붙인다고 해결되지 않는다.
async def parse_pdf():
    result = heavy_pdf_parsing()
    return result
이 코드는 비동기 함수처럼 보이지만 heavy_pdf_parsing()이 CPU를 오래 점유한다면 Event Loop에게 실행권을 돌려주지 않는다.
그래서 CPU-bound 작업에는 다른 접근이 필요하다.
예를 들어
CPU-bound 작업
      │
      ├── Thread
      ├── Process
      └── Background Worker
등으로 분리하는 방법을 고려할 수 있다.
어떤 방식을 선택해야 하는지는 작업의 특성과 Python의 실행 모델까지 함께 봐야 한다.
이 부분은 뒤의 실전 편에서 자세히 다루겠다.
16. async가 효과적인 곳은 어디일까?
이제 어느 정도 기준이 생겼다.
AI 서비스를 예로 들어보자.
다음 작업들은 대표적으로 I/O 대기가 발생한다.
FastAPI API Server
       │
       ├──→ LLM API
       ├──→ Embedding API
       ├──→ Vector DB
       ├──→ RDB
       ├──→ Redis
       ├──→ S3
       └──→ 외부 REST API
이런 작업들은 대부분 다른 시스템에 요청을 보내고 결과를 기다린다.
따라서 사용하는 Client나 Driver가 비동기를 지원한다면 async를 활용할 좋은 후보가 된다.
예를 들어 다음과 같다.
LLM API 호출             → I/O-bound
Embedding API 호출       → I/O-bound
Vector DB Query          → I/O-bound
RDB Query                → I/O-bound
Redis                    → I/O-bound
S3 Download / Upload     → I/O-bound
외부 HTTP API            → I/O-bound
반대로 다음과 같은 작업은 성격이 다르다.
이미지 변환
PDF Parsing
대규모 압축
복잡한 데이터 변환
로컬 ML Inference
대규모 수치 계산
이런 작업은 CPU-bound일 가능성이 있다.
물론 실제 작업은 이렇게 깔끔하게 둘 중 하나로만 나뉘지는 않는다.
예를 들어 PDF Parsing도 파일을 읽는 과정에는 I/O가 있고 실제 문서를 분석하는 과정에는 CPU 연산이 있을 수 있다.
그래서 중요한 것은 이름만 보고 판단하는 것이 아니다.
그 작업이 실제로 대부분의 시간을 어디에서 보내는지를 보는 것이다.
17. Background Worker에서도 똑같이 생각해야 한다
비동기는 FastAPI API Server에서만 필요한 개념이 아니다.
Background Worker를 생각해보자.
예를 들어 문서 처리 Worker가 다음 작업을 수행한다고 하자.
Queue
  │
  ▼
Background Worker
  │
  ├── S3에서 PDF 다운로드
  │
  ├── PDF Parsing
  │
  ├── Chunking
  │
  ├── Embedding API 호출
  │
  ├── Vector DB 저장
  │
  └── RDB 상태 업데이트
각 단계의 성격을 구분해보면 다음과 같다.
S3 Download        → I/O-bound

PDF Parsing        → CPU-bound 가능성

Chunking           → CPU-bound

Embedding API      → I/O-bound

Vector DB          → I/O-bound

RDB                → I/O-bound
하나의 Worker 안에서도 CPU 작업과 I/O 작업이 섞여 있다.
그래서
“Worker니까 동기로 만들어도 된다.”
또는
“AI 서비스니까 전부 async로 만들자.”
둘 다 좋은 기준이 아니다.
먼저 각각의 작업이 어떤 성격인지 분석해야 한다.
18. 그렇다면 async를 쓰면 요청을 많이 받을수록 좋은가?
여기서 또 다른 함정이 등장한다.
비동기를 이해하기 시작하면 이런 생각을 하기 쉽다.
“기다리는 동안 다른 작업을 할 수 있다면 최대한 많이 동시에 실행하면 되겠네?”
예를 들어 Embedding API를 호출해야 할 Chunk가 10,000개 있다고 하자.
Python에서는 다음과 같은 코드를 작성할 수 있다.
await asyncio.gather(
    *[
        create_embedding(chunk)
        for chunk in chunks
    ]
)
Chunk가 10,000개라면 10,000개의 비동기 작업이 만들어질 수도 있다.
처음에는 굉장히 효율적으로 보인다.
Embedding 1      ─→
Embedding 2      ─→
Embedding 3      ─→
Embedding 4      ─→
...
Embedding 10000  ─→
하지만 실제 Production 시스템에는 무한한 자원이 존재하지 않는다.
10,000 Tasks
      │
      ▼
HTTP Connection 증가
      │
      ├── Connection Pool 고갈
      ├── Socket 증가
      ├── Memory 증가
      ├── 외부 API Rate Limit
      └── Timeout 증가
              │
              ▼
             Retry
              │
              ▼
          요청량 증가
              │
              ▼
             장애
즉 비동기는 동시성을 가능하게 하는 기술이지,
무한한 동시성을 가능하게 하는 기술이 아니다.
이 차이가 매우 중요하다.
19. Concurrency에는 반드시 한계가 필요하다
Production에서는 질문이 한 단계 더 발전해야 한다.
처음에는
“동기로 할까, 비동기로 할까?”
를 고민한다.
하지만 실제 운영에서는 이런 질문이 더 중요하다.
“동시에 몇 개까지 실행할 것인가?”
예를 들어 Embedding API를 최대 20개까지만 동시에 호출하도록 제한할 수 있다.
개념적으로는 다음과 같다.
10,000 Tasks
     │
     ▼
┌───────────────────┐
│ Concurrency = 20  │
└───────────────────┘
     │
     ├── Task 1
     ├── Task 2
     ├── Task 3
     │
     ...
     └── Task 20

나머지 Task
     │
     ▼
    대기
Python의 asyncio에서는 Semaphore 등을 이용해 이런 동시성 제한을 구현할 수 있다.
semaphore = asyncio.Semaphore(20)

async def create_embedding(chunk):
    async with semaphore:
        return await embedding_api(chunk)
이제 최대 20개의 작업만 동시에 외부 Embedding API를 호출한다.
하나가 완료되면 기다리던 다음 작업이 실행된다.
동시에 실행

1  2  3  4  ... 20
│  │  │  │       │
▼  ▼  ▼  ▼       ▼

하나 완료
    │
    ▼

21번 Task 실행
비동기 프로그래밍의 목적은 가능한 한 많이 동시에 실행하는 것이 아니다.
시스템이 감당할 수 있는 범위에서 기다리는 시간을 효율적으로 활용하는 것이다.
20. 결국 Connection Pool과도 연결된다
Concurrency를 이야기하면 자연스럽게 Connection Pool 문제가 따라온다.
예를 들어 RDB Connection Pool 크기가 20이라고 하자.
FastAPI API Server
        │
        ▼
RDB Connection Pool

┌─────────────────────────┐
│ 1  2  3  ...       20   │
└─────────────────────────┘
        │
        ▼
       RDB
그런데 동시에 500개의 요청이 DB를 사용하려 한다.
500 Requests
      │
      ▼
Connection Pool = 20
      │
      ├── 20개 사용
      │
      └── 나머지 대기
async라고 해서 500개의 Connection이 갑자기 생기는 것이 아니다.
외부 시스템에는 각각 처리 가능한 용량이 있다.
FastAPI
   │
   ├── HTTP Connection Pool
   │
   ├── RDB Connection Pool
   │
   ├── Redis Connection Pool
   │
   ├── Vector DB 처리량
   │
   └── LLM API Rate Limit
그래서 비동기 프로그래밍을 Production 수준에서 이해하려면 결국
Concurrency
Connection Pool
Timeout
Rate Limit
Semaphore
Queue
Backpressure
같은 개념까지 연결해서 생각해야 한다.
21. 동시성과 병렬성을 다시 AI 서비스에 적용해보자
지금까지 내용을 실제 AI 서비스에 대입해보자.
FastAPI API Server가 다음 세 요청을 처리하고 있다고 하자.
Request A → LLM API
Request B → Vector DB
Request C → RDB
각 작업이 비동기 I/O를 지원한다면 하나의 Event Loop에서도 다음과 같이 진행될 수 있다.
시간 ───────────────────────────────────→

Request A
████ LLM 요청 ─────── 대기 ─────── ███ 응답처리

Request B
     ███ Vector DB ── 대기 ── ██ 응답처리

Request C
          ███ RDB ── 대기 ── ██ 응답처리
세 작업이 같은 시간 구간 안에서 함께 진행되고 있다.
이것이 Concurrency다.
하지만 CPU가 실제로 세 개의 Python 코드를 같은 순간에 실행하고 있다는 뜻은 아니다.
반대로 CPU-bound 작업을 여러 Process에 분산한다고 생각해보자.
Process 1 → CPU Core 1 → PDF Parsing A

Process 2 → CPU Core 2 → PDF Parsing B

Process 3 → CPU Core 3 → PDF Parsing C
이 경우에는 실제 여러 CPU Core에서 계산이 동시에 이루어질 수 있다.
이것이 Parallelism이다.
따라서 AI 서비스를 설계할 때는 두 가지 문제를 구분해야 한다.
I/O 대기가 많은가?
       │
       ▼
Concurrency / Async

CPU 계산이 많은가?
       │
       ▼
Parallelism / Process / Worker
이 구분만 제대로 해도 많은 설계 실수를 피할 수 있다.
22. 한 장으로 정리해보자
지금까지 나온 개념을 한 번에 정리하면 다음과 같다.
┌─────────────────────────────────────┐
│            Synchronous              │
│                                     │
│ 현재 작업의 결과를 따라             │
│ 순차적인 실행 흐름으로 진행          │
└─────────────────────────────────────┘


┌─────────────────────────────────────┐
│            Asynchronous             │
│                                     │
│ 작업 완료를 기다리는 동안           │
│ 다른 실행 가능한 작업을 진행         │
└─────────────────────────────────────┘


┌─────────────────────────────────────┐
│              Blocking               │
│                                     │
│ 기다리는 작업이 현재 실행 흐름의     │
│ 진행을 붙잡는다                      │
└─────────────────────────────────────┘


┌─────────────────────────────────────┐
│            Non-blocking             │
│                                     │
│ 기다리는 동안 다른 작업이           │
│ 진행될 기회를 가질 수 있다           │
└─────────────────────────────────────┘


┌─────────────────────────────────────┐
│            Concurrency              │
│                                     │
│ 여러 작업을 같은 시간 구간 안에서    │
│ 함께 진행되도록 관리한다             │
└─────────────────────────────────────┘


┌─────────────────────────────────────┐
│            Parallelism              │
│                                     │
│ 여러 작업을 실제로 동시에 실행한다   │
└─────────────────────────────────────┘
그리고 Python의 asyncio는 주로 다음 영역에 있다.
 I/O-bound
               │
               ▼
         Asynchronous
               │
               ▼
          Event Loop
               │
               ▼
          Concurrency
이 관계를 머릿속에 잡아두면 이후의 asyncio가 훨씬 이해하기 쉬워진다.
23. async/await를 문법으로 먼저 배우면 어려운 이유
많은 Python 비동기 강좌가 다음 코드부터 시작한다.
import asyncio

async def main():
    await something()

asyncio.run(main())
그러고 나서 Coroutine, Task, Future 같은 용어가 등장한다.
문법부터 보면 당연히 어렵다.
하지만 지금까지 살펴본 관점에서 보면 이야기가 달라진다.
우리가 해결하고 싶은 문제는 처음부터 하나였다.
외부 시스템에 요청했다.
        │
        ▼
결과가 아직 없다.
        │
        ▼
그동안 무엇을 할 것인가?
동기 Blocking 방식이라면
기다린다.비동기 방식이라면
현재 작업은 잠시 멈추고
        │
        ▼
실행 기회를 양보하고
        │
        ▼
다른 작업을 처리하고
        │
        ▼
결과가 준비되면
        │
        ▼
다시 돌아온다.
이 동작을 가능하게 만들기 위해 등장하는 것이
Coroutine
Task
Event Loop
await
다.
즉 이 용어들은 각각 따로 외워야 하는 이상한 Python 문법이 아니다.
기다리는 시간을 다른 작업에 활용하기 위한 실행 모델을 구성하는 요소들이다.
24. 이번 편에서 이것만은 기억하자
이번 편의 내용을 모두 기억할 필요는 없다.
다음 몇 가지만 정확히 기억하면 된다.
첫째,
비동기는 무조건 빠르게 만드는 기술이 아니다.
LLM API가 5초 걸린다면 async로 호출해도 LLM 자체는 여전히 5초 걸릴 수 있다.
둘째,
비동기는 병렬처리와 다르다.
Async ≠ Parallel비동기는 주로 I/O 대기시간을 이용해 여러 작업을 함께 진행시키는 Concurrency와 관련이 있다.
셋째,
await에서 현재 Coroutine이 기다리는 것과 Event Loop 전체가 멈추는 것은 다르다.
await

현재 Coroutine
      ↓
대기

Event Loop
      ↓
다른 Task 처리 가능
넷째,
async 함수 안에 Blocking 코드를 넣으면 비동기의 장점을 잃을 수 있다.
async def foo():
    requests.get(url)   # 주의
async def라고 적었다고 내부 코드가 자동으로 비동기가 되는 것은 아니다.
다섯째,
CPU-bound 작업은 단순히 async로 해결되지 않는다.
I/O-bound
    ↓
Async / Event Loop / Concurrency


CPU-bound
    ↓
Thread / Process / Worker / Parallelism 검토
그리고 마지막으로 가장 중요한 것.
비동기는 무한한 동시성을 의미하지 않는다.
Production에서는 항상
"동시에 실행할 수 있는가?"다음에
"동시에 몇 개까지 실행할 것인가?"를 물어야 한다.
이 질문이 다음 단계의 시작이다.
마치며
비동기 프로그래밍을 처음 접하면 async와 await가 가장 눈에 띈다.
하지만 실제로 중요한 것은 문법 뒤에 있는 실행 구조를 이해하는 것이다.
우리는 이번 편에서 다음 흐름을 살펴봤다.
I/O 요청
   ↓
결과를 기다림
   ↓
현재 작업 실행권 양보
   ↓
Event Loop
   ↓
다른 Task 실행
   ↓
I/O 완료
   ↓
기존 Task 재개
이 흐름을 이해하면 이제 다음 질문이 생긴다.
Event Loop는 실제로 이 작업들을 어떻게 관리하는 것일까?
async def로 만든 함수는 일반 함수와 무엇이 다른가?
Coroutine은 무엇인가?
Coroutine과 Task는 무엇이 다른가?
await를 만나면 Python 내부에서는 어떤 일이 벌어지는가?
그리고 다음 코드는
async def foo():
    print("A")
    await asyncio.sleep(1)
    print("B")
실제로 어떤 순서로 실행되는가?
이제 비동기의 필요성은 충분히 이해했다.
다음 편부터는 Python 내부로 한 단계 들어가 보자.
다음 글
AI 개발자가 알아야 할 비동기 프로그래밍 3부
Python asyncio는 어떻게 움직이는가 — Event Loop, Coroutine, Task 그리고 await
다음 편에서는 다음 코드 하나를 출발점으로 삼는다.
import asyncio

async def worker(name):
    print(f"{name} start")
    await asyncio.sleep(2)
    print(f"{name} end")

async def main():
    await asyncio.gather(
        worker("A"),
        worker("B"),
                worker("C"),
    )

asyncio.run(main())
이 코드를 실행하면 세 개의 worker()는 어떤 순서로 움직일까?
처음 비동기 코드를 접하면 다음과 같이 예상할 수도 있다.
A start
2초 대기
A end

B start
2초 대기
B end

C start
2초 대기
C end
그렇다면 전체 실행시간은 약 6초가 되어야 한다.
하지만 실제 실행 흐름은 다르다.
A start
B start
C start

      약 2초

A end
B end
C end
전체 실행시간은 약 2초에 가깝다.
그렇다면 여기서 질문이 생긴다.
worker A ─┐
worker B ─┼── 정말 동시에 실행된 것일까?
worker C ─┘
CPU가 세 개의 worker()를 동시에 실행한 것일까?
아니다.
이 코드에서 핵심은 바로 다음 부분이다.
await asyncio.sleep(2)worker(“A”)가 이 지점에 도달하면 A의 실행은 잠시 멈춘다.
하지만 Event Loop까지 2초 동안 멈추는 것은 아니다.
worker A
   │
   ▼
await asyncio.sleep(2)
   │
   └──── 실행권 양보
              │
              ▼
          Event Loop
              │
              ▼
          worker B
B도 같은 지점에 도달한다.
worker B
   │
   ▼
await asyncio.sleep(2)
   │
   └──── 실행권 양보
              │
              ▼
          Event Loop
              │
              ▼
          worker C
C 역시 실행권을 양보한다.
이제 세 Coroutine은 모두 기다리고 있다.
Event Loop

A ── sleep 2초 ── 대기
B ── sleep 2초 ── 대기
C ── sleep 2초 ── 대기
약 2초가 지나면 다시 실행할 수 있는 상태가 된다.
Event Loop는 준비된 작업들을 다시 실행한다.
약 2초 후

A ──→ 실행 가능
B ──→ 실행 가능
C ──→ 실행 가능
          │
          ▼
      Event Loop
          │
          ├── A 계속 실행
          ├── B 계속 실행
          └── C 계속 실행
바로 이 과정에서 Python 비동기 프로그래밍의 핵심 개념들이 모두 등장한다.
async def
   │
   ▼
Coroutine
   │
   ▼
Task
   │
   ▼
Event Loop
   │
   ▼
await
   │
   ▼
실행권 양보
   │
   ▼
다른 Task 실행
3부에서는 이 구조를 코드 한 줄씩 따라가며 살펴볼 것이다.
특히 다음 질문에 답해보려고 한다.
- async def를 호출하면 왜 함수가 바로 실행되지 않을까?
- Coroutine 객체는 일반 함수의 반환값과 무엇이 다를까?
- Coroutine과 Task는 무엇이 다를까?
- await를 만나면 현재 Coroutine에는 어떤 일이 생길까?
- Event Loop는 기다리고 있는 작업이 완료됐다는 것을 어떻게 알까?
- asyncio.create_task()는 무엇을 하는가?
- asyncio.gather()는 실제로 무엇을 동시에 처리하는가?
- asyncio.sleep()과 time.sleep()은 왜 완전히 다른 결과를 만들까?
그리고 마지막에는 FastAPI로 돌아와 다음 구조가 실제로 어떻게 동작하는지도 연결해보자.
@app.get("/question")
async def question():

    embedding = await embedding_api()

    documents = await vector_db.search(embedding)

    answer = await llm.generate(documents)

    return answer
겉으로 보면 몇 줄 되지 않는 코드다.
하지만 내부에서는
HTTP Request
      ↓
FastAPI
      ↓
Coroutine 생성
      ↓
Event Loop
      ↓
Embedding API 요청
      ↓
await
      ↓
다른 Request 처리
      ↓
Embedding 응답 도착
      ↓
Coroutine 재개
      ↓
Vector DB 요청
      ↓
await
      ↓
다른 Request 처리
      ↓
...
와 같은 일이 계속 반복되고 있다.
이 구조가 머릿속에 그려지기 시작하면 async와 await는 더 이상 외워야 하는 Python 문법이 아니다.
프로그램이 언제 실행되고, 언제 기다리고, 언제 다른 작업에 실행권을 넘기는지를 표현하는 코드로 보이기 시작한다.
다음 편에서는 드디어 Python의 Event Loop 안으로 들어가 보자.