18. Pixel RAG에서 GPU는 필요한가?
여기서 현실적인 문제가 나온다.
Text Embedding Model은 비교적 가볍다.
하지만 Visual Document Retriever는 Vision-Language Model을 기반으로 하기 때문에 훨씬 무겁다.
특히 문서 적재 시 다음 과정이 필요하다.
100 Page PDF

→ 100 Page Rendering
→ 100 Visual Encoding
→ Multi-Vector 생성
문서가 1,000개이고 평균 100페이지라면 처리해야 할 페이지는 100,000장이다.
CPU만으로도 기술적으로 처리할 수 있는 경우가 있지만, 실제 서비스에서는 처리 시간이 문제가 될 가능성이 높다.
그래서 대규모 Pixel RAG 시스템에서는 GPU Worker를 별도로 두는 구조를 고려할 수 있다.
                   Document Upload
                         │
                         ▼
                    Job Queue
                         │
              ┌──────────┴──────────┐
              │                     │
              ▼                     ▼
        Text Worker            Visual Worker
           CPU                     GPU
              │                     │
              ▼                     ▼
      Text Embedding          Visual Embedding
              │                     │
              ▼                     ▼
        Vector DB              Vector DB
이렇게 하면 일반적인 Text Pipeline과 무거운 Visual Pipeline을 분리할 수 있다.
특히 Visual Embedding은 반드시 실시간으로 처리할 필요도 없다.
예를 들어 다음과 같이 상태를 관리할 수 있다.
UPLOADED
    ↓
PARSING
    ↓
CHUNKING
    ↓
TEXT_EMBEDDING
    ↓
TEXT_READY
    ↓
VISUAL_PROCESSING
    ↓
VISUAL_READY
    ↓
COMPLETED
Text RAG는 먼저 사용할 수 있도록 만들고 Pixel RAG 처리는 백그라운드에서 계속 진행하는 방식이다.
사용자 입장에서도 수백 페이지의 PDF가 Visual Processing까지 끝날 때까지 기다릴 필요가 없다.
19. Visual Embedding 비용보다 더 조심해야 할 것이 있다
Pixel RAG에서는 세 종류의 비용을 따로 생각하는 것이 좋다.
① Ingestion Cost
문서를 처음 등록할 때 발생한다.
PDF Rendering
      +
Visual Encoding
      +
Vector Storage
      +
Image Storage
Visual Embedding은 문서를 등록할 때 한 번 만들어두면 이후 질문마다 다시 만들 필요는 없다.
따라서 대부분 초기 적재 비용이다.
② Retrieval Cost
질문이 들어올 때마다 발생한다.
Query Encoding
      ↓
Vector Search
      ↓
Late Interaction
일반적인 Single-Vector 검색보다 계산량과 저장량이 증가할 수 있다.
특히 페이지마다 많은 Vector를 보관한다면 페이지 수가 많아질수록 부담이 커진다.
③ Generation Cost
여기가 상당히 중요하다.
Relevant Page Images
        │
        ▼
       VLM
VLM에게 여러 장의 고해상도 페이지 이미지를 계속 전달하면 비용이 빠르게 증가할 수 있다.
그래서
Top 20 Pages → VLM같은 방식은 피하는 것이 좋다.
대신
Retrieval Top 20
       ↓
Reranking
       ↓
Top 3
       ↓
VLM
처럼 최종 이미지 수를 줄이는 것이 중요하다.
Pixel RAG에서는 Retrieval 정확도가 비용 최적화와 직접 연결된다.
20. 페이지 해상도도 비용과 성능에 영향을 준다
PDF 페이지를 무조건 최고 해상도로 저장한다고 좋은 것은 아니다.
예를 들어 A4 페이지를 지나치게 고해상도로 변환하면 이미지 파일 크기도 커지고 Visual Model 처리 비용도 증가한다.
반대로 너무 낮은 해상도로 변환하면 작은 글자와 표 안의 숫자를 읽기 어려워진다.
따라서 적절한 균형을 찾아야 한다.
              Resolution

낮음  ◀────────────────────▶ 높음

저비용                         고비용
빠름                           느림

        그러나

문자 인식 ↓               문자 인식 ↑
표 인식 ↓                 표 인식 ↑
특히 기업 문서에서는 작은 글씨의 표와 각주가 많기 때문에 실제 문서 샘플을 이용한 테스트가 필요하다.
21. 모든 페이지를 Pixel Embedding 해야 할까?
반드시 그럴 필요는 없다.
문서를 분석해서 Visual Information이 중요한 페이지만 선택할 수도 있다.
예를 들어 다음과 같은 페이지는 Visual Processing 우선순위를 높인다.
표 존재
그래프 존재
다이어그램 존재
이미지 존재
다단 레이아웃
복잡한 문서 구조
OCR 필요
반대로 다음과 같은 페이지는 Text RAG만으로 충분할 가능성이 높다.
일반 문단
텍스트 위주 페이지
단순 목록
텍스트 기반 규정
그러면 파이프라인은 다음처럼 발전할 수 있다.
Page
 │
 ▼
Page Analyzer
 │
 ├───────────────┐
 │               │
 ▼               ▼
TEXT_ONLY      VISUAL
 │               │
 ▼               ▼
Text RAG      Pixel RAG
이렇게 하면 전체 문서의 일부 페이지만 Visual Embedding할 수 있다.
22. 그런데 여기에는 함정이 있다
“표가 있는 페이지만 Pixel RAG를 사용하면 되지 않을까?”
언뜻 보면 좋은 최적화다.
하지만 Document Analyzer가 잘못 판단하면 검색 대상 자체에서 페이지가 사라진다.
예를 들어 페이지에 작은 그림과 설명이 있고 그것이 질문의 핵심 정보라고 하자.
Analyzer가 해당 페이지를 TEXT_ONLY로 분류했다면 Visual Search에서는 그 페이지를 찾을 방법이 없다.
따라서 초기 버전에서는 지나친 최적화를 하지 않는 편이 안전하다.
먼저 모든 PDF 페이지를 Visual Indexing하고 실제 사용 데이터를 수집한 뒤 최적화하는 방법도 충분히 합리적이다.
23. Text RAG와 Pixel RAG는 경쟁 관계가 아니다
여기까지 보면 이런 생각이 들 수 있다.
“Pixel RAG가 발전하면 Text RAG가 필요 없어지는 것 아닌가?”
현재로서는 그렇게 보기 어렵다.
Text RAG는 여전히 굉장히 강력하다.
예를 들어 다음 질문이 있다고 하자.
개인정보 처리방침에서 개인정보 보관 기간과 파기 절차를 설명해줘.
텍스트로 정확하게 Parsing되어 있다면 Text Retrieval이 빠르고 저렴하며 정확하다.
반대로 이런 질문은 다르다.
37페이지 표에서 각 제품의 전년 대비 성장률을 비교해줘.
이 경우 Visual Information이 중요하다.
그래서 두 방식은 서로 다른 강점을 가진다.
                Document Understanding

        ┌──────────────┴──────────────┐
        │                             │
        ▼                             ▼

     Text RAG                     Pixel RAG

텍스트 의미 검색                 시각적 문서 검색

문장                             표
문단                             차트
규정                             레이아웃
정책                             다이어그램
FAQ                              스캔 문서

        │                             │
        └──────────────┬──────────────┘
                       ▼

                  Hybrid RAG
24. 실제 서비스라면 나는 이렇게 시작할 것이다
기존 Text RAG가 이미 운영되고 있다고 가정해보자.
처음부터 ColPali, Multi-Vector DB, Query Router, Reranker까지 한꺼번에 넣지는 않을 것이다.
첫 번째 단계에서는 문서를 적재할 때 페이지 번호를 보존하는 것부터 시작한다.
Document
   ↓
Parser
   ↓
Chunk

chunk_id
document_id
page_no
그리고 원본 PDF에서 페이지 이미지를 생성한다.
Document

├── original.pdf
│
└── pages
    ├── 001.webp
    ├── 002.webp
    ├── 003.webp
    └── ...
검색은 기존 Text RAG를 그대로 사용한다.
Question
   ↓
Text Retrieval
   ↓
Chunk Top-K
   ↓
page_no 확인
   ↓
Page Image
   ↓
VLM
이것만으로도 꽤 재미있는 실험을 할 수 있다.
25. 그 다음 Visual Retrieval을 추가한다
Text Retrieval + VLM의 효과가 확인되면 그때 Visual Retriever를 추가한다.
                    Question
                       │
           ┌───────────┴───────────┐
           │                       │
           ▼                       ▼
     Text Retrieval          Visual Retrieval
           │                       │
           ▼                       ▼
        Chunks                    Pages
           │                       │
           └───────────┬───────────┘
                       ▼
                    Fusion
                       │
                       ▼
                    Rerank
                       │
                       ▼
               Relevant Context
                       │
                       ▼
                    LLM/VLM
여기까지 오면 진짜 Hybrid Multimodal RAG 시스템이라고 부를 만한 구조가 된다.
26. 여기서 Reranker가 상당히 중요해진다
Text Retrieval과 Visual Retrieval을 동시에 사용하면 Candidate가 많아진다.
예를 들어
Text Search

10 Chunks


Visual Search

10 Pages
총 20개의 후보가 생긴다.
이것을 모두 LLM/VLM에게 보내는 것은 비효율적이다.
그래서 Retrieval과 Generation 사이에 후보를 다시 평가하는 단계가 필요하다.
Retriever

Top 20
   ↓
Reranker

Top 5
   ↓
LLM / VLM
이 구조에서 Retriever의 역할은
“놓치지 않고 후보를 많이 찾는 것”
이고,
Reranker의 역할은
“그중 정말 중요한 것을 골라내는 것”
이다.
이 두 역할을 분리하면 Retrieval Recall과 Generation Cost 사이의 균형을 잡기 쉬워진다.
27. Pixel RAG에서 Citation은 오히려 좋아질 수 있다
Pixel RAG의 흥미로운 장점 중 하나가 출처 표시다.
Text RAG에서는 보통
Document
  ↓
Chunk
  ↓
Citation
관계를 관리한다.
Pixel RAG에서는 Page 자체가 Retrieval 단위이기 때문에 다음처럼 표현할 수 있다.
답변 근거
2026_사업보고서.pdf — Page 27
사용자가 Citation을 클릭하면 실제 원본 페이지를 보여줄 수도 있다.
Answer

"제품 C의 매출 증가율이 가장 높습니다."

          [근거 1]

              ↓ 클릭

┌────────────────────────────────┐
│ 2026_사업보고서.pdf             │
│                                │
│            Page 27             │
│                                │
│      [원본 페이지 이미지]       │
│                                │
└────────────────────────────────┘
기업용 RAG에서는 이 기능이 상당히 중요하다.
AI의 답변 자체보다
“왜 이렇게 답했는가?”
를 확인할 수 있어야 하기 때문이다.
28. 더 발전시키면 영역 단위 Citation도 가능하다
페이지 전체를 보여주는 것에서 한 단계 더 발전시킬 수 있다.
관련된 표나 그래프 영역을 Highlight해서 보여주는 것이다.
예를 들어 VLM 또는 별도의 Layout 분석 결과를 이용해서
Page 27

┌─────────────────────────────┐
│                             │
│     ┌─────────────────┐     │
│     │                 │     │
│     │  관련 매출 표    │ ← Highlight
│     │                 │     │
│     └─────────────────┘     │
│                             │
└─────────────────────────────┘
처럼 사용자에게 근거를 보여줄 수 있다.
그러면 Citation이 단순히
문서 27페이지에서 끝나는 것이 아니라
문서 27페이지의 이 표까지 내려갈 수 있다.
이것은 향후 Enterprise RAG에서 상당히 중요한 UX가 될 가능성이 있다.
29. 전체 시스템을 한 장으로 정리해보자
지금까지 만든 구조를 합치면 다음과 같다.
                       DOCUMENT
                           │
             ┌─────────────┴─────────────┐
             │                           │
             ▼                           ▼
        Text Pipeline               Visual Pipeline
             │                           │
             ▼                           ▼
           Parser                   Page Renderer
             │                           │
             ▼                           ▼
          Chunking                  Page Images
             │                           │
             ▼                           ▼
      Text Embedding              ColPali/ColQwen
             │                           │
             ▼                           ▼
      Text Vector DB              Multi-Vector DB
             │                           │
             │                           │
             └─────────────┬─────────────┘
                           │
                           │
                    USER QUESTION
                           │
                           ▼
                      Query Router
                           │
              ┌────────────┴────────────┐
              │                         │
              ▼                         ▼
        Text Retrieval           Visual Retrieval
              │                         │
              ▼                         ▼
            Chunks                     Pages
              │                         │
              └────────────┬────────────┘
                           ▼
                         Fusion
                           │
                           ▼
                        Reranker
                           │
                           ▼
                  Relevant Context
                           │
                 ┌─────────┴─────────┐
                 │                   │
                 ▼                   ▼
               Text               Images
                 │                   │
                 └─────────┬─────────┘
                           ▼
                        LLM/VLM
                           │
                           ▼
                         ANSWER
                           │
                           ▼
                        Citation
                           │
                           ▼
                    Original Page
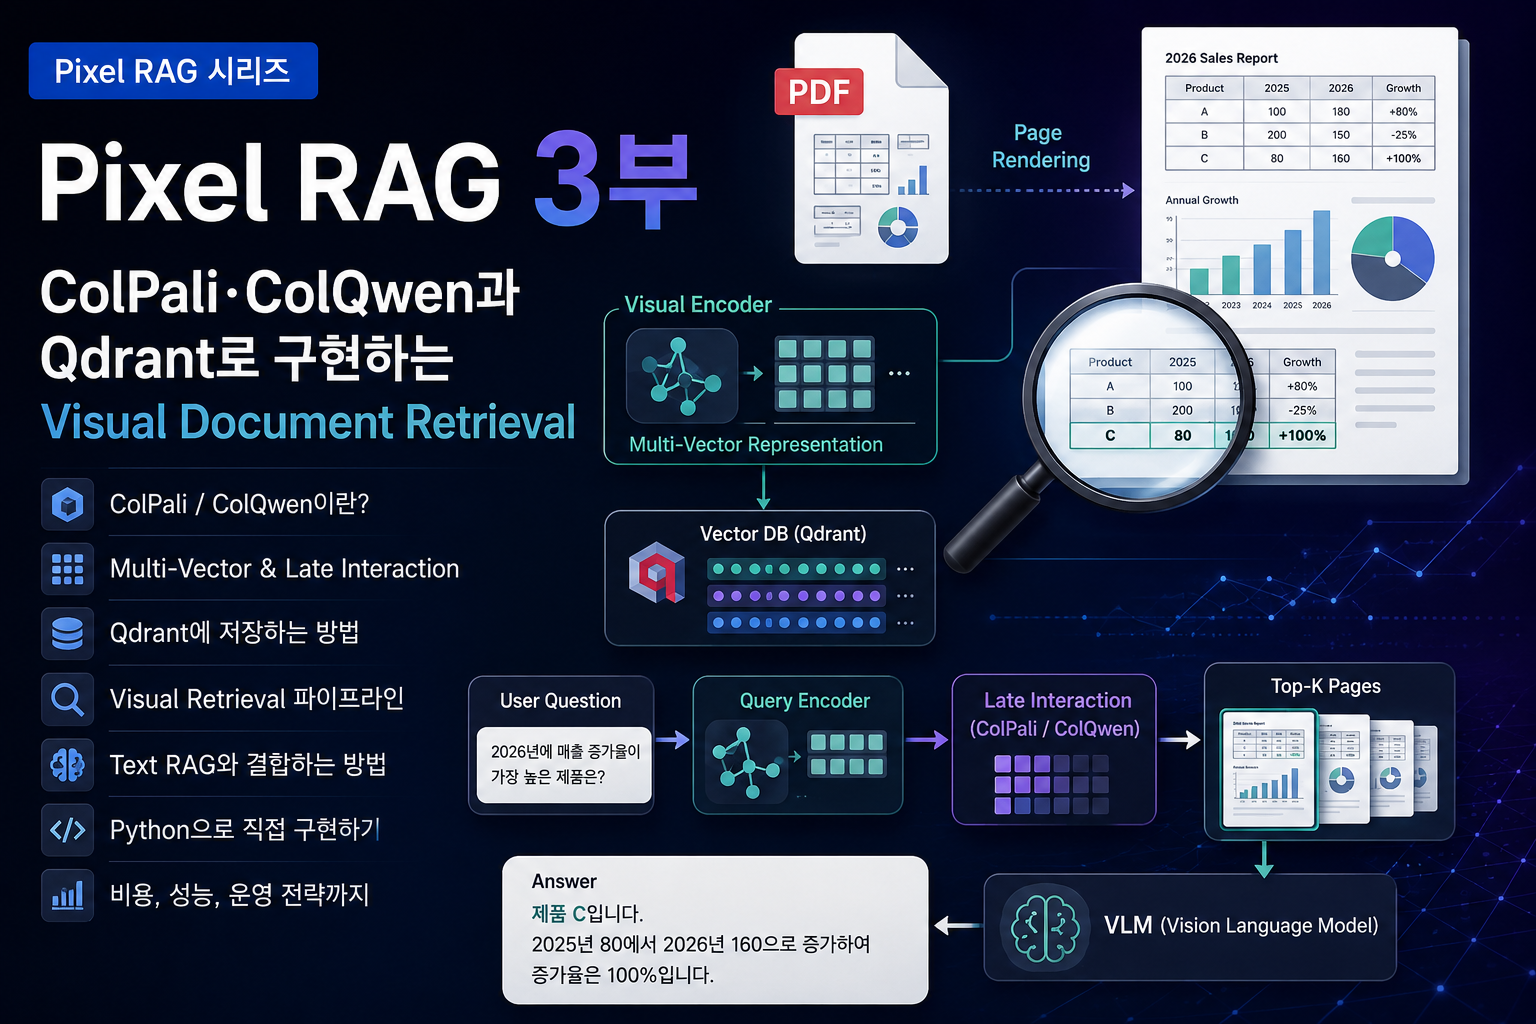
이 그림 하나가 이번 3부의 핵심이다.
30. Pixel RAG에서 정말 어려운 것은 모델 선택이 아니다
Pixel RAG를 처음 접하면 보통 관심이 모델로 향한다.
ColPali를 쓸까?
ColQwen을 쓸까?
어떤 VLM을 쓸까?
물론 중요한 문제다.
하지만 실제 서비스를 만들기 시작하면 더 어려운 문제들이 나타난다.
페이지와 Chunk의 관계를 어떻게 관리할 것인가?

Visual Vector를 어떻게 저장할 것인가?

수십만 페이지를 어떻게 Indexing할 것인가?

문서가 변경되면 Visual Index를 어떻게 갱신할 것인가?

Text와 Visual 검색 결과를 어떻게 합칠 것인가?

VLM에게 몇 페이지를 전달할 것인가?

멀티테넌트 검색 Filter는 어디에서 적용할 것인가?

Citation을 어떻게 원본 페이지와 연결할 것인가?

GPU Worker를 어떻게 운영할 것인가?

Visual Processing 실패를 어떻게 재처리할 것인가?
결국 Pixel RAG 역시 모델 하나를 붙이는 문제가 아니다.
Document Ingestion → Retrieval → Generation → Citation 전체 파이프라인을 설계하는 문제다.
31. Pixel RAG가 보여주는 RAG의 다음 방향
초기의 RAG는 거의 Text Retrieval을 의미했다.
Document
   ↓
Text
   ↓
Chunk
   ↓
Embedding
   ↓
Vector Search
하지만 실제 기업의 지식은 텍스트로만 존재하지 않는다.
PDF
PPT
Excel
표
차트
다이어그램
스캔 문서
이미지
설계도
가 모두 지식이다.
그래서 RAG도 자연스럽게 다음 방향으로 확장되고 있다.
Text RAG
   ↓
Hybrid Search
   ↓
Multimodal RAG
   ↓
Pixel / Visual Retrieval
   ↓
Document Understanding
Pixel RAG의 의미는 단순히 PDF를 이미지로 검색한다는 데 있지 않다.
더 중요한 변화는
AI가 사람이 문서를 보는 방식에 조금 더 가까워지고 있다는 것
이다.
마치며
Pixel RAG를 처음 보면 기존 RAG와 완전히 다른 기술처럼 보인다.
하지만 구조를 하나씩 뜯어보면 기존 RAG에서 크게 벗어나지 않는다.
기존에는
Text
   ↓
Embedding
   ↓
Retrieval
   ↓
LLM
이었다면,
Pixel RAG에서는
Page Image
     ↓
Visual Embedding
     ↓
Visual Retrieval
     ↓
VLM
이라는 새로운 검색 경로가 하나 추가된 것이다.
그리고 실제 서비스에서는 결국 두 경로가 합쳐진다.
Text Retrieval
       +
Visual Retrieval
       ↓
Hybrid Retrieval
       ↓
LLM / VLM
그래서 Pixel RAG를 도입하려는 개발자라면 처음부터 거대한 Multimodal RAG 시스템을 만들려고 하기보다는 다음 순서로 접근하는 것이 현실적이다.
① Chunk에 Page 정보 보존

        ↓

② Page Image 저장

        ↓

③ Text Retrieval + Page Image + VLM

        ↓

④ Visual Embedding 추가

        ↓

⑤ Visual Retrieval 추가

        ↓

⑥ Text + Visual Fusion

        ↓

⑦ Reranker

        ↓

⑧ Query Router / Adaptive Retrieval
특히 ③ Text Retrieval + Page Image + VLM까지는 기존 RAG 시스템을 크게 변경하지 않고도 실험할 수 있다.
그리고 효과가 확인됐을 때 Visual Retrieval을 추가해도 늦지 않다.
Pixel RAG의 핵심은 기존 RAG를 버리는 것이 아니다.
기존 RAG가 읽지 못했던 문서의 시각적 의미까지 검색 대상으로 확장하는 것.
그것이 Pixel RAG를 이해하는 가장 중요한 관점이라고 생각한다.
지금까지 RAG에서 문서는 사실상 ‘텍스트의 저장소’였다.
하지만 Pixel RAG에서는 문서 그 자체가 지식이 된다.
기존 RAG

Document
   ↓
Text
   ↓
Knowledge


Pixel RAG

Document
   │
   ├── Text
   ├── Layout
   ├── Table
   ├── Chart
   ├── Image
   └── Spatial Relationship
          │
          ▼
       Knowledge
이 차이는 생각보다 크다.
앞으로의 RAG는 단순히 **“관련 문장을 얼마나 잘 찾는가”**를 넘어,
“문서가 가지고 있는 의미를 얼마나 온전히 이해하고 검색할 수 있는가”
의 문제로 발전할 가능성이 높다.
그리고 Pixel RAG와 Visual Document Retrieval은 그 변화의 중요한 출발점 중 하나다.
3부 핵심 정리
이번 글의 내용을 한 문장으로 압축하면 다음과 같다.
ColPali·ColQwen 계열 Visual Retriever는 문서 페이지를 Multi-Vector로 표현하고 Late Interaction을 이용해 질문과 관련된 페이지를 찾으며, 찾아낸 페이지를 VLM에게 전달함으로써 기존 Text RAG가 놓치기 쉬운 표·차트·레이아웃까지 활용할 수 있게 한다.
전체 구조를 다시 아주 간단하게 표현하면 다음과 같다.
              ┌── Text Embedding ── Text Search ──┐
              │                                   │
Document ─────┤                                   ├── Rerank ── LLM/VLM ── Answer
              │                                   │
              └─ Visual Embedding ─ Visual Search ┘
그리고 실제 기존 RAG 시스템에 도입한다면 처음부터 이 모든 것을 구현할 필요는 없다.
가장 현실적인 출발점은 다음과 같다.
기존 RAG
   │
   ▼
Chunk ↔ Page Mapping
   │
   ▼
Page Image 저장
   │
   ▼
Text Retrieval
   │
   ▼
관련 Page Image
   │
   ▼
VLM
여기서 효과가 확인되면 그 다음에
Visual Embedding
      ↓
Visual Retrieval
      ↓
Hybrid Retrieval
      ↓
Reranking
      ↓
Adaptive Routing
순으로 확장하면 된다.
이렇게 접근하면 Pixel RAG는 생각보다 기존 RAG 시스템에서 멀리 떨어져 있는 기술이 아니다.
오히려 기존 RAG 위에 하나씩 쌓아갈 수 있는 자연스러운 확장에 가깝다.
다음 글
Pixel RAG 4부 — 직접 만들어보자: Python + Qdrant로 구현하는 Pixel RAG
지금까지는 아키텍처를 이해하기 위해 의도적으로 코드보다 개념에 집중했다.
4부에서는 실제 구현으로 들어간다.
하나의 PDF 파일을 업로드하고 질문을 던졌을 때 답변이 만들어지는 과정을 처음부터 끝까지 구현해본다.
PDF
 │
 ▼
Page Rendering
 │
 ├───────────────┐
 │               │
 ▼               ▼
Text Parsing   Page Image
 │               │
 ▼               ▼
Chunking      Visual Embedding
 │               │
 ▼               ▼
Text Embedding  Multi-Vector
 │               │
 └───────┬───────┘
         ▼
       Qdrant
         │
         ▼
      Question
         │
         ▼
   Hybrid Search
         │
         ▼
      Reranking
         │
         ▼
   Relevant Pages
         │
         ▼
        VLM
         │
         ▼
       Answer
         │
         ▼
      Citation
4부에서는 특히 다음 내용을 실제 코드 수준에서 다룬다.
- Python으로 PDF를 페이지 이미지로 변환하기
- ColPali/ColQwen 계열 모델 로딩
- Page Visual Embedding 생성
- Multi-Vector 구조 이해
- Qdrant Collection 설계
- Visual Vector 저장
- Query Embedding 생성
- Late Interaction 기반 검색
- Text Retrieval과 Visual Retrieval 결합
- 검색된 원본 페이지 가져오기
- VLM에 질문과 페이지 이미지 전달
- Citation 생성
- 전체 Pipeline을 하나의 Python 코드로 연결하기
그리고 단순한 데모 코드에서 끝내지 않고,
API Server
     │
     ▼
Job Queue
     │
 ┌───┴────┐
 ▼        ▼
CPU      GPU
Worker   Worker
 │        │
 └───┬────┘
     ▼
   Qdrant
     │
     ▼
Object Storage
처럼 실제 서비스로 확장한다면 어떤 구조가 필요한지도 함께 살펴볼 예정이다.
여기까지 이해했다면 이제 Pixel RAG의 개념은 충분하다.
다음부터는 직접 만들어볼 차례다.