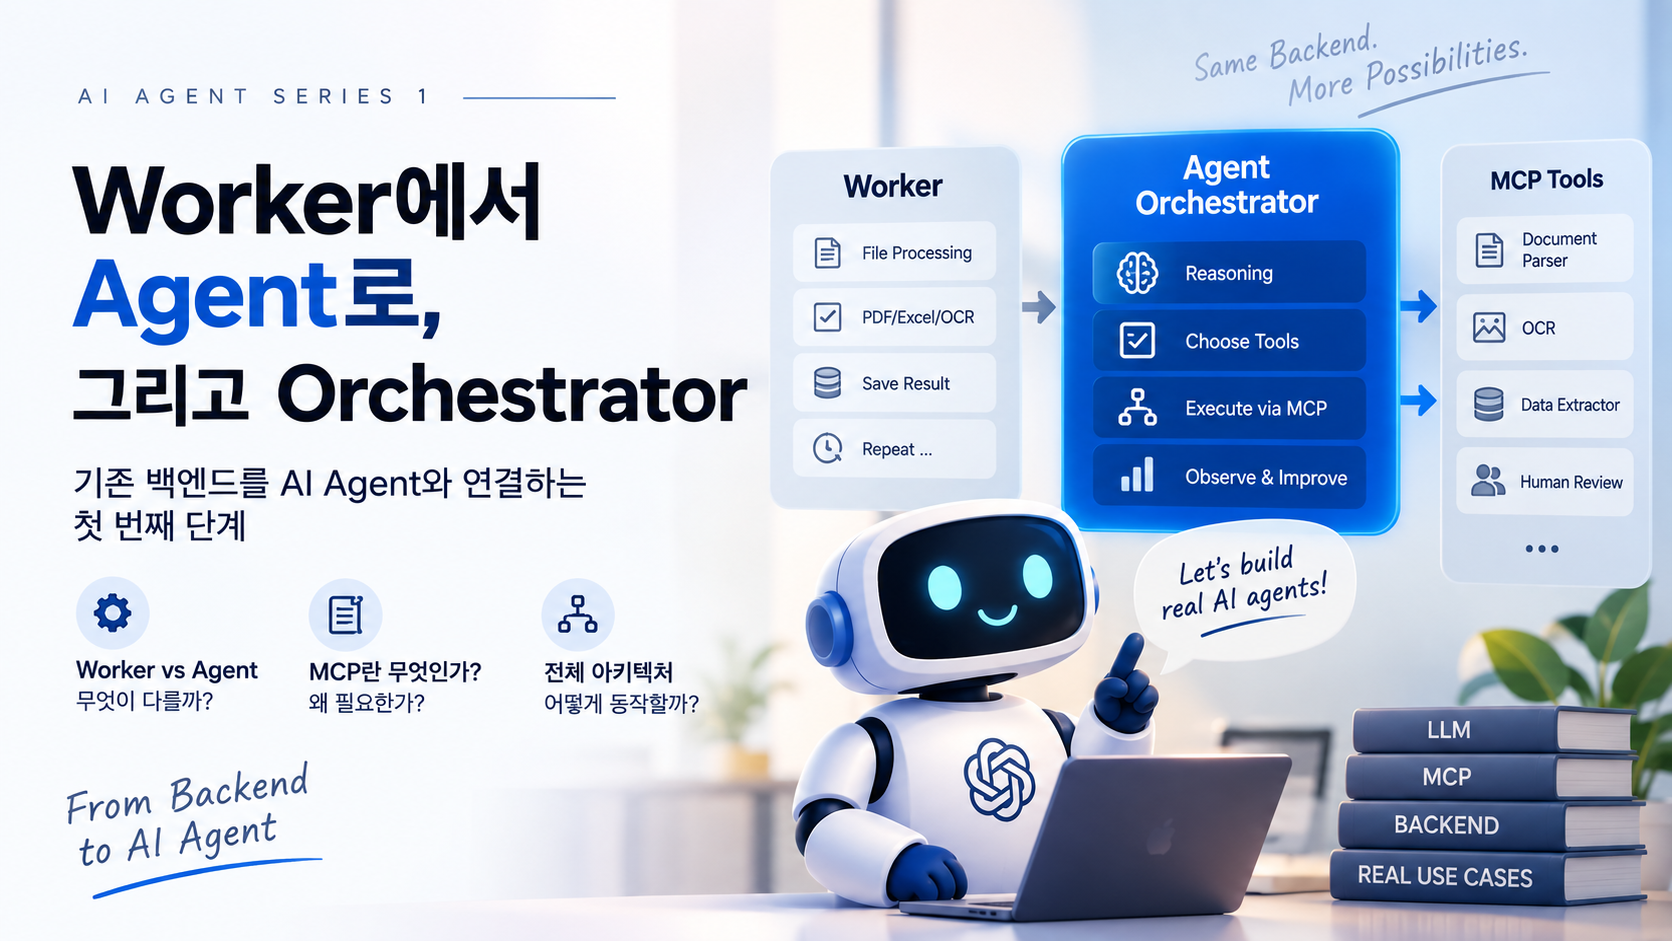
Worker에서 Agent Orchestrator로
백엔드에서 흔한 요구사항이 있다.
사용자가 파일을 업로드하면 자동으로 분석하고 결과를 저장한다.
처음에는 단순하다.
File Upload
    ↓
Worker
    ↓
Parse
    ↓
Analyze
    ↓
Save
def process_document(document_id):
file = download_file(document_id)
text = parse_document(file)
result = analyze_document(text)
save_result(document_id, result)처리 과정이 항상 같다면 이 구조가 가장 단순하다. 문제는 시스템이 발전하면서 파일 종류와 업무 규칙이 늘어날 때 시작된다.
1. 처음에는 Worker 하나면 충분했다
처음에는 PDF만 처리했지만 Excel, 이미지, 스캔 PDF가 추가될 수 있다.
if file_type == "pdf":
    text = parse_pdf(file)
elif file_type == "xlsx":
    data = parse_excel(file)
elif file_type in ["jpg", "png"]:
    data = analyze_image(file)

if not text:
    text = run_ocr(file)
여기까지는 관리할 만하다. 하지만 요구사항은 계속 늘어난다.
2. 어려운 것은 “다음에 무엇을 해야 하는가”다
Invoice라면 텍스트 추출뿐 아니라 금액, 거래처, 날짜, 통화, 세금 등을 추출하고 검증해야 한다.
File Upload
     ↓
Parse
     ↓
Invoice Detection
     ↓
Invoice Extraction
     ↓
Validation
신뢰도가 높으면 저장한다. 낮으면 재분석, 다른 모델, OCR 또는 Human Review가 필요할 수 있다.
                    ┌── Save
                    │
Analysis → Decision ├── Retry
                    ├── Another Model
                    └── Human Review
문제는 이제 “파일을 어떻게 처리할까?”가 아니라 “현재 상태에서 다음에 무엇을 실행할까?”가 된다.
3. Workflow와 Agent의 차이
실행 순서가 명확한 RAG 적재 파이프라인을 생각해보자.
Upload → Parse → Chunk → Embedding → Vector DB이런 작업에는 Agent가 필요하지 않다. 코드나 Redis Streams, RabbitMQ, SQS 같은 Queue 기반 Workflow가 더 단순하고 예측 가능하다.
반대로 처리 경로를 미리 결정하기 어렵다면 이야기가 달라진다.
4. 처리 경로를 미리 결정하기 어려운 경우
                     ┌── PDF Parser
                     ├── Excel Analyzer
File Upload → 판단 ──┼── OCR
                     ├── Vision Model
                     └── Invoice Extractor
분석 이후에도 판단이 이어진다.
Analyze
   ↓
Validate
   ↓
Decision
   ├── Save
   ├── Retry
   ├── Additional Analysis
   └── Human Review
물론 if/elif로도 만들 수 있다. 하지만 조건이 계속 늘어나면 Worker는 단순 실행 프로그램이 아니라 거대한 의사결정 프로그램이 된다.
5. Worker에게서 “판단”을 분리한다
                 Orchestrator
                      │
              "무엇을 해야 하지?"
                      │
          ┌───────────┼───────────┐
          ↓           ↓           ↓
       Parser      Analyzer     Database
Orchestrator는 직접 PDF를 분석하거나 DB에 저장하지 않는다. 현재 상황을 보고 어떤 작업을 실행할지 결정한다.
Orchestrator
    ├── get_document
    ├── extract_text
    ├── analyze_document
    ├── extract_invoice
    ├── validate_invoice
    ├── save_analysis
    └── request_human_review
이 Orchestrator가 Agent 역할을 한다.
6. Agent를 “생각하는 Worker”라고 생각해보자
기존 Worker는 개발자가 정한 순서를 실행한다.
A → B → C → DAgent는 현재 상태를 보고 사용할 작업을 선택한다.
          ┌── B
A → Agent ├── C
          └── D
Invoice 분석 결과의 신뢰도가 높다면 저장하고 낮다면 Human Review로 보낼 수 있다. 같은 시스템에서도 런타임 상태에 따라 실행 경로가 달라진다.
7. Agent는 실제 기능을 어떻게 호출할까?
Python 함수를 Agent 코드에서 직접 호출할 수도 있다. 하지만 기능이 많아질수록 Agent와 실제 업무 기능이 강하게 결합된다.
Agent Application
│
├── Agent Logic
├── PDF Parser
├── OCR
├── Invoice Analyzer
├── Database
└── Human Review
그래서 질문이 생긴다.
Agent가 사용할 기능을 독립적인 Tool로 제공할 수 없을까?
이 지점에서 MCP가 등장한다.
8. MCP를 이용해 Agent와 Tool을 분리한다
              ┌─────────────────────┐
              │     Orchestrator    │
              │        Agent        │
              └──────────┬──────────┘
                         │
                        MCP
                         │
        ┌────────────────┼────────────────┐
        ↓                ↓                ↓
    File Tools        AI Tools        Data Tools
    get_document      classify        save_result
    extract_text      summarize       update_status
    run_ocr           extract_info    get_analysis
Agent는 Tool 내부 구현을 알 필요가 없다. 어떤 Tool이 존재하고, 무엇을 하며, 어떤 입력과 출력을 갖는지가 중요하다.
9. MCP는 Agent의 “능력 목록”을 제공한다
기존 REST API가 다른 프로그램이 사용할 기능을 제공하는 인터페이스라면, MCP Tool은 Agent가 발견하고 선택해서 사용할 수 있는 능력을 제공하는 인터페이스라고 볼 수 있다.
Tool: extract_invoice

Description:
Extract structured invoice information from a document.

Input:
{
  "document_id": "string"
}

Output:
{
  "vendor": "string",
  "amount": "number",
  "currency": "string",
  "confidence": "number"
}
Agent는 Tool 이름과 Description, Schema를 보고 사용할 기능을 판단한다.
10. 모든 함수를 MCP Tool로 만들 필요는 없다
다음 같은 내부 함수까지 Agent에게 제공할 필요는 적다.
normalize_string
calculate_hash
convert_datetime
remove_whitespace
반면 다음은 Agent가 선택할 가치가 있다.
analyze_document
extract_invoice
search_documents
request_human_review
save_analysis
함수(Function)와 Agent Tool은 같은 것이 아니다. Tool은 Agent가 선택할 가치가 있는 행동 단위여야 한다.
11. 파일 업로드가 Agent를 깨운다
Agent가 계속 파일 업로드를 감시할 필요는 없다. 기존 Event Driven Architecture를 활용하면 된다.
User
  │ Upload
  ↓
FastAPI
  ├── Object Storage
  └── Event
        ↓
   Redis Streams
        ↓
   Agent Worker
예를 들어 다음 이벤트가 Agent 실행의 시작점이 된다.
XADD document:uploaded * document_id 12345Redis Stream
↓
Agent Worker
↓
Orchestrator
↓
MCP Client
↓
MCP Server
↓
Tools즉 Agent가 파일을 감시하는 것이 아니라 Event가 Agent를 깨우는 것이다.
12. 전체 아키텍처
                    User
                      │
                   Upload
                      ↓
                  FastAPI
                      │
             ┌────────┴────────┐
             ↓                 ↓
       Object Storage       Redis Stream
                               │
                               ↓
                         Agent Worker
                               │
                               ↓
                         Orchestrator
                               │
                            MCP Client
                               │
                               ↓
                           MCP Server
                               │
          ┌────────────────────┼────────────────────┐
          ↓                    ↓                    ↓
      File Tools           AI Tools            Data Tools
FastAPI는 요청과 파일 저장, Queue는 이벤트 전달, Agent Worker는 Agent 실행, Orchestrator는 다음 행동 결정, MCP Server는 Tool 제공, Tool은 실제 업무 수행을 담당한다.
13. 기존 Workflow는 없어지는가?
그렇지 않다. 중요한 것은 어디까지 Workflow로 만들고 어디부터 Agent에게 맡길 것인가다.
Upload
  ↓
Virus Scan
  ↓
Store File
  ↓
Create Document
  ↓
Publish Event
  ↓
────────────────────────
       Agent 영역
  ↓
Agent Orchestrator
  ├── PDF Parser
  ├── OCR
  ├── Excel Analyzer
  ├── Vision Analyzer
  └── Invoice Extractor
          ↓
       Validate
          ↓
  ┌───────┼────────┐
  ↓       ↓        ↓
 Save    Retry   Human Review
항상 실행되는 작업은 Workflow가 더 적합하다.
14. Agent가 모든 것을 직접 처리할 필요는 없다
Agent의 핵심 역할은 실행보다 판단과 조정(Orchestration) 이다.
실제 작업은 Tool이 담당한다.
                 Agent
                   │
             Decision Making
                   │
        ┌──────────┼──────────┐
        ↓          ↓          ↓
      Tool       Tool       Tool
   parse_pdf    run_ocr   save_result
15. 기존 서비스를 버리고 MCP를 다시 만드는 것은 아니다
기존 Service Layer를 그대로 활용할 수 있다.
Agent
  ↓
MCP Tool
  ↓
Existing Service
  ↓
Database / Storage / AI
MCP는 기존 백엔드를 대체하기보다 Agent가 기존 백엔드 기능을 사용할 수 있도록 새로운 인터페이스를 추가하는 것에 가깝다.
16. MCP Tool의 경계가 중요하다
get_file_path, calculate_hash, normalize_filename 같은 내부 함수를 모두 Tool로 노출하기보다 다음처럼 의미 있는 업무 단위로 묶는 편이 좋다.
prepare_document
extract_document_content
analyze_invoice
validate_analysis
save_analysis
request_human_review
Tool은 함수의 단위가 아니라 Agent가 선택할 수 있는 행동의 단위다.
17. MCP를 사용한다고 시스템이 자동으로 좋아지는 것은 아니다
모든 문서가 항상 Parse → Chunk → Embedding → Save 순서로 처리된다면 Agent에게 다음 행동을 물어볼 이유가 없다.
Agent를 넣으면 LLM 호출 비용, 지연시간, 장애 지점과 예측 불가능성이 늘어날 수 있다.
따라서 먼저 물어봐야 한다.
이 시스템에는 정말 ‘판단’이 필요한가?
18. Agent + MCP가 유리한 상황
다음 특징이 있다면 검토할 가치가 있다.
- 입력 종류가 PDF, Excel, Image, Invoice, Contract처럼 다양하다.
- 분석 결과에 따라 Save, Retry, Additional Analysis, Human Review 등 다음 행동이 달라진다.
- OCR, Vision, ERP, Email, Slack 등 사용할 기능이 계속 증가한다.
- 업무 규칙이 복잡해져 단순한 고정 Workflow로 표현하기 어려워진다.
이런 지점에서 Agent Orchestrator의 가치가 생긴다.
19. 결국 중요한 것은 “판단”과 “실행”의 분리다
기존 Worker
 ├── Decision
 └── Execution
Agent 기반 구조에서는 이를 분리한다.
             Orchestrator
                  │
              Decision
                  │
                  ↓
                 MCP
                  │
        ┌─────────┼─────────┐
        ↓         ↓         ↓
      Tool      Tool      Tool
                 Execution
실제 비즈니스 로직은 기존 Service가 담당할 수도 있다.
Agent
  ↓
Orchestrator
  ↓
MCP Tool
  ↓
Service
  ↓
Infrastructure
20. Agent는 Workflow를 없애는 기술이 아니다
Queue도, Worker도, Redis Streams나 RabbitMQ, SQS도 여전히 유용하다. Database와 Service Layer도 그대로 존재한다.
달라지는 것은 일부 영역에서 Agent가 현재 상황을 보고 실행할 Tool을 선택한다는 점이다.
Developer
    ↓
Available Tools
    ↓
Agent
    ↓
Runtime Decision
Agent는 Workflow를 없애는 기술이 아니라, Workflow를 미리 결정하기 어려운 지점에 들어가는 기술이다.
그리고 MCP는 그 Agent가 사용할 수 있는 능력을 Tool 형태로 제공하는 방법 중 하나다.
마치며
처음에는 단순했다.
File Upload
    ↓
Worker
    ↓
Analyze
    ↓
Save
하지만 업무가 복잡해지면서 처리 과정에 판단이 들어오기 시작했다.
                     ┌── OCR
                     ├── PDF Parser
File Upload → Agent ─┼── Vision
                     ├── Invoice Analyzer
                     └── Human Review
판단과 실제 실행을 분리하면 다음 구조를 생각할 수 있다.
File Upload
     ↓
Event
     ↓
Agent Worker
     ↓
Orchestrator
     ↓
MCP
     ↓
Tools
이제 다음 질문이 자연스럽게 생긴다.
실제 Python 백엔드 기능을 어떻게 MCP Tool로 만들 수 있을까?
다음 글에서는 Python으로 MCP Server를 만들고, 기존 Service를 MCP Tool로 노출하고, Tool의 Input/Output Schema를 정의하는 방법을 살펴본다.
다음 글
2부 — Python으로 파일 분석용 MCP Tool 직접 만들어보기
Agent
  ↓
MCP Client
  ↓
MCP Server
  ├── get_document
  ├── extract_document_content
  ├── analyze_document
  └── save_analysis
그리고 “그냥 Python 함수를 호출하는 것과 MCP Tool을 사용하는 것은 무엇이 다른가?”라는 문제까지 이어서 살펴본다.