[카테고리:] Architecture & Operations

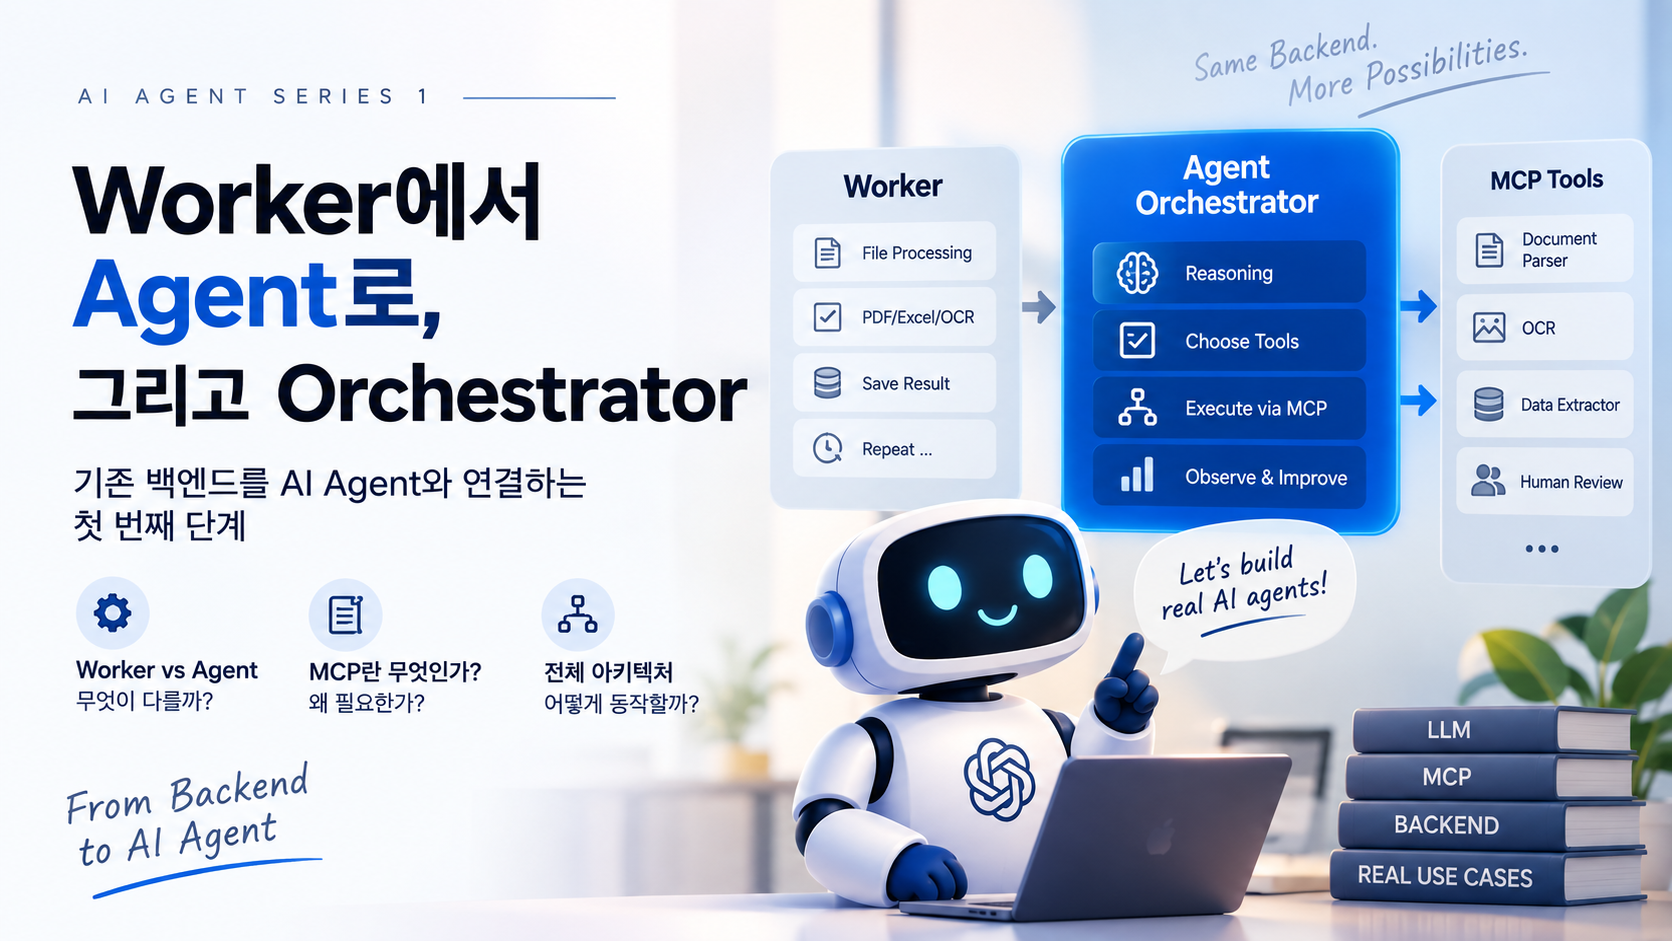
  • AI Agent & MCP 4부 — Redis Streams + MCP로 실제 Agent Runtime 구현하기

    AI Agent & MCP 4부 — Redis Streams + MCP로 실제 Agent Runtime 구현하기

    파일 업로드부터 Human Review, Pause/Resume까지 — AI Agent 시리즈 최종편

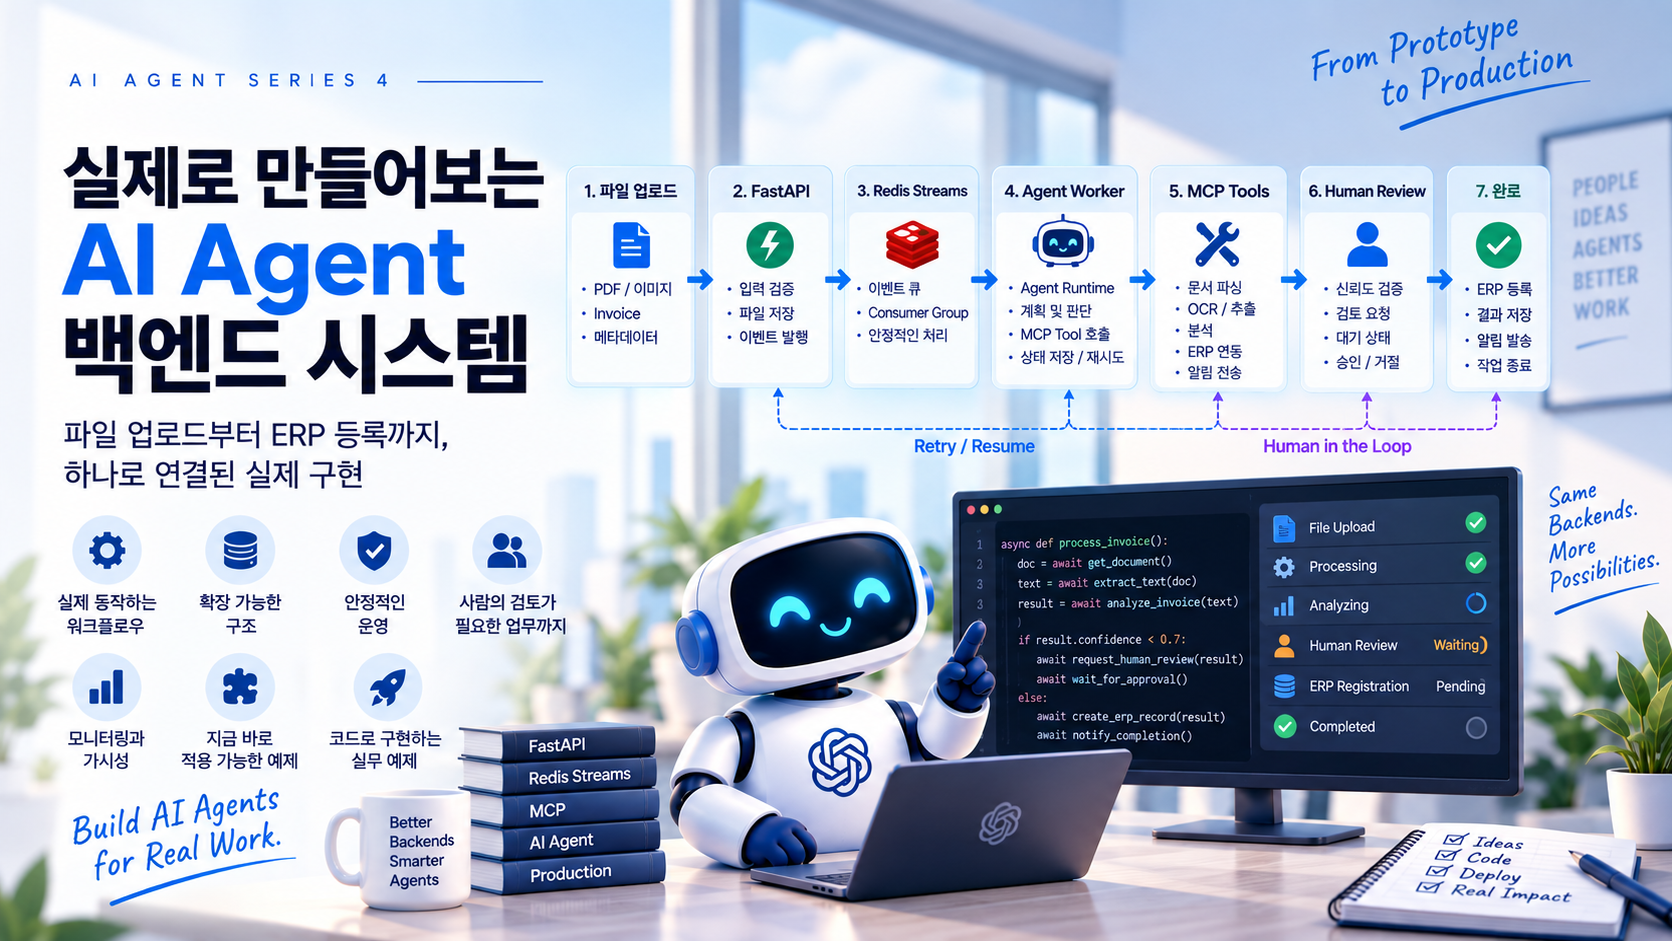
    앞의 세 편에서 우리는 단순한 Worker에서 시작해 Agent Orchestrator, MCP Tool, 그리고 운영 가능한 Agent Runtime의 구조까지 살펴봤다.

    이번 최종편의 목표는 지금까지 설명한 구성 요소를 실제로 연결하는 것이다.

    Invoice Upload
          ↓
    FastAPI
          ↓
    Redis Streams
          ↓
    Agent Worker
          ↓
    Agent Runtime
          ↓
    MCP Tools
          ↓
    Invoice Analysis
          ↓
    Confidence = 0.58
          ↓
    Human Review
          ↓
    WAITING_HUMAN
          ↓
    Worker 종료
    
          ... 몇 시간 후 ...
    
    Human APPROVE
          ↓
    Redis Resume Event
          ↓
    Agent Worker
          ↓
    Load Checkpoint
          ↓
    ERP Registration
          ↓
    COMPLETED
    

    완전한 상용 시스템 전체를 구현하기보다 실제 서비스로 확장할 수 있는 최소 구조를 만드는 데 집중한다.

    1. 최종 아키텍처

                         User
                          │
                       Upload
                          ↓
                       FastAPI
                          │
                ┌─────────┴─────────┐
                ↓                   ↓
          Object Storage       Redis Streams
                                    │
                                    ↓
                               Agent Worker
                                    │
                                    ↓
                             Agent Runtime
                             ┌──────┴──────┐
                             ↓             ↓
                         State Store   Orchestrator
                                           │
                                           ↓
                                      LLM Decision
                                           │
                                           ↓
                                       MCP Client
                                           │
                                           ↓
                                       MCP Server
                                           │
                        ┌──────────────────┼──────────────────┐
                        ↓                  ↓                  ↓
                  Document Tool      Analysis Tool      Business Tool
                        │                  │                  │
                        └──────────────────┼──────────────────┘
                                           ↓
                                      Service Layer
                                           │
                             ┌─────────────┼─────────────┐
                             ↓             ↓             ↓
                          Storage          DB        External API
    

    FastAPI는 파일 업로드와 Review API, Redis Streams는 Start/Resume Event, Worker는 Runtime 실행, Runtime은 State와 종료 조건, Orchestrator는 다음 행동, MCP는 Tool 연결, Service Layer는 실제 업무를 담당한다.

    2. 프로젝트 구조

    agent-backend/
    │
    ├── api/
    │   ├── upload.py
    │   └── review.py
    ├── agent/
    │   ├── runtime.py
    │   ├── orchestrator.py
    │   ├── state.py
    │   └── worker.py
    ├── mcp_server/
    │   └── server.py
    ├── services/
    │   ├── document_service.py
    │   ├── analysis_service.py
    │   ├── review_service.py
    │   └── erp_service.py
    ├── repositories/
    │   ├── agent_repository.py
    │   └── document_repository.py
    ├── infrastructure/
    │   ├── redis.py
    │   └── database.py
    └── main.py
    

    처음부터 Microservice로 나눌 필요는 없다. 하나의 Python 프로젝트 안에서도 책임을 분리해두면 나중에 필요한 부분만 독립시킬 수 있다.

    3. Agent State 정의

    from dataclasses import dataclass, field
    from typing import Any
    
    @dataclass
    class AgentState:
        run_id: str
        document_id: str
        status: str = "CREATED"
        step: int = 0
        last_tool: str | None = None
        retry_count: int = 0
        document_type: str | None = None
        confidence: float | None = None
        human_result: dict | None = None
        context: dict[str, Any] = field(default_factory=dict)
    

    State는 단순한 LLM 대화 기록이 아니라 Agent Runtime이 중단되고 다시 실행되어도 복구할 수 있는 시스템 상태다.

    4. State를 DB에 저장한다

    CREATE TABLE agent_runs (
        run_id VARCHAR(64) PRIMARY KEY,
        document_id VARCHAR(64) NOT NULL,
        status VARCHAR(32) NOT NULL,
        current_step INT NOT NULL DEFAULT 0,
        last_tool VARCHAR(100),
        retry_count INT NOT NULL DEFAULT 0,
        state_json JSON NOT NULL,
        created_at DATETIME NOT NULL,
        updated_at DATETIME NOT NULL
    );
    

    Tool 실행 이력도 별도로 저장한다.

    CREATE TABLE agent_steps (
        id BIGINT AUTO_INCREMENT PRIMARY KEY,
        run_id VARCHAR(64) NOT NULL,
        step_no INT NOT NULL,
        tool_name VARCHAR(100) NOT NULL,
        input_json JSON,
        output_json JSON,
        status VARCHAR(32) NOT NULL,
        error_message TEXT,
        started_at DATETIME NOT NULL,
        finished_at DATETIME,
        UNIQUE KEY uq_agent_step (run_id, step_no)
    );
    

    agent_runs는 현재 상태, agent_steps는 실행 이력을 담당한다.

    5. 파일 업로드 API

    from fastapi import APIRouter, UploadFile
    
    router = APIRouter()
    
    @router.post("/documents")
    async def upload_document(file: UploadFile):
        document = await document_service.save(file)
    
        run = await agent_service.create_run(
            document_id=document.id
        )
    
        await event_bus.publish_start(
            run_id=run.run_id,
            document_id=document.id,
        )
    
        return {
            "document_id": document.id,
            "run_id": run.run_id,
            "status": "QUEUED",
        }
    

    FastAPI가 직접 Agent를 실행하지 않는 것이 중요하다.

    HTTP Request
         ↓
    File Save
         ↓
    Agent Run 생성
         ↓
    Event Publish
         ↓
    HTTP Response
    

    6. Redis Streams에 START Event를 넣는다

    import redis.asyncio as redis
    
    redis_client = redis.Redis(
        host="localhost",
        port=6379,
        decode_responses=True,
    )
    
    async def publish_agent_start(run_id: str, document_id: str):
        await redis_client.xadd(
            "agent:events",
            {
                "event": "START",
                "run_id": run_id,
                "document_id": document_id,
            },
        )
    

    7. Consumer Group

    Stream: agent:events
            │
            ↓
    Consumer Group: agent-workers
            │
        ┌───┼───┐
        ↓   ↓   ↓
       W1  W2  W3
    
    async def ensure_consumer_group():
        try:
            await redis_client.xgroup_create(
                name="agent:events",
                groupname="agent-workers",
                id="0",
                mkstream=True,
            )
        except Exception as e:
            if "BUSYGROUP" not in str(e):
                raise
    

    실제 운영에서는 구체적인 Redis 예외 타입을 처리하는 편이 좋다.

    8. Agent Worker

    async def run_worker(worker_name: str):
        while True:
            messages = await redis_client.xreadgroup(
                groupname="agent-workers",
                consumername=worker_name,
                streams={"agent:events": ">"},
                count=10,
                block=5000,
            )
    
            for stream, entries in messages:
                for message_id, data in entries:
                    try:
                        await handle_event(data)
    
                        await redis_client.xack(
                            "agent:events",
                            "agent-workers",
                            message_id,
                        )
                    except Exception:
                        logger.exception("Agent event failed")
    

    Worker는 업무 규칙을 알 필요가 없다. Event를 받아 Runtime을 실행할 뿐이다.

    9. START와 RESUME Event

    async def handle_event(event):
        event_type = event["event"]
    
        if event_type == "START":
            state = await agent_repository.load(
                event["run_id"]
            )
            await agent_runtime.run(state)
            return
    
        if event_type == "RESUME":
            await resume_agent(event)
            return
    
        raise ValueError(f"Unknown event: {event_type}")
    

    10. MCP Tool은 기존 Service를 감싼다

    from mcp.server.fastmcp import FastMCP
    
    mcp = FastMCP("document-agent-tools")
    
    @mcp.tool()
    def get_document(document_id: str) -> dict:
        return document_service.get_document(document_id)
    
    @mcp.tool()
    def extract_document_content(document_id: str) -> dict:
        return document_service.extract_content(document_id)
    
    @mcp.tool()
    def analyze_invoice(document_id: str) -> dict:
        return analysis_service.analyze_invoice(document_id)
    
    @mcp.tool()
    def request_human_review(
        run_id: str,
        document_id: str,
        reason: str,
    ) -> dict:
        return review_service.create_review(
            run_id=run_id,
            document_id=document_id,
            reason=reason,
        )
    
    @mcp.tool()
    def create_erp_record(
        document_id: str,
        operation_id: str,
    ) -> dict:
        return erp_service.create_invoice(
            document_id=document_id,
            operation_id=operation_id,
        )
    

    MCP Server에는 Agent Runtime의 State 관리 코드를 넣지 않는다. Tool은 실제 업무 기능 제공에 집중한다.

    11. Orchestrator의 역할

    Orchestrator는 현재 State와 사용 가능한 MCP Tool을 보고 다음 행동을 결정한다.

    Current State
          +
    Available MCP Tools
          +
    System Instruction
          ↓
    LLM
          ↓
    Next Action
    

    예를 들어 System Instruction에는 다음과 같은 규칙을 넣을 수 있다.

    You process uploaded business documents.
    
    Use the available tools to analyze the document.
    
    Do not call write tools unless the result has been validated.
    
    If confidence is too low to safely continue,
    request human review.
    
    Never retry the same failed action indefinitely.
    
    Finish when the document has been successfully processed.
    

    하지만 Prompt만으로 모든 안전을 보장해서는 안 된다.

    Max Steps, Permission, Idempotency, Timeout 같은 제한은 Runtime 코드에서도 적용해야 한다.


    12. Decision 구조를 명시적으로 만든다

    LLM의 응답을 자유로운 문자열로 받기보다 구조화된 Decision으로 다루는 편이 좋다.

    from dataclasses import dataclass
    from typing import Any
    
    
    @dataclass
    class AgentDecision:
        action: str
    
        tool_name: str | None = None
        arguments: dict[str, Any] | None = None
    
        reason: str | None = None
    

    action은 다음 정도로 제한할 수 있다.

    TOOL
    FINISH
    HUMAN_REVIEW
    FAIL
    

    그러면 Runtime은 LLM의 자연어를 직접 해석하는 대신 명확한 상태를 기준으로 동작할 수 있다.


    13. Agent Runtime의 기본 Loop

    이제 핵심인 Runtime을 만들어보자.

    MAX_STEPS = 10
    
    
    class AgentRuntime:
    
        async def run(self, state: AgentState):
    
            state.status = "RUNNING"
    
            await agent_repository.save(state)
    
            while state.step < MAX_STEPS:
    
                decision = await orchestrator.decide(
                    state
                )
    
                if decision.action == "FINISH":
    
                    state.status = "COMPLETED"
    
                    await agent_repository.save(
                        state
                    )
    
                    return
    
                if decision.action == "FAIL":
    
                    state.status = "FAILED"
    
                    await agent_repository.save(
                        state
                    )
    
                    return
    
                if decision.action == "HUMAN_REVIEW":
    
                    await self.pause_for_human(
                        state,
                        decision,
                    )
    
                    return
    
                await self.execute_tool(
                    state,
                    decision,
                )
    
            state.status = "MAX_STEPS_EXCEEDED"
    
            await agent_repository.save(state)
    

    Runtime의 책임이 조금 더 명확해졌다.

    Orchestrator
        ↓
    무엇을 할지 결정
    
    Runtime
        ↓
    그 결정을 실행해도 되는지 통제
    
    MCP
        ↓
    실제 Tool 연결
    

    14. Tool 실행 전 Policy를 검사한다

    Agent가 Tool을 선택했다고 무조건 실행해서는 안 된다.

    예를 들어 다음과 같이 Tool을 분류할 수 있다.

    READ_TOOLS = {
        "get_document",
        "extract_document_content",
        "analyze_invoice",
    }
    
    WRITE_TOOLS = {
        "create_erp_record",
    }
    

    Write Tool에는 추가 검증을 적용한다.

    async def validate_tool_call(
        state,
        decision,
    ):
    
        if decision.tool_name == "create_erp_record":
    
            if state.human_result is None:
                raise PermissionError(
                    "Human approval is required"
                )
    
            if state.human_result["action"] != "APPROVE":
                raise PermissionError(
                    "Invoice was not approved"
                )
    

    LLM은 create_erp_record를 선택할 수 있다.

    하지만 실제 실행 권한은 Runtime이 결정한다.

    Tool Selection과 Tool Authorization은 서로 다른 문제다.


    15. MCP Tool을 실행한다

    개념적인 MCP Client 호출은 다음과 같다.

    async def call_mcp_tool(
        tool_name: str,
        arguments: dict,
    ):
    
        result = await mcp_client.call_tool(
            tool_name,
            arguments=arguments,
        )
    
        return result
    

    Runtime에서는 Tool 실행 전후로 Step을 기록한다.

    async def execute_tool(
        self,
        state,
        decision,
    ):
    
        await validate_tool_call(
            state,
            decision,
        )
    
        state.step += 1
    
        step = await agent_repository.start_step(
            run_id=state.run_id,
            step_no=state.step,
            tool_name=decision.tool_name,
            arguments=decision.arguments,
        )
    
        try:
    
            result = await call_mcp_tool(
                decision.tool_name,
                decision.arguments,
            )
    
            await agent_repository.complete_step(
                step.id,
                result=result,
            )
    
            state.last_tool = decision.tool_name
    
            self.apply_result(
                state,
                decision.tool_name,
                result,
            )
    
            await agent_repository.save(state)
    
        except Exception as e:
    
            await agent_repository.fail_step(
                step.id,
                error=str(e),
            )
    
            raise
    

    여기서 agent_repository.save(state)가 Checkpoint 역할을 한다.


    16. Tool Result를 State에 반영한다

    Tool마다 반환 결과가 다르다.

    예를 들어 analyze_invoice 결과가 다음과 같다고 하자.

    {
      "document_type": "invoice",
      "vendor": "ABC Corp",
      "amount": 12500000,
      "confidence": 0.58
    }
    

    State에 필요한 정보를 반영한다.

    def apply_result(
        self,
        state,
        tool_name,
        result,
    ):
    
        state.context[
            tool_name
        ] = result
    
        if tool_name == "analyze_invoice":
    
            state.document_type = (
                result["document_type"]
            )
    
            state.confidence = (
                result["confidence"]
            )
    

    전체 Tool Result를 LLM Context에 계속 쌓을 필요는 없다.

    DB에는 전체 이력을 보관하고, Orchestrator에는 현재 판단에 필요한 State만 전달하는 방식이 더 효율적이다.


    17. Invoice 분석 결과가 0.58이라면

    이제 실제 시나리오를 따라가 보자.

    Agent는 다음 순서로 Tool을 호출했다.

    Step 1
    get_document
          ↓
    SUCCESS
    
    Step 2
    extract_document_content
          ↓
    SUCCESS
    
    Step 3
    analyze_invoice
          ↓
    confidence = 0.58
    

    Orchestrator가 다음 Decision을 반환한다.

    {
      "action": "HUMAN_REVIEW",
      "reason": "Invoice analysis confidence is too low"
    }
    

    Runtime은 더 이상 Tool을 계속 호출하지 않는다.

    Human Review 상태로 전환한다.


    18. Human Review Task를 만든다

    async def pause_for_human(
        self,
        state,
        decision,
    ):
    
        review = await review_service.create(
            run_id=state.run_id,
            document_id=state.document_id,
            reason=decision.reason,
            data=state.context.get(
                "analyze_invoice"
            ),
        )
    
        state.status = "WAITING_HUMAN"
    
        state.context["review_id"] = (
            review.id
        )
    
        await agent_repository.save(state)
    

    여기서 중요한 부분은 마지막이다.

    return
    

    Runtime은 종료된다.

    Worker도 이 Event 처리를 끝낸다.

    Agent Runtime
          ↓
    WAITING_HUMAN
          ↓
    Checkpoint Save
          ↓
    return
          ↓
    Worker는 다음 Event 처리
    

    Agent가 몇 시간 동안 살아 있는 것이 아니다.

    Agent Run의 상태만 살아 있다.


    19. Human Review API

    담당자가 Review 화면에서 결과를 확인한다고 해보자.

    API는 다음과 같이 만들 수 있다.

    from pydantic import BaseModel
    
    
    class ReviewRequest(BaseModel):
        action: str
        edited_data: dict | None = None
    
    
    @router.post(
        "/reviews/{review_id}"
    )
    async def submit_review(
        review_id: str,
        request: ReviewRequest,
    ):
    
        review = await review_service.complete(
            review_id=review_id,
            action=request.action,
            edited_data=request.edited_data,
        )
    
        await event_bus.publish_resume(
            run_id=review.run_id,
            review_id=review.id,
        )
    
        return {
            "status": "ACCEPTED"
        }
    

    가능한 Action은 예를 들어 다음과 같다.

    APPROVE
    REJECT
    EDIT
    

    20. Resume Event를 Redis Streams에 넣는다

    async def publish_resume(
        run_id: str,
        review_id: str,
    ):
    
        await redis_client.xadd(
            "agent:events",
            {
                "event": "RESUME",
                "run_id": run_id,
                "review_id": review_id,
            },
        )
    

    Redis에는 다음과 같은 Event가 들어간다.

    XADD agent:events *
         event RESUME
         run_id run_123
         review_id review_123
    

    Worker 입장에서는 START와 RESUME 모두 그냥 Event다.


    21. Resume 처리

    async def resume_agent(event):
    
        state = await agent_repository.load(
            event["run_id"]
        )
    
        if state.status != "WAITING_HUMAN":
            return
    
        review = await review_service.get(
            event["review_id"]
        )
    
        state.human_result = {
            "action": review.action,
            "edited_data": review.edited_data,
        }
    
        state.status = "RUNNING"
    
        await agent_repository.save(state)
    
        await agent_runtime.run(state)
    

    이제 Agent는 5시간 전의 Python 프로세스가 아니다.

    새로운 Worker가 DB에서 State를 읽고 논리적인 Agent Run을 이어간다.


    22. REJECT라면 어떻게 할까?

    Human Review 결과가 REJECT라면 굳이 LLM에게 다시 물어볼 필요가 없을 수도 있다.

    if review.action == "REJECT":
    
        state.status = "FAILED"
    
        state.context[
            "failure_reason"
        ] = "Rejected by human"
    
        await agent_repository.save(state)
    
        return
    

    이것은 의미적 판단이 아니라 명확한 업무 규칙이다.

    코드가 처리하는 것이 더 좋다.


    23. EDIT라면 어떻게 할까?

    담당자가 Invoice 데이터를 수정했다고 해보자.

    {
      "action": "EDIT",
      "edited_data": {
        "vendor": "ABC Corporation",
        "amount": 12450000
      }
    }
    

    이 경우 State에 수정 결과를 넣고 Agent에게 다시 판단을 맡길 수 있다.

    if review.action == "EDIT":
    
        state.context[
            "human_edited_invoice"
        ] = review.edited_data
    

    Agent는 다음 단계에서 다시 Validation Tool을 호출하거나 ERP 등록을 선택할 수 있다.


    24. APPROVE라면 ERP 등록

    승인이 완료되면 다음 Tool을 호출할 수 있다.

    Human APPROVE
          ↓
    Agent Resume
          ↓
    create_erp_record
    

    하지만 ERP 등록은 Write Tool이다.

    반복 실행에 안전해야 한다.


    25. ERP Tool에 Idempotency를 적용한다

    operation_id를 Agent Run과 업무 작업을 조합해서 만든다.

    operation_id = (
        f"{state.run_id}:create_erp_record"
    )
    

    MCP Tool 호출은 다음과 같다.

    {
      "document_id": "doc_123",
      "operation_id": "run_123:create_erp_record"
    }
    

    ERP Service에서는 이미 처리한 Operation인지 확인한다.

    def create_invoice(
        document_id: str,
        operation_id: str,
    ):
    
        existing = operation_repository.find(
            operation_id
        )
    
        if existing:
            return existing.result
    
        result = erp_client.create_invoice(
            document_id
        )
    
        operation_repository.save(
            operation_id=operation_id,
            result=result,
        )
    
        return result
    

    Worker가 ERP 등록 직후 죽더라도 같은 operation_id로 다시 실행하면 중복 등록을 막을 수 있다.


    26. Redis Streams에서도 장애 복구를 생각해야 한다

    Consumer가 메시지를 읽은 뒤 XACK하기 전에 죽을 수 있다.

    XREADGROUP
         ↓
    Agent 실행
         ↓
    Worker Crash
         ↓
    XACK 못함
    

    이 메시지는 Pending 상태로 남는다.

    따라서 운영 환경에서는 Pending Entry를 감시하고 일정 시간 이상 처리되지 않은 메시지를 다른 Worker가 Claim하는 전략이 필요하다.

    개념적으로는 다음과 같다.

    Pending Message
          ↓
    Idle Time > Threshold
          ↓
    Claim
          ↓
    Another Worker
          ↓
    Resume Processing
    

    Redis Streams의 전달 보장과 Agent Tool의 Idempotency는 함께 생각해야 한다.

    Queue가 메시지를 다시 전달할 수 있기 때문이다.


    27. Runtime Retry와 Tool Retry를 구분한다

    OCR API가 일시적으로 실패하는 것은 Tool 내부에서 Retry할 수 있다.

    Technical Failure
          ↓
    Tool Retry
    

    반면 Invoice 분석 신뢰도가 낮아 다른 방법을 선택하는 것은 Agent의 판단이다.

    Semantic Failure
          ↓
    Agent Decision
    

    Runtime에서는 Tool의 결과를 보고 다음과 같이 처리할 수 있다.

    if result.get("retryable"):
    
        state.retry_count += 1
    
        if state.retry_count > 3:
            state.status = "FAILED"
    

    다만 네트워크 재시도와 의미적 재시도를 같은 Counter로 관리하지 않는 편이 더 명확하다.


    28. Loop Detection

    Max Steps만으로도 무한 실행은 막을 수 있지만 반복 패턴을 감지하면 더 빨리 중단할 수 있다.

    extract_document_content
    run_ocr
    extract_document_content
    run_ocr
    

    최근 Tool History를 확인한다.

    def has_repeating_pattern(
        history: list[str],
    ) -> bool:
    
        if len(history) < 4:
            return False
    
        last_four = history[-4:]
    
        return (
            last_four[0] == last_four[2]
            and
            last_four[1] == last_four[3]
        )
    

    Loop가 감지되면 Human Review로 보내거나 실패 처리할 수 있다.


    29. Agent Run을 어떻게 관찰할까?

    관리 화면에서는 최소한 다음 정도를 볼 수 있으면 좋다.

    Run ID
    Document
    Status
    Current Step
    Last Tool
    Started At
    Updated At
    LLM Calls
    Tool Calls
    Token Usage
    Estimated Cost
    Human Review
    Error
    

    하나의 Run을 클릭하면 Timeline을 보여줄 수 있다.

    10:00:01 START
    
    10:00:02 get_document
             SUCCESS
    
    10:00:03 extract_document_content
             SUCCESS
    
    10:00:05 analyze_invoice
             confidence = 0.58
    
    10:00:06 HUMAN_REVIEW
             WAITING
    
    15:14:22 HUMAN_APPROVE
    
    15:14:23 RESUME
    
    15:14:25 create_erp_record
             SUCCESS
    
    15:14:26 COMPLETED
    

    Agent 시스템에서는 이런 Timeline이 디버깅에 특히 유용하다.


    30. 비용도 Run 단위로 기록한다

    LLM을 여러 번 호출하는 Agent는 일반 API보다 비용 구조가 복잡하다.

    agent_usage
    
    run_id
    step_no
    model
    input_tokens
    output_tokens
    cost
    latency_ms
    

    그러면 다음과 같은 지표를 계산할 수 있다.

    Average Cost per Run
    
    Average LLM Calls per Run
    
    Average Tool Calls per Run
    
    Human Review Rate
    
    Completion Rate
    
    Average Steps
    
    P95 Run Duration
    

    Agent가 유연해졌지만 고정 Workflow보다 비용이 지나치게 증가하고 있지는 않은지 확인할 수 있다.

    31. 전체 실행 흐름을 다시 따라가 보자

    이제 처음부터 끝까지 한 번에 연결해보자.

    1단계 — Upload

    User
      ↓
    POST /documents
      ↓
    Object Storage
      ↓
    Document Record
      ↓
    Agent Run 생성
    

    State:

    {
      "run_id": "run_123",
      "document_id": "doc_123",
      "status": "CREATED",
      "step": 0
    }
    

    2단계 — START Event

    XADD agent:events *
         event START
         run_id run_123
    

    Worker가 Event를 읽는다.

    Redis Streams
          ↓
    Agent Worker
          ↓
    Load State
          ↓
    Agent Runtime
    

    3단계 — Document 처리

    get_document
          ↓
    extract_document_content
          ↓
    analyze_invoice
    

    결과:

    {
      "vendor": "ABC Corp",
      "amount": 12500000,
      "confidence": 0.58
    }
    

    4단계 — Human Review

    confidence = 0.58
          ↓
    HUMAN_REVIEW
          ↓
    Review Task 생성
          ↓
    Checkpoint
          ↓
    WAITING_HUMAN
          ↓
    Runtime 종료
    

    이 시점에 실행 중인 Agent 프로세스는 없다.

    DB에 논리적인 Agent Run만 남아 있다.

    5단계 — 5시간 뒤 승인

    Human
      ↓
    APPROVE
      ↓
    POST /reviews/review_123
    

    Resume Event가 발생한다.

    XADD agent:events *
         event RESUME
         run_id run_123
    

    6단계 — Resume

    Agent Worker
          ↓
    Load State
          ↓
    Load Human Result
          ↓
    RUNNING
          ↓
    Agent Runtime
    

    7단계 — ERP 등록

    create_erp_record
          ↓
    operation_id 확인
          ↓
    ERP API
          ↓
    SUCCESS
    

    8단계 — 완료

    {
      "run_id": "run_123",
      "document_id": "doc_123",
      "status": "COMPLETED",
      "last_tool": "create_erp_record"
    }
    

    최종 Timeline은 다음과 같다.

    Invoice Upload
          ↓
    Agent Start
          ↓
    get_document
          ↓
    extract_document_content
          ↓
    analyze_invoice
          ↓
    confidence = 0.58
          ↓
    Human Review
          ↓
    Checkpoint
          ↓
    WAITING_HUMAN
    
          ... 5시간 후 ...
    
    Human APPROVE
          ↓
    Resume Event
          ↓
    Load Checkpoint
          ↓
    Agent Resume
          ↓
    create_erp_record
          ↓
    COMPLETED
    

    32. 이 구조에서 Agent가 실제로 판단하는 것은 생각보다 많지 않다

    전체 시스템을 보면 Agent가 모든 것을 결정하는 것처럼 보일 수 있다.

    하지만 실제로 Agent가 판단할 영역을 다시 분리해보면 그렇지 않다.

    코드가 담당하는 영역:

    File Size Limit
    Authentication
    Authorization
    State Transition
    Max Steps
    Timeout
    Retry Limit
    Idempotency
    Consumer Recovery
    Unique Constraint
    Human Approval Policy
    

    Agent가 담당할 수 있는 영역:

    Document Classification
    Tool Selection
    OCR 필요 여부
    Alternative Analysis Strategy
    Semantic Validation
    Additional Analysis 필요 여부
    Human Review 필요 여부
    

    이 구분이 중요하다.

    LLM이 잘하는 것은 모호한 상황에서 의미를 해석하고 다음 행동을 선택하는 것이다.

    반면 시스템의 안전성과 일관성을 보장하는 것은 코드가 더 잘한다.


    33. “Agent가 알아서 한다”는 표현을 조심해야 한다

    Agent 시스템을 설명할 때 흔히 다음과 같이 표현한다.

    “Agent가 알아서 Tool을 선택하고 업무를 처리한다.”

    개념적으로는 맞다.

    하지만 운영 시스템에서는 조금 더 정확하게 표현하는 편이 좋다.

    Agent
        ↓
    허용된 범위 안에서
        ↓
    사용 가능한 Tool 중
        ↓
    현재 Context에 적합한 행동을 제안한다
        ↓
    Runtime Policy 검증
        ↓
    실행
    

    즉 Agent의 자유는 Runtime이 허용한 경계 안에서의 자유다.

    이 경계가 없다면 Agent는 자동화 시스템이 아니라 예측하기 어려운 프로그램이 될 수 있다.


    34. MCP를 사용하는 이유도 다시 명확해진다

    이번 시스템에서 MCP가 Agent Runtime을 만들어준 것은 아니다.

    Redis Streams를 대신한 것도 아니다.

    State Store를 제공한 것도 아니다.

    Human Review를 구현해준 것도 아니다.

    MCP가 담당한 것은 명확하다.

    Agent
      ↓
    "What can I do?"
      ↓
    MCP
      ↓
    Available Capabilities
    

    예를 들어 기존 백엔드에 다음 기능이 있었다.

    Document Service
    OCR Service
    Invoice Analyzer
    ERP Service
    Notification Service
    

    MCP를 통해 이것을 Agent가 사용할 수 있는 Capability로 제공했다.

    get_document
    run_ocr
    analyze_invoice
    create_erp_record
    send_notification
    

    MCP의 가치는 기존 백엔드의 능력을 Agent가 사용할 수 있는 공통 인터페이스로 연결하는 데 있다.


    35. 처음부터 모든 것을 MCP로 만들 필요도 없다

    기존 시스템에 REST API가 있다면 MCP Tool 내부에서 REST API를 호출해도 된다.

    Agent
      ↓
    MCP Tool
      ↓
    REST API
      ↓
    Existing Service
    

    같은 프로세스 안의 Service Layer를 직접 호출할 수도 있다.

    Agent
      ↓
    MCP Tool
      ↓
    Service Layer
      ↓
    Repository
    

    중요한 것은 기술을 많이 사용하는 것이 아니다.

    기존 시스템의 경계를 유지하면서 Agent에게 필요한 Capability를 제공하는 것이다.


    36. 실제 서비스로 확장한다면

    이번 예제를 Production 수준으로 확장한다면 다음 항목을 추가로 고려할 수 있다.

    Authentication / Authorization
    
    Tenant Isolation
    
    Tool Permission
    
    Secret Management
    
    Distributed Lock
    
    Pending Message Recovery
    
    Dead Letter Queue
    
    Rate Limit
    
    Circuit Breaker
    
    Structured Logging
    
    Tracing
    
    Metrics
    
    LLM Cost Tracking
    
    Prompt / Tool Versioning
    
    Agent Evaluation
    
    Human Review SLA
    
    Audit Log
    

    특히 Multi-Tenant SaaS라면 모든 Tool 호출에 Tenant Context를 명확하게 전달하고 서버 측에서 다시 검증해야 한다.

    Agent가 전달한 tenant_id를 그대로 신뢰해서는 안 된다.


    37. Agent Version도 기록하는 것이 좋다

    Agent Prompt와 Tool Description이 변경되면 같은 문서에서도 실행 결과가 달라질 수 있다.

    따라서 Run에 다음 정보를 기록하는 것이 좋다.

    {
      "agent_version": "1.3.0",
      "prompt_version": "invoice-v4",
      "toolset_version": "2026-09-01",
      "model": "example-model"
    }
    

    나중에 품질이 갑자기 달라졌을 때 어떤 변경 때문인지 추적하기 쉬워진다.

    Agent도 결국 운영되는 Software다.

    Versioning이 필요하다.


    38. 테스트는 어떻게 할까?

    Agent 시스템이라고 테스트를 LLM에게 맡길 수는 없다.

    계층별로 나누는 것이 좋다.

    Tool Test

    Input
     ↓
    Tool
     ↓
    Expected Output
    

    Tool 자체는 가능한 한 Deterministic하게 테스트한다.

    Runtime Test

    LLM Decision을 Mock으로 고정할 수 있다.

    Decision 1 = get_document
    Decision 2 = analyze_invoice
    Decision 3 = HUMAN_REVIEW
    

    그 상태에서 Runtime이 올바르게 State를 전환하는지 확인한다.

    Resume Test

    WAITING_HUMAN
          ↓
    APPROVE Event
          ↓
    RUNNING
          ↓
    COMPLETED
    

    Failure Test

    Tool Timeout
    Worker Crash
    Duplicate Event
    Duplicate Write
    Redis Redelivery
    Human Review Expired
    

    Happy Path보다 이런 테스트가 운영 환경에서는 더 중요할 수 있다.


    39. Agent Evaluation도 필요하다

    Runtime이 안정적이라고 Agent의 판단이 좋은 것은 아니다.

    다음 질문은 별도의 Evaluation 영역이다.

    올바른 Tool을 선택했는가?
    
    불필요한 Tool을 호출하지 않았는가?
    
    Human Review를 너무 자주 요청하지 않는가?
    
    잘못된 문서를 Invoice로 분류하지 않는가?
    
    비용 대비 충분히 좋은 결과를 내는가?
    

    따라서 두 가지 품질을 구분할 필요가 있다.

    Runtime Reliability
            +
    Agent Decision Quality
    

    둘 다 좋아야 실제 업무에서 사용할 수 있다.


    40. 최종 아키텍처

    이번 시리즈에서 만든 구조를 마지막으로 한 번 정리해보자.

                             ┌──────────────────┐
                             │       User       │
                             └────────┬─────────┘
                                      │
                                   Upload
                                      │
                                      ↓
                             ┌──────────────────┐
                             │     FastAPI      │
                             └────────┬─────────┘
                                      │
                         ┌────────────┴────────────┐
                         ↓                         ↓
                  Object Storage             Redis Streams
                                                   │
                                                   ↓
                                             Agent Worker
                                                   │
                                                   ↓
                                            Agent Runtime
                                      ┌────────────┼────────────┐
                                      ↓            ↓            ↓
                                   State      Orchestrator   Checkpoint
                                                   │
                                                   ↓
                                              LLM Decision
                                                   │
                                                   ↓
                                               MCP Client
                                                   │
                                                   ↓
                                               MCP Server
                                                   │
                                 ┌─────────────────┼─────────────────┐
                                 ↓                 ↓                 ↓
                             Document          Analysis          Business
                               Tools             Tools             Tools
                                 │                 │                 │
                                 └─────────────────┼─────────────────┘
                                                   ↓
                                              Service Layer
                                                   │
                                  ┌────────────────┼────────────────┐
                                  ↓                ↓                ↓
                               Storage          Database       External API
                                                                     │
                                                                     ↓
                                                                   ERP
    
    Human Review
         │
         └──────────→ Resume Event ──────────→ Redis Streams
    

    이 구조에서 Agent는 시스템 전체가 아니다.

    Agent는 기존 백엔드 위에 추가된 의사결정 계층이다.


    41. 이 시리즈에서 말하고 싶었던 것

    처음의 질문은 단순했다.

    파일이 업로드되면 Agent가 깨어나 알아서 분석하고 저장하도록 만들 수 없을까?

    가능하다.

    하지만 실제 시스템을 만들어보면 중요한 것은 “Agent가 얼마나 똑똑한가”만이 아니다.

    Event를 어떻게 전달할 것인가?
    
    State를 어디에 저장할 것인가?
    
    실패하면 어떻게 복구할 것인가?
    
    중복 실행을 어떻게 막을 것인가?
    
    사람이 필요하면 어떻게 멈출 것인가?
    
    몇 시간 뒤 어떻게 다시 시작할 것인가?
    
    Agent에게 어디까지 권한을 줄 것인가?
    
    무엇을 했는지 어떻게 추적할 것인가?
    

    결국 우리가 다시 만나게 되는 것은 익숙한 백엔드 엔지니어링 문제들이다.

    Queue, State, Retry, Idempotency, Timeout, Authorization, Observability, Recovery.

    Agent가 등장했다고 이 문제들이 사라지는 것은 아니다.

    오히려 Agent의 실행 경로가 동적으로 변하기 때문에 더 중요해진다.


    42. 가장 중요한 원칙

    이 시리즈를 한 문장으로 정리한다면 다음과 같다.

    Agent에게 판단을 맡기되, 실행의 통제권까지 모두 넘기지는 않는다.

    코드가 잘하는 것은 코드에게 맡긴다.

    Permission
    Timeout
    Retry Limit
    Idempotency
    State Transition
    Validation
    

    Agent가 잘하는 것은 Agent에게 맡긴다.

    Semantic Understanding
    Tool Selection
    Contextual Decision
    Alternative Strategy
    Human Review 판단
    

    그리고 MCP가 그 둘 사이에서 기존 백엔드의 Capability를 Agent에게 연결한다.

    Backend Capability
            ↓
           MCP
            ↓
          Agent
    

    이렇게 보면 Agent 시스템은 기존 백엔드와 완전히 다른 새로운 세계가 아니다.

    우리가 이미 알고 있는 Backend Architecture 위에 LLM 기반 의사결정 계층을 추가하는 것에 가깝다.


    시리즈를 마치며

    Part 1에서는 Worker에서 Agent Orchestrator로 넘어가는 이유를 살펴봤다.

    Part 2에서는 Python으로 MCP Tool을 만들었다.

    Part 3에서는 Agent Loop, State, Retry, Checkpoint, Human-in-the-Loop을 통해 운영 가능한 Agent Runtime을 설계했다.

    그리고 이번 Part 4에서는 그것들을 하나로 연결했다.

    Part 1
    Why Agent?
    
            ↓
    
    Part 2
    How to build MCP Tools?
    
            ↓
    
    Part 3
    How to run Agents safely?
    
            ↓
    
    Part 4
    How to connect everything?
    

    처음에는 단순한 Worker였다.

    File
     ↓
    Worker
     ↓
    Result
    

    마지막에는 다음 구조가 되었다.

    Event
     ↓
    Agent Runtime
     ↓
    Decision
     ↓
    MCP Tool
     ↓
    Existing Backend
     ↓
    State / Human / Recovery
    

    Agent를 실제 업무에 연결하는 순간부터 중요한 것은 멋진 Demo가 아니다.

    실패해도 복구되고, 중복 실행에도 안전하고, 사람이 개입할 수 있으며, 어떤 판단과 실행이 있었는지 추적할 수 있는 시스템을 만드는 것이다.

    그 위에서 Agent의 판단 능력이 비로소 실제 비즈니스의 자동화 능력이 된다.
  • AI Agent & MCP 3부 — MCP Tool을 Agent에게 맡기면 정말 더 좋은가?

    AI Agent & MCP 3부 — MCP Tool을 Agent에게 맡기면 정말 더 좋은가?

    Agent Loop, 상태 관리, Retry 그리고 Human-in-the-Loop

    1부에서는 Worker에서 Agent Orchestrator로 확장하는 이유를 살펴봤고, 2부에서는 Python 백엔드 기능을 MCP Tool로 제공했다.

    이제 Agent에게 get_document, extract_document_content, run_ocr, analyze_document, save_analysis, request_human_review 같은 능력이 생겼다.

    그렇다면 Agent에게 “이 문서를 알아서 처리해”라고 하면 끝일까?

    개발 데모에서는 가능하다. 하지만 운영 환경에서는 여기서부터 진짜 문제가 시작된다.

    같은 Tool을 반복 호출하면?
    잘못된 Tool을 선택하면?
    Tool이 실패하면?
    Worker가 죽으면?
    이미 저장한 데이터를 다시 저장하면?
    사람의 승인이 필요하면?
    5시간 뒤 승인되면 어디서부터 다시 시작할까?
    

    MCP Tool을 만드는 것과 운영 가능한 Agent 시스템을 만드는 것은 다른 문제다.


    1. Agent의 본질은 Loop다

    가장 단순한 Agent 실행 구조는 다음과 같다.

            ┌──────────────────┐
            │                  │
            ↓                  │
       LLM Decision            │
            ↓                  │
         Tool Call             │
            ↓                  │
        Tool Result ───────────┘
    

    현재 State와 Tool 목록을 LLM에게 전달하고, LLM이 다음 Tool을 선택하고, 실행 결과를 다시 State에 넣는다.

    async def run_agent(state):
        while True:
            decision = await llm.decide(
                state=state,
                tools=available_tools,
            )
    
            if decision.type == "finish":
                return state
    
            result = await call_tool(
                name=decision.tool_name,
                arguments=decision.arguments,
            )
    
            state.add_tool_result(
                tool_name=decision.tool_name,
                result=result,
            )
    

    문제는 while True다. 실행 경로가 코드에 고정되어 있지 않기 때문에 Runtime이 Agent의 행동을 제한해야 한다.

    2. 반드시 종료 조건이 있어야 한다

    COMPLETED
    FAILED
    WAITING_HUMAN
    MAX_STEPS_EXCEEDED
    TIMEOUT
    

    예를 들어 최대 Step을 제한한다.

    MAX_STEPS = 10
    
    async def run_agent(state):
        while state.step < MAX_STEPS:
            decision = await decide_next_action(state)
    
            if decision.type == "finish":
                state.status = "COMPLETED"
                return state
    
            result = await execute_tool(decision)
            state.add_result(result)
            state.step += 1
    
        state.status = "MAX_STEPS_EXCEEDED"
        return state
    

    Agent에게 판단의 자유를 주더라도 실행 범위까지 무제한으로 주어서는 안 된다.

    3. Max Steps만으로 충분하지 않다

    다음처럼 같은 패턴을 반복할 수도 있다.

    extract_document_content
            ↓
    run_ocr
            ↓
    extract_document_content
            ↓
    run_ocr
            ↓
    ...
    

    따라서 Loop Detection도 필요하다.

    중요한 것은 Agent가 계속 행동하고 있다는 사실과 문제를 해결하고 있다는 사실은 다르다는 점이다.

    4. Tool 실패와 Agent 실패는 다르다

    Tool Failure
         ↓
    Recoverable?
       ┌────┴────┐
       ↓         ↓
      YES        NO
       ↓         ↓
    Retry /     Agent
    Alternative FAILED
    

    예를 들어 일시적인 OCR 오류는 복구 가능할 수 있다.

    {
      "success": false,
      "reason": "OCR_TEMPORARY_ERROR",
      "retryable": true
    }
    

    지원하지 않는 파일 형식은 재시도해도 의미가 없을 수 있다.

    {
      "success": false,
      "reason": "UNSUPPORTED_FILE_FORMAT",
      "retryable": false
    }
    

    5. Retry는 Agent가 할까, Tool이 할까?

    네트워크 Timeout이나 일시적인 5xx 오류까지 LLM에게 판단시킬 필요는 없다.

    async def run_ocr(document_id):
        for attempt in range(3):
            try:
                return await ocr_client.analyze(document_id)
            except TemporaryError:
                if attempt == 2:
                    raise
                await asyncio.sleep(2 ** attempt)
    

    반면 분석 결과의 신뢰도가 낮아 다른 Analyzer나 Human Review를 선택하는 것은 의미적 판단이다.

    Technical Retry
          ↓
    Tool / Service Layer
    
    Semantic Retry
          ↓
    Agent / Orchestrator
    

    6. Timeout도 계층별로 나눈다

    HTTP Timeout
    LLM Timeout
    Tool Timeout
    Agent Step Timeout
    Agent Run Timeout
    Human Review Timeout
    

    Human Review는 일반 Timeout과 다르다. 몇 시간 동안 프로세스를 붙잡아 두는 대신 Workflow를 Pause하는 편이 좋다.

    7. Agent에게 State가 필요한 이유

    {
      "run_id": "run_123",
      "document_id": "doc_123",
      "status": "RUNNING",
      "step": 3,
      "last_tool": "analyze_document",
      "document_type": "invoice",
      "confidence": 0.58,
      "retry_count": 0
    }
    

    Agent Runtime은 이 State를 기준으로 다음 행동을 결정한다.

    8. State와 LLM Context는 같은 것이 아니다

    LLM Context
    - System Prompt
    - Tool Definitions
    - Previous Tool Results
    - Current Task
    
    Runtime State
    - run_id
    - status
    - step
    - retry_count
    - last_tool
    - checkpoint
    - document_id
    

    LLM Context는 모델의 판단을 위한 정보이고, Runtime State는 시스템이 Agent 실행을 관리하고 복구하기 위한 정보다.

    9. State는 메모리에만 두면 안 된다

    Worker가 죽어도 복구하려면 중요한 State를 외부 저장소에 기록해야 한다.

    agent_runs
    - run_id
    - document_id
    - status
    - current_step
    - last_tool
    - retry_count
    - created_at
    - updated_at
    
    agent_steps
    - id
    - run_id
    - step_no
    - tool_name
    - input
    - output
    - status
    - started_at
    - finished_at
    - error
    

    10. Checkpoint를 만든다

    Tool Execute
         ↓
    Tool Result
         ↓
    Save Checkpoint
         ↓
    Next Decision
    

    Worker가 죽으면 새 Worker가 마지막 Checkpoint를 불러와 Resume할 수 있다.

    Worker Crash
         ↓
    New Worker
         ↓
    Load run_123
         ↓
    Last Checkpoint
         ↓
    Resume
    

    11. Resume은 생각보다 어렵다

    다음 상황을 보자.

    Step 5
    save_analysis
          ↓
    Database INSERT 성공
          ↓
    Worker Crash
          ↓
    Checkpoint 저장 실패
    

    DB에는 데이터가 있지만 State에는 성공 기록이 없다. 새 Worker는 save_analysis를 다시 호출할 수 있다.

    그래서 Write Tool의 Idempotency가 중요하다.

    12. Agent 시스템의 Idempotency

    예를 들어 operation_id를 사용한다.

    {
      "operation_id": "run_123_step_5",
      "document_id": "doc_123"
    }
    

    DB에서 operation_id를 Unique하게 관리하면 재호출 시 이전 결과를 반환할 수 있다.

    First Call
    run_123_step_5
          ↓
    INSERT
          ↓
    SUCCESS
    
    Second Call
    run_123_step_5
          ↓
    Already Processed
          ↓
    Return Previous Result
    

    13. Human-in-the-Loop가 들어오면 구조가 달라진다

    Invoice 분석 결과가 다음과 같다고 해보자.

    {
      "document_type": "invoice",
      "confidence": 0.58,
      "amount": 12500000
    }
    

    Agent는 Human Review를 선택한다.

    analyze_invoice
          ↓
    confidence = 0.58
          ↓
    request_human_review
    

    사람이 10초 뒤 응답할지, 5시간 뒤 응답할지 알 수 없다. Worker를 계속 실행한 채 기다리는 것은 비효율적이다.

    14. Human Review에서는 Agent를 Pause한다

    Agent
      ↓
    request_human_review
      ↓
    Create Review Task
      ↓
    Save Checkpoint
      ↓
    status = WAITING_HUMAN
      ↓
    Worker 종료
    

    State는 다음처럼 저장할 수 있다.

    {
      "run_id": "run_123",
      "document_id": "doc_123",
      "status": "WAITING_HUMAN",
      "current_step": 5,
      "last_tool": "request_human_review",
      "confidence": 0.58
    }
    

    이 상태에서는 Agent 프로세스가 존재할 필요가 없다.

    15. 사람이 승인하면 Event가 Agent를 다시 깨운다

    5시간 뒤 담당자가 승인했다고 해보자.

    Human
      ↓
    Approve
      ↓
    Review API
      ↓
    Event
    

    Redis Streams를 사용한다면 다음과 같은 Resume Event를 만들 수 있다.

    XADD agent:resume *
         run_id run_123
         action approved
    
    Redis Stream
          ↓
    Agent Worker
          ↓
    Load run_123
          ↓
    Resume Agent
    

    파일 업로드 Event가 Agent를 처음 깨웠듯이 Human Approval Event가 Agent를 다시 깨운다.

    16. Pause와 Resume을 코드로 생각해보자

    async def run_agent(state):
        while True:
            decision = await decide_next_action(state)
    
            if decision.type == "human_review":
                await create_review_task(state)
    
                state.status = "WAITING_HUMAN"
                await save_checkpoint(state)
    
                return
    
            result = await execute_tool(decision)
    
            state.add_result(result)
            await save_checkpoint(state)
    

    사람의 응답이 들어오면 별도 Handler가 실행된다.

    async def resume_agent(run_id, human_result):
        state = await load_state(run_id)
    
        state.human_result = human_result
        state.status = "RUNNING"
    
        await save_checkpoint(state)
        await run_agent(state)
    

    핵심은 await human_response()로 몇 시간 동안 기다리지 않는다는 것이다.

    State를 저장하고 프로세스를 종료한 뒤 Event가 들어오면 다시 실행한다.

    17. Human Review에도 Timeout이 필요하다

    사람이 영원히 응답하지 않을 수도 있다.

    {
      "review_id": "review_123",
      "run_id": "run_123",
      "status": "WAITING",
      "expires_at": "2026-09-14T12:00:00"
    }
    

    만료되면 EXPIRED로 바꾸거나 담당자에게 재알림을 보낼 수 있다.

    WAITING_HUMAN
          ↓
    TTL / Deadline
          ↓
    Expired?
     ┌────┴────┐
     ↓         ↓
    NO        YES
     ↓         ↓
    Wait    Re-notify / EXPIRED
    

    18. Human Review 결과도 구조화해야 한다

    단순히 “승인”만 있는 것은 아니다.

    APPROVE
    REJECT
    EDIT
    

    EDIT라면 사람이 수정한 데이터도 함께 반환할 수 있다.

    {
      "action": "EDIT",
      "data": {
        "vendor": "OpenAI Korea",
        "amount": 12500000
      }
    }
    

    Agent는 Human Result를 새로운 State로 받아 다음 작업을 이어간다.

    19. Agent가 Resume될 때 LLM을 다시 호출해야 할까?

    항상 그럴 필요는 없다.

    사람의 승인 이후 다음 행동이 명확하다면 코드가 바로 실행할 수도 있다.

    Human APPROVE
          ↓
    Policy
          ↓
    create_erp_record
    

    반대로 사람이 수정한 내용에 따라 추가 검증이 필요하다면 Agent에게 다시 판단을 맡길 수 있다.

    Human EDIT
          ↓
    Agent
          ↓
    Validate Again?
          ↓
    Next Tool
    

    여기에서도 같은 원칙이 적용된다.

    결정적인 규칙은 코드가 처리하고, 의미적 판단이 필요한 지점에서 Agent를 사용한다.

    20. Agent의 상태 머신을 명시적으로 만들어보자

    Agent를 자유로운 Loop로만 생각하지 않고 상태 머신으로 보는 것도 유용하다.

    CREATED
       ↓
    RUNNING
       ├──→ COMPLETED
       ├──→ FAILED
       ├──→ WAITING_HUMAN
       │         ↓
       │       RESUME
       │         ↓
       └────── RUNNING
    

    예를 들어 다음 상태를 정의할 수 있다.

    CREATED
    RUNNING
    WAITING_HUMAN
    COMPLETED
    FAILED
    EXPIRED
    CANCELLED
    

    상태 전이를 명확하게 정의하면 운영과 장애 복구가 쉬워진다.

    21. Tool 실행과 Agent Decision을 모두 기록한다

    Tool 실행 기록뿐 아니라 Agent가 어떤 결정을 내렸는지도 추적할 필요가 있다.

    run_123
    
    Step 1
    Decision: get_document
    Result: SUCCESS
    
    Step 2
    Decision: extract_document_content
    Result: SUCCESS
    
    Step 3
    Decision: analyze_invoice
    Result: confidence 0.58
    
    Step 4
    Decision: request_human_review
    Result: WAITING
    
    5 hours later
    
    Step 5
    Human: APPROVE
    
    Step 6
    Decision: create_erp_record
    Result: SUCCESS
    

    이런 실행 이력은 디버깅, 감사, 비용 분석, Agent 품질 평가에 모두 도움이 된다.

    22. Observability에서 봐야 할 것

    일반 API의 latency와 error rate만으로는 충분하지 않다.

    Agent Run Count
    Completion Rate
    Failure Rate
    Average Steps
    Tool Calls per Run
    LLM Calls per Run
    Average Run Duration
    Human Review Rate
    Retry Rate
    Loop Detection Count
    Tool Error Rate
    Token Usage
    Cost per Run
    

    예를 들어 Human Review 비율이 지나치게 높다면 Agent Prompt나 Analyzer 품질에 문제가 있을 수 있다.

    평균 Step이 갑자기 증가한다면 Agent가 불필요한 Tool을 호출하기 시작했을 수도 있다.

    23. Agent의 비용도 Runtime 문제다

    Agent Loop에서는 LLM 호출이 여러 번 발생할 수 있다.

    Decision 1 → LLM
    Tool
    Decision 2 → LLM
    Tool
    Decision 3 → LLM
    Tool
    Decision 4 → LLM
    

    따라서 Run 단위로 다음을 기록하는 것이 좋다.

    input_tokens
    output_tokens
    llm_calls
    tool_calls
    model
    total_cost
    

    Agent가 더 유연하다는 이유만으로 고정 Workflow보다 훨씬 많은 비용을 사용하고 있지는 않은지 확인해야 한다.

    24. 모든 Tool Result를 LLM Context에 계속 넣어야 할까?

    Agent가 오래 실행되면 Context가 계속 커질 수 있다.

    Step 1 Result
    Step 2 Result
    Step 3 Result
    ...
    Step 30 Result
    

    Runtime State와 LLM Context를 분리하면 이 문제를 다루기 쉬워진다.

    DB에는 전체 이력을 보관하되 LLM에는 현재 판단에 필요한 요약된 State만 전달할 수 있다.

    Full History
        ↓
    Database
    
    Relevant State
        ↓
    LLM Context
    

    이것은 비용과 Context Window 관리에도 중요하다.

    25. MCP Server는 Agent Runtime이 아니다

    역할을 다시 구분해보자.

    Agent Runtime
    - State
    - Loop
    - Retry
    - Pause / Resume
    - Checkpoint
    
    Orchestrator
    - Next Action 결정
    - Tool 선택
    
    MCP
    - Tool 연결
    - Tool Schema
    - Tool 호출
    
    Tool
    - 실제 업무 수행
    

    MCP가 Agent의 상태를 저장하거나 Workflow를 복구해주는 것은 아니다.

    MCP는 Capability Interface이고, Agent Runtime은 실행 엔진이다.

    이 둘을 구분해야 아키텍처가 명확해진다.

    26. 전체 Runtime 구조

                        Event
                          │
                          ↓
                     Agent Worker
                          │
                          ↓
                    Load / Create State
                          │
                          ↓
                     Agent Runtime
                          │
                  ┌───────┴───────┐
                  ↓               ↓
             Orchestrator       State Store
                  │
                  ↓
              LLM Decision
                  │
                  ↓
               MCP Client
                  │
                  ↓
               MCP Server
                  │
                  ↓
                 Tool
                  │
                  ↓
              Service Layer
                  │
                  ↓
            External Systems
    

    Tool Result가 돌아오면 Checkpoint를 저장하고 다음 Decision을 수행한다.

    27. Invoice 예제로 전체 흐름을 따라가 보자

    사용자가 Invoice PDF를 업로드한다.

    Invoice Upload
          ↓
    FastAPI
          ↓
    Object Storage
          ↓
    Redis Stream
          ↓
    Agent Worker
    

    Agent Run을 생성한다.

    {
      "run_id": "run_123",
      "document_id": "doc_123",
      "status": "RUNNING",
      "step": 0
    }
    

    Agent가 문서를 조회한다.

    Step 1
    get_document
          ↓
    SUCCESS
    

    내용을 추출한다.

    Step 2
    extract_document_content
          ↓
    SUCCESS
    

    Invoice를 분석한다.

    Step 3
    analyze_invoice
          ↓
    confidence = 0.58
    

    신뢰도가 낮다.

    Step 4
    request_human_review
          ↓
    WAITING_HUMAN
    

    Checkpoint를 저장하고 Worker는 종료된다.

    28. 5시간 뒤

    담당자가 검토 화면에서 내용을 확인한다.

    금액과 거래처가 맞다.

    Human
      ↓
    APPROVE
    

    Resume Event가 발생한다.

    XADD agent:resume *
         run_id run_123
         action APPROVE
    

    새 Worker가 State를 읽는다.

    Load run_123
          ↓
    status = WAITING_HUMAN
          ↓
    human_result = APPROVE
          ↓
    status = RUNNING
    

    이제 다음 작업을 실행한다.

    create_erp_record
          ↓
    SUCCESS
    

    최종 State를 저장한다.

    {
      "run_id": "run_123",
      "document_id": "doc_123",
      "status": "COMPLETED",
      "last_tool": "create_erp_record"
    }
    

    전체 흐름은 다음과 같다.

    Invoice Upload
          ↓
    Agent Start
          ↓
    Extract
          ↓
    Analyze
          ↓
    Confidence = 0.58
          ↓
    Human Review
          ↓
    Agent Pause
    
          ... 5시간 후 ...
    
    Human Approve
          ↓
    Resume Event
          ↓
    Agent Resume
          ↓
    ERP Registration
          ↓
    Completed
    

    이제 Agent는 단순히 LLM이 Tool 몇 개를 호출하는 프로그램이 아니다.

    29. 실제 운영에서는 Agent를 “오래 실행되는 함수”로 만들지 않는다

    다음과 같은 구현은 피하는 편이 좋다.

    async def process_invoice():
        result = await analyze()
    
        human_result = await wait_for_human()
    
        await register_erp(human_result)
    

    wait_for_human()이 5시간 동안 Worker를 붙잡고 있을 수 있기 때문이다.

    대신 실행을 작은 구간으로 나눈다.

    Execution Segment 1
    Upload → Analyze → Human Review
                     ↓
                   PAUSE
    
    Execution Segment 2
    Human Event → Resume → ERP
    

    Agent Run이라는 논리적 실행은 계속되지만 실제 프로세스는 필요할 때만 살아난다.

    30. Queue와 Agent는 경쟁 관계가 아니다

    Agent를 도입했다고 Redis Streams나 SQS가 필요 없어지는 것은 아니다.

    오히려 Event Driven Architecture와 잘 결합된다.

    Upload Event
         ↓
    Agent Start
    
    Human Event
         ↓
    Agent Resume
    
    Retry Event
         ↓
    Agent Retry
    
    Timeout Event
         ↓
    Agent Expire
    

    Queue는 언제 실행할 것인가를 전달하고 Agent는 실행된 뒤 무엇을 할 것인가를 판단한다.

    31. 어디까지 Agent에게 맡겨야 할까?

    다음은 코드가 처리하는 편이 좋다.

    Permission Check
    File Size Limit
    Retry Count Limit
    Unique Constraint
    Timeout
    State Transition Validation
    Idempotency
    

    다음은 Agent가 개입할 가치가 있다.

    Document Classification
    Tool Selection
    Alternative Analysis Strategy
    Semantic Validation
    Additional Information 필요 여부
    Human Review 필요 여부
    

    Agent를 많이 사용하는 것이 좋은 아키텍처는 아니다.

    불확실성이 있는 곳에만 Agent를 넣는 것이 더 중요하다.

    32. Agent Runtime에서 최소한 필요한 안전장치

    운영 시스템이라면 최소한 다음을 고려해야 한다.

    Max Steps
    Loop Detection
    Tool Timeout
    Agent Run Timeout
    Retry Policy
    Idempotency
    State Persistence
    Checkpoint
    Tool Permission
    Human Approval
    Audit Log
    Observability
    Cost Tracking
    

    이것들이 없으면 Agent는 똑똑한 자동화 도구가 아니라 예측하기 어려운 백엔드 프로세스가 될 수 있다.

    33. 결국 Agent는 새로운 형태의 Workflow Runtime이다

    전통적인 Workflow는 실행 경로가 미리 정해져 있다.

    A → B → C → D
    

    Agent Workflow는 일부 경로가 런타임에 결정된다.

                 ┌→ B → D
                 │
    A → Agent ───┼→ C → E
                 │
                 └→ Human → F
    

    하지만 운영 시스템의 관점에서는 여전히 State, Retry, Timeout, Checkpoint, Resume, Audit이 필요하다.

    즉 Agent가 기존 Workflow Engine의 문제를 없애는 것이 아니다.

    오히려 Workflow Runtime 위에 LLM 기반 의사결정을 추가한다고 보는 편이 정확하다.

    34. 1부부터 다시 연결해보자

    1부의 시작은 아주 단순했다.

    File Upload
        ↓
    Worker
        ↓
    Analyze
        ↓
    Save
    

    업무가 복잡해지면서 판단을 분리했다.

    File Upload
        ↓
    Agent Orchestrator
        ↓
    Tools
    

    2부에서는 Tool을 MCP로 제공했다.

    Agent
      ↓
    MCP Client
      ↓
    MCP Server
      ↓
    Tools
    

    3부에서는 Agent가 실제 운영 환경에서 살아남기 위한 Runtime을 추가했다.

                      Agent Runtime
                           │
            ┌──────────────┼──────────────┐
            ↓              ↓              ↓
          State        Orchestrator    Checkpoint
                           │
                           ↓
                          MCP
                           │
                           ↓
                         Tools
                           │
            ┌──────────────┼──────────────┐
            ↓              ↓              ↓
          Retry          Human          Audit
                         Review
    

    이제 처음의 단순한 Worker가 꽤 다른 형태의 시스템으로 발전했다.

    마치며

    MCP Tool을 Agent에게 연결하는 것 자체는 어렵지 않다.

    어려운 것은 Agent에게 자유를 준 이후다.

    언제 멈출 것인가?
    실패하면 어떻게 복구할 것인가?
    같은 Tool을 다시 호출해도 안전한가?
    Worker가 죽으면 어디서 다시 시작할 것인가?
    사람을 기다려야 하면 어떻게 Pause할 것인가?
    몇 시간 뒤 어떻게 Resume할 것인가?
    Agent가 무엇을 했는지 어떻게 추적할 것인가?
    비용이 얼마나 들었는지 어떻게 알 것인가?
    

    이 문제들을 해결하면서 Agent는 단순한 Tool Calling 프로그램에서 상태를 가진 Workflow Runtime으로 바뀐다.

    그리고 여기서 중요한 원칙은 하나다.

    Agent에게 판단을 맡기되, 실행의 통제권까지 모두 넘기지는 않는다.

    LLM은 의미적 판단과 Tool 선택에 강점이 있다.

    반면 Timeout, Retry Limit, Idempotency, Permission, State Transition 같은 규칙은 코드가 더 잘한다.

    둘을 적절하게 결합하는 것이 운영 가능한 Agent 시스템의 핵심이다.

    다음 글

    4부 — Agent Runtime을 실제 Python 코드로 만들어보기

    Redis Streams + State Store + MCP로 Pause/Resume 가능한 Agent 구현

    다음 편에서는 지금까지의 개념을 실제 코드 구조로 내려볼 수 있다.

    FastAPI
       ↓
    Redis Streams
       ↓
    Agent Worker
       ↓
    Agent Runtime
       ├── State Store
       ├── Orchestrator
       └── MCP Client
              ↓
           MCP Server
              ↓
            Tools
    

    그리고 다음 시나리오를 실제 구현 대상으로 삼을 수 있다.

    Invoice Upload
          ↓
    Agent 실행
          ↓
    분석
          ↓
    Human Review 요청
          ↓
    WAITING_HUMAN
          ↓
    Worker 종료
    
          ... 승인 Event ...
    
    Agent Resume
          ↓
    ERP 등록
          ↓
    COMPLETED
    

    여기까지 구현하면 지금까지 설명한 Agent Architecture가 실제 동작하는 백엔드 프로그램의 형태를 갖추게 된다.

  • AI Agent & MCP 1부 — 파일이 업로드되면 Agent가 깨어난다

    AI Agent & MCP 1부 — 파일이 업로드되면 Agent가 깨어난다

    Worker에서 Agent Orchestrator로

    백엔드에서 흔한 요구사항이 있다.

    사용자가 파일을 업로드하면 자동으로 분석하고 결과를 저장한다.

    처음에는 단순하다.

    File Upload
        ↓
    Worker
        ↓
    Parse
        ↓
    Analyze
        ↓
    Save
    def process_document(document_id):
        file = download_file(document_id)
        text = parse_document(file)
        result = analyze_document(text)
        save_result(document_id, result)

    처리 과정이 항상 같다면 이 구조가 가장 단순하다. 문제는 시스템이 발전하면서 파일 종류와 업무 규칙이 늘어날 때 시작된다.

    1. 처음에는 Worker 하나면 충분했다

    처음에는 PDF만 처리했지만 Excel, 이미지, 스캔 PDF가 추가될 수 있다.

    if file_type == "pdf":
        text = parse_pdf(file)
    elif file_type == "xlsx":
        data = parse_excel(file)
    elif file_type in ["jpg", "png"]:
        data = analyze_image(file)
    
    if not text:
        text = run_ocr(file)

    여기까지는 관리할 만하다. 하지만 요구사항은 계속 늘어난다.

    2. 어려운 것은 “다음에 무엇을 해야 하는가”다

    Invoice라면 텍스트 추출뿐 아니라 금액, 거래처, 날짜, 통화, 세금 등을 추출하고 검증해야 한다.

    File Upload
         ↓
    Parse
         ↓
    Invoice Detection
         ↓
    Invoice Extraction
         ↓
    Validation

    신뢰도가 높으면 저장한다. 낮으면 재분석, 다른 모델, OCR 또는 Human Review가 필요할 수 있다.

                        ┌── Save
                        │
    Analysis → Decision ├── Retry
                        ├── Another Model
                        └── Human Review

    문제는 이제 “파일을 어떻게 처리할까?”가 아니라 “현재 상태에서 다음에 무엇을 실행할까?”가 된다.

    3. Workflow와 Agent의 차이

    실행 순서가 명확한 RAG 적재 파이프라인을 생각해보자.

    Upload → Parse → Chunk → Embedding → Vector DB

    이런 작업에는 Agent가 필요하지 않다. 코드나 Redis Streams, RabbitMQ, SQS 같은 Queue 기반 Workflow가 더 단순하고 예측 가능하다.

    반대로 처리 경로를 미리 결정하기 어렵다면 이야기가 달라진다.

    4. 처리 경로를 미리 결정하기 어려운 경우

                         ┌── PDF Parser
                         ├── Excel Analyzer
    File Upload → 판단 ──┼── OCR
                         ├── Vision Model
                         └── Invoice Extractor

    분석 이후에도 판단이 이어진다.

    Analyze
       ↓
    Validate
       ↓
    Decision
       ├── Save
       ├── Retry
       ├── Additional Analysis
       └── Human Review

    물론 if/elif로도 만들 수 있다. 하지만 조건이 계속 늘어나면 Worker는 단순 실행 프로그램이 아니라 거대한 의사결정 프로그램이 된다.

    5. Worker에게서 “판단”을 분리한다

                     Orchestrator
                          │
                  "무엇을 해야 하지?"
                          │
              ┌───────────┼───────────┐
              ↓           ↓           ↓
           Parser      Analyzer     Database

    Orchestrator는 직접 PDF를 분석하거나 DB에 저장하지 않는다. 현재 상황을 보고 어떤 작업을 실행할지 결정한다.

    Orchestrator
        ├── get_document
        ├── extract_text
        ├── analyze_document
        ├── extract_invoice
        ├── validate_invoice
        ├── save_analysis
        └── request_human_review

    이 Orchestrator가 Agent 역할을 한다.

    6. Agent를 “생각하는 Worker”라고 생각해보자

    기존 Worker는 개발자가 정한 순서를 실행한다.

    A → B → C → D

    Agent는 현재 상태를 보고 사용할 작업을 선택한다.

              ┌── B
    A → Agent ├── C
              └── D

    Invoice 분석 결과의 신뢰도가 높다면 저장하고 낮다면 Human Review로 보낼 수 있다. 같은 시스템에서도 런타임 상태에 따라 실행 경로가 달라진다.

    7. Agent는 실제 기능을 어떻게 호출할까?

    Python 함수를 Agent 코드에서 직접 호출할 수도 있다. 하지만 기능이 많아질수록 Agent와 실제 업무 기능이 강하게 결합된다.

    Agent Application
    │
    ├── Agent Logic
    ├── PDF Parser
    ├── OCR
    ├── Invoice Analyzer
    ├── Database
    └── Human Review

    그래서 질문이 생긴다.

    Agent가 사용할 기능을 독립적인 Tool로 제공할 수 없을까?

    이 지점에서 MCP가 등장한다.

    8. MCP를 이용해 Agent와 Tool을 분리한다

                  ┌─────────────────────┐
                  │     Orchestrator    │
                  │        Agent        │
                  └──────────┬──────────┘
                             │
                            MCP
                             │
            ┌────────────────┼────────────────┐
            ↓                ↓                ↓
        File Tools        AI Tools        Data Tools
        get_document      classify        save_result
        extract_text      summarize       update_status
        run_ocr           extract_info    get_analysis

    Agent는 Tool 내부 구현을 알 필요가 없다. 어떤 Tool이 존재하고, 무엇을 하며, 어떤 입력과 출력을 갖는지가 중요하다.

    9. MCP는 Agent의 “능력 목록”을 제공한다

    기존 REST API가 다른 프로그램이 사용할 기능을 제공하는 인터페이스라면, MCP Tool은 Agent가 발견하고 선택해서 사용할 수 있는 능력을 제공하는 인터페이스라고 볼 수 있다.

    Tool: extract_invoice
    
    Description:
    Extract structured invoice information from a document.
    
    Input:
    {
      "document_id": "string"
    }
    
    Output:
    {
      "vendor": "string",
      "amount": "number",
      "currency": "string",
      "confidence": "number"
    }

    Agent는 Tool 이름과 Description, Schema를 보고 사용할 기능을 판단한다.

    10. 모든 함수를 MCP Tool로 만들 필요는 없다

    다음 같은 내부 함수까지 Agent에게 제공할 필요는 적다.

    normalize_string
    calculate_hash
    convert_datetime
    remove_whitespace

    반면 다음은 Agent가 선택할 가치가 있다.

    analyze_document
    extract_invoice
    search_documents
    request_human_review
    save_analysis

    함수(Function)와 Agent Tool은 같은 것이 아니다. Tool은 Agent가 선택할 가치가 있는 행동 단위여야 한다.

    11. 파일 업로드가 Agent를 깨운다

    Agent가 계속 파일 업로드를 감시할 필요는 없다. 기존 Event Driven Architecture를 활용하면 된다.

    User
      │ Upload
      ↓
    FastAPI
      ├── Object Storage
      └── Event
            ↓
       Redis Streams
            ↓
       Agent Worker

    예를 들어 다음 이벤트가 Agent 실행의 시작점이 된다.

    XADD document:uploaded * document_id 12345
    Redis Stream
          ↓
    Agent Worker
          ↓
    Orchestrator
          ↓
    MCP Client
          ↓
    MCP Server
          ↓
    Tools

    즉 Agent가 파일을 감시하는 것이 아니라 Event가 Agent를 깨우는 것이다.

    12. 전체 아키텍처

                        User
                          │
                       Upload
                          ↓
                      FastAPI
                          │
                 ┌────────┴────────┐
                 ↓                 ↓
           Object Storage       Redis Stream
                                   │
                                   ↓
                             Agent Worker
                                   │
                                   ↓
                             Orchestrator
                                   │
                                MCP Client
                                   │
                                   ↓
                               MCP Server
                                   │
              ┌────────────────────┼────────────────────┐
              ↓                    ↓                    ↓
          File Tools           AI Tools            Data Tools

    FastAPI는 요청과 파일 저장, Queue는 이벤트 전달, Agent Worker는 Agent 실행, Orchestrator는 다음 행동 결정, MCP Server는 Tool 제공, Tool은 실제 업무 수행을 담당한다.

    13. 기존 Workflow는 없어지는가?

    그렇지 않다. 중요한 것은 어디까지 Workflow로 만들고 어디부터 Agent에게 맡길 것인가다.

    Upload
      ↓
    Virus Scan
      ↓
    Store File
      ↓
    Create Document
      ↓
    Publish Event
      ↓
    ────────────────────────
           Agent 영역
      ↓
    Agent Orchestrator
      ├── PDF Parser
      ├── OCR
      ├── Excel Analyzer
      ├── Vision Analyzer
      └── Invoice Extractor
              ↓
           Validate
              ↓
      ┌───────┼────────┐
      ↓       ↓        ↓
     Save    Retry   Human Review

    항상 실행되는 작업은 Workflow가 더 적합하다.

    14. Agent가 모든 것을 직접 처리할 필요는 없다

    Agent의 핵심 역할은 실행보다 판단과 조정(Orchestration) 이다.

    실제 작업은 Tool이 담당한다.

                     Agent
                       │
                 Decision Making
                       │
            ┌──────────┼──────────┐
            ↓          ↓          ↓
          Tool       Tool       Tool
       parse_pdf    run_ocr   save_result

    15. 기존 서비스를 버리고 MCP를 다시 만드는 것은 아니다

    기존 Service Layer를 그대로 활용할 수 있다.

    Agent
      ↓
    MCP Tool
      ↓
    Existing Service
      ↓
    Database / Storage / AI

    MCP는 기존 백엔드를 대체하기보다 Agent가 기존 백엔드 기능을 사용할 수 있도록 새로운 인터페이스를 추가하는 것에 가깝다.

    16. MCP Tool의 경계가 중요하다

    get_file_path, calculate_hash, normalize_filename 같은 내부 함수를 모두 Tool로 노출하기보다 다음처럼 의미 있는 업무 단위로 묶는 편이 좋다.

    prepare_document
    extract_document_content
    analyze_invoice
    validate_analysis
    save_analysis
    request_human_review

    Tool은 함수의 단위가 아니라 Agent가 선택할 수 있는 행동의 단위다.

    17. MCP를 사용한다고 시스템이 자동으로 좋아지는 것은 아니다

    모든 문서가 항상 Parse → Chunk → Embedding → Save 순서로 처리된다면 Agent에게 다음 행동을 물어볼 이유가 없다.

    Agent를 넣으면 LLM 호출 비용, 지연시간, 장애 지점과 예측 불가능성이 늘어날 수 있다.

    따라서 먼저 물어봐야 한다.

    이 시스템에는 정말 ‘판단’이 필요한가?

    18. Agent + MCP가 유리한 상황

    다음 특징이 있다면 검토할 가치가 있다.

    • 입력 종류가 PDF, Excel, Image, Invoice, Contract처럼 다양하다.
    • 분석 결과에 따라 Save, Retry, Additional Analysis, Human Review 등 다음 행동이 달라진다.
    • OCR, Vision, ERP, Email, Slack 등 사용할 기능이 계속 증가한다.
    • 업무 규칙이 복잡해져 단순한 고정 Workflow로 표현하기 어려워진다.

    이런 지점에서 Agent Orchestrator의 가치가 생긴다.

    19. 결국 중요한 것은 “판단”과 “실행”의 분리다

    기존 Worker
     ├── Decision
     └── Execution

    Agent 기반 구조에서는 이를 분리한다.

                 Orchestrator
                      │
                  Decision
                      │
                      ↓
                     MCP
                      │
            ┌─────────┼─────────┐
            ↓         ↓         ↓
          Tool      Tool      Tool
                     Execution

    실제 비즈니스 로직은 기존 Service가 담당할 수도 있다.

    Agent
      ↓
    Orchestrator
      ↓
    MCP Tool
      ↓
    Service
      ↓
    Infrastructure

    20. Agent는 Workflow를 없애는 기술이 아니다

    Queue도, Worker도, Redis Streams나 RabbitMQ, SQS도 여전히 유용하다. Database와 Service Layer도 그대로 존재한다.

    달라지는 것은 일부 영역에서 Agent가 현재 상황을 보고 실행할 Tool을 선택한다는 점이다.

    Developer
        ↓
    Available Tools
        ↓
    Agent
        ↓
    Runtime Decision

    Agent는 Workflow를 없애는 기술이 아니라, Workflow를 미리 결정하기 어려운 지점에 들어가는 기술이다.

    그리고 MCP는 그 Agent가 사용할 수 있는 능력을 Tool 형태로 제공하는 방법 중 하나다.

    마치며

    처음에는 단순했다.

    File Upload
        ↓
    Worker
        ↓
    Analyze
        ↓
    Save

    하지만 업무가 복잡해지면서 처리 과정에 판단이 들어오기 시작했다.

                         ┌── OCR
                         ├── PDF Parser
    File Upload → Agent ─┼── Vision
                         ├── Invoice Analyzer
                         └── Human Review

    판단과 실제 실행을 분리하면 다음 구조를 생각할 수 있다.

    File Upload
         ↓
    Event
         ↓
    Agent Worker
         ↓
    Orchestrator
         ↓
    MCP
         ↓
    Tools

    이제 다음 질문이 자연스럽게 생긴다.

    실제 Python 백엔드 기능을 어떻게 MCP Tool로 만들 수 있을까?

    다음 글에서는 Python으로 MCP Server를 만들고, 기존 Service를 MCP Tool로 노출하고, Tool의 Input/Output Schema를 정의하는 방법을 살펴본다.

    다음 글

    2부 — Python으로 파일 분석용 MCP Tool 직접 만들어보기

    Agent
      ↓
    MCP Client
      ↓
    MCP Server
      ├── get_document
      ├── extract_document_content
      ├── analyze_document
      └── save_analysis

    그리고 “그냥 Python 함수를 호출하는 것과 MCP Tool을 사용하는 것은 무엇이 다른가?”라는 문제까지 이어서 살펴본다.

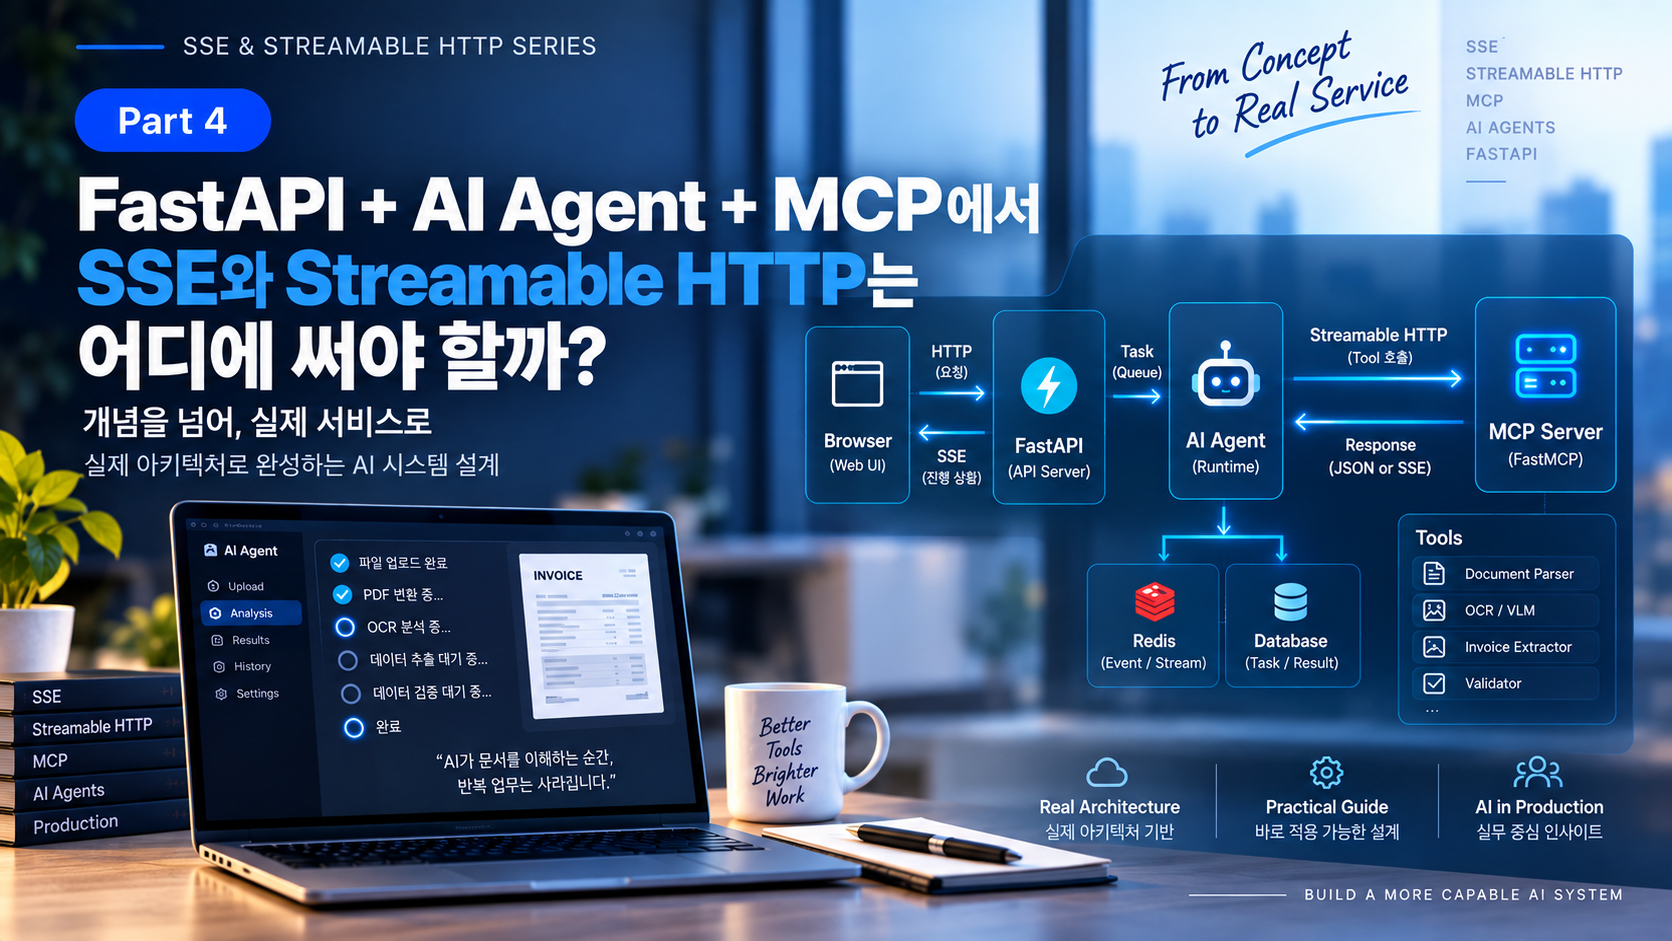
  • SSE와 Streamable HTTP 4부 — FastAPI + AI Agent + MCP에서 SSE와 Streamable HTTP는 어디에 써야 할까?

    SSE와 Streamable HTTP 4부 — FastAPI + AI Agent + MCP에서 SSE와 Streamable HTTP는 어디에 써야 할까?

    지금까지 세 편에 걸쳐 SSE와 Streamable HTTP의 구조를 살펴봤습니다.

    1부에서는 하나의 HTTP Response가 어떻게 데이터를 조금씩 전달할 수 있는지 알아봤습니다.

    Request
       │
       ▼
    Response
       │
       ├── data
       ├── data
       ├── data
       └── end

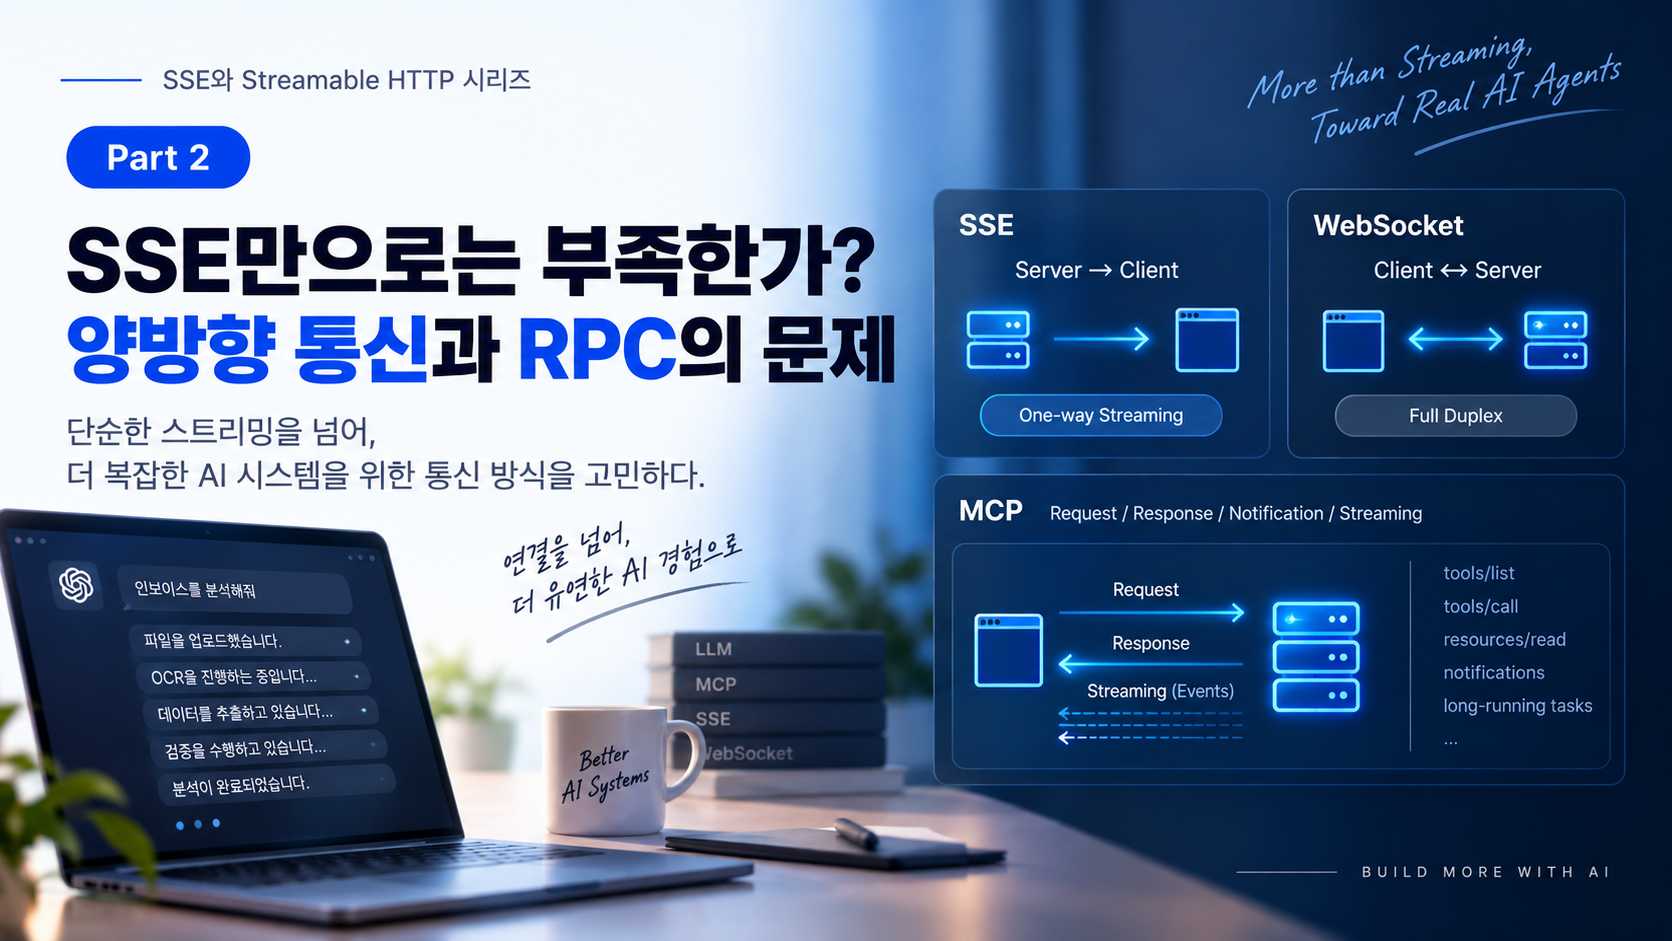
    2부에서는 SSE만으로 모든 통신 문제를 해결할 수 없다는 것을 살펴봤습니다.

    AI Agent와 같은 복잡한 시스템에서는 단순한 데이터 스트리밍을 넘어 다음과 같은 메시지 관계를 처리해야 합니다.

    Request
    Response
    Notification
    Streaming
    Session

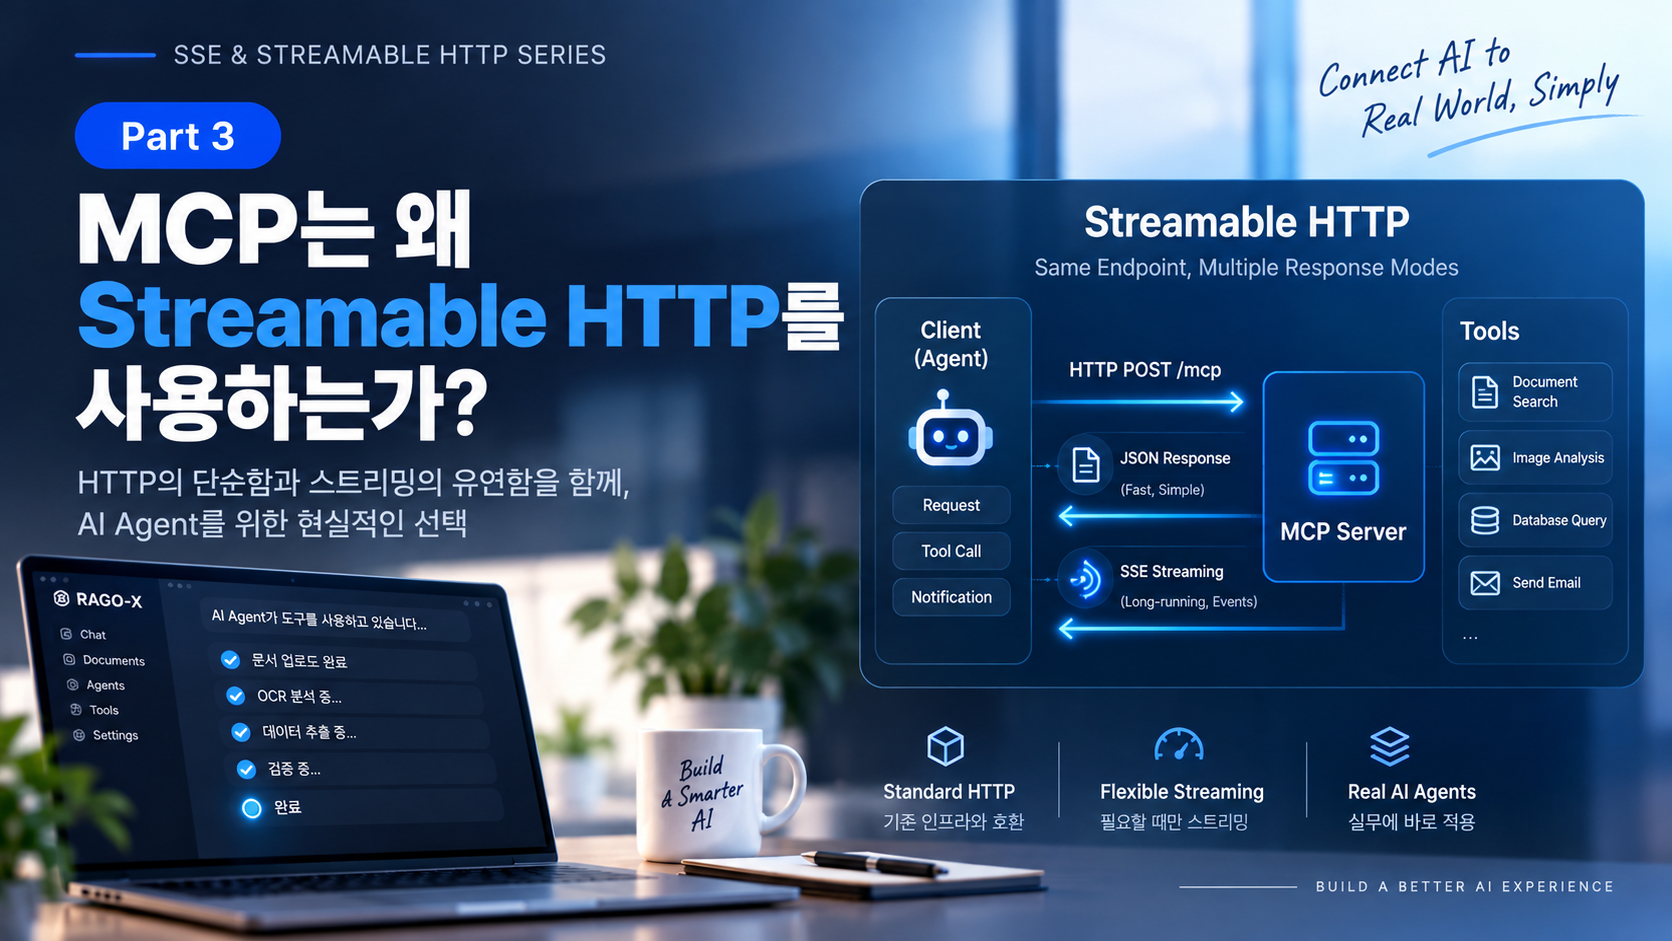
    3부에서는 MCP가 왜 Streamable HTTP를 사용하는지 살펴봤습니다.

    HTTP Request / Response
              +
    필요할 때 Streaming
              =
    Streamable HTTP

    그렇다면 이제 실제 시스템을 만들어봅시다.

    이번 글에서는 사용자가 웹에서 인보이스를 업로드하면 AI Agent가 MCP Tool을 이용해 데이터를 추출하는 서비스를 예제로 사용하겠습니다.

    여기서 중요한 질문은 이것입니다.

    Browser, FastAPI, Agent, MCP Server 사이에서 SSE와 Streamable HTTP를 각각 어디에 사용해야 할까?


    1. 우리가 만들 시스템

    사용자가 웹 화면에서 PDF 또는 이미지 인보이스를 업로드한다고 가정해보겠습니다.

    Browser
    
    [ invoice.pdf ]
    
    [ 자동 입력 ]

    사용자가 자동 입력 버튼을 누르면 서버에서 다음 작업이 실행됩니다.

    파일 업로드
        │
        ▼
    문서 분석
        │
        ▼
    OCR / VLM
        │
        ▼
    필드 추출
        │
        ▼
    검증
        │
        ▼
    결과 반환

    최종적으로 다음과 같은 구조화된 데이터를 얻고 싶습니다.

    {
      "invoice_number": "INV-2026-001",
      "invoice_date": "2026-09-15",
      "vendor": "ABC Corporation",
      "total_amount": 1250.00,
      "currency": "USD"
    }

    그리고 Browser는 이 값을 화면의 입력 필드에 자동으로 채웁니다.

    Invoice Number : INV-2026-001
    
    Invoice Date   : 2026-09-15
    
    Vendor         : ABC Corporation
    
    Total Amount   : 1,250.00
    
    Currency       : USD

    사용자 입장에서는 단순한 기능입니다.

    하지만 내부에서는 여러 컴포넌트가 동작할 수 있습니다.


    2. 전체 아키텍처부터 그려보자

    시스템을 다음과 같이 구성해보겠습니다.

    ┌──────────────┐
    │   Browser    │
    │    Web UI    │
    └──────┬───────┘
           │
           │ HTTP
           ▼
    ┌──────────────┐
    │   FastAPI    │
    │     API      │
    └──────┬───────┘
           │
           ▼
    ┌──────────────┐
    │    Agent     │
    │   Runtime    │
    └──────┬───────┘
           │
           │ MCP
           ▼
    ┌──────────────┐
    │  MCP Server  │
    └──────┬───────┘
           │
           ├── Document Parser
           │
           ├── OCR / VLM
           │
           ├── Invoice Extractor
           │
           └── Validator

    각 컴포넌트의 역할은 다릅니다.

    Browser
    
    사용자 인터페이스
    
    
    FastAPI
    
    외부 API Endpoint
    
    
    Agent Runtime
    
    작업 판단 및 Tool orchestration
    
    
    MCP Server
    
    Agent가 사용할 Tool 제공

    여기서 중요한 것은 모든 구간에 같은 통신 방식을 사용할 필요가 없다는 것입니다.


    3. Browser → FastAPI는 일반 HTTP로 시작한다

    사용자가 파일을 업로드합니다.

    Browser
       │
       │ POST /invoices/analyze
       ▼
    FastAPI

    예를 들어 다음과 같은 API가 있을 수 있습니다.

    @app.post("/invoices/analyze")
    async def analyze_invoice(file: UploadFile):
        ...

    파일 업로드 자체는 일반적인 HTTP Request입니다.

    POST /invoices/analyze
    
    Content-Type: multipart/form-data

    여기서 굳이 WebSocket이나 SSE를 사용할 이유는 없습니다.

    Browser가 서버에게 명확한 요청을 보내는 동작이기 때문입니다.

    Browser ───── Request ─────> FastAPI

    4. 그런데 분석에 20초가 걸린다면?

    문제는 그다음입니다.

    인보이스 분석이 다음 과정을 거친다고 해보겠습니다.

    PDF Rendering        2 sec
           │
           ▼
    OCR / VLM            8 sec
           │
           ▼
    Field Extraction     6 sec
           │
           ▼
    Validation           4 sec

    총 20초입니다.

    가장 단순한 구현은 20초 동안 기다렸다가 결과를 반환하는 것입니다.

    Browser                         FastAPI
       │                               │
       │──── POST /analyze ───────────>│
       │                               │
       │                               │
       │          20 seconds           │
       │                               │
       │                               │
       │<──── JSON Result ─────────────│

    기술적으로 문제는 없습니다.

    하지만 사용자 경험은 좋지 않습니다.

    화면에서는 20초 동안 이런 상태만 보일 수 있습니다.

    분석 중...
    
    ████████████████

    사용자는 궁금해집니다.

    정상적으로 처리되고 있는 건가?
    
    서버가 멈춘 건가?
    
    파일 업로드가 실패한 건가?
    
    AI가 아직 분석하고 있는 건가?

    그래서 진행 상황을 보여주고 싶어집니다.


    5. 이 구간에서 SSE가 유용하다

    Browser가 받고 싶은 정보는 대부분 서버에서 발생합니다.

    파일 업로드 완료
    
    PDF 변환 중
    
    OCR 분석 중
    
    필드 추출 중
    
    데이터 검증 중
    
    완료

    통신 방향을 보면 명확합니다.

    FastAPI ───────────────────> Browser

    즉 Server → Client입니다.

    이런 상황은 SSE가 잘하는 영역입니다.

    Browser <══════ SSE ══════ FastAPI

    예를 들어 서버가 다음과 같은 이벤트를 보낼 수 있습니다.

    event: progress
    data: {"step":"rendering"}
    
    event: progress
    data: {"step":"ocr"}
    
    event: progress
    data: {"step":"extracting"}
    
    event: progress
    data: {"step":"validating"}
    
    event: completed
    data: {"status":"completed"}

    Browser에서는 이 이벤트를 받아 화면을 업데이트할 수 있습니다.

    ✓ 파일 업로드
    
    ✓ PDF 변환
    
    ● OCR 분석 중...
    
    ○ 필드 추출
    
    ○ 데이터 검증

    사용자는 시스템이 실제로 무엇을 하고 있는지 알 수 있습니다.


    6. FastAPI에서 SSE Endpoint 만들기

    개념적으로 다음과 같은 Endpoint를 만들 수 있습니다.

    from fastapi.responses import StreamingResponse
    
    
    @app.get("/tasks/{task_id}/events")
    async def task_events(task_id: str):
    
        async def event_generator():
    
            async for event in get_task_events(task_id):
    
                yield (
                    f"event: {event.type}\n"
                    f"data: {event.json()}\n\n"
                )
    
        return StreamingResponse(
            event_generator(),
            media_type="text/event-stream"
        )

    Browser는 이 Endpoint에 연결합니다.

    const source = new EventSource(
        `/tasks/${taskId}/events`
    );
    
    source.addEventListener(
        "progress",
        (event) => {
            console.log(event.data);
        }
    );

    이제 서버에서 이벤트가 발생할 때마다 Browser가 받을 수 있습니다.

    FastAPI
    
    yield progress
          │
          ▼
    Browser
    
    UI Update

    7. 여기서 중요한 설계 포인트

    한 가지 중요한 점이 있습니다.

    SSE가 실제 분석 작업을 수행하는 것은 아닙니다.

    SSE ≠ Worker

    SSE는 작업 결과나 상태를 전달하는 통신 채널일 뿐입니다.

    실제 작업은 Agent 또는 Worker가 수행할 수 있습니다.

    FastAPI
       │
       │ enqueue
       ▼
    Agent Worker
       │
       │ processing
       ▼
    MCP Server

    그리고 Worker가 작업 상태를 저장하거나 이벤트를 발행합니다.

    예를 들어 Redis를 사용할 수 있습니다.

    Agent Worker
         │
         │ progress event
         ▼
    Redis
         │
         ▼
    FastAPI
         │
         │ SSE
         ▼
    Browser

    전체 흐름은 다음과 같습니다.

    Browser
       │
       │ HTTP
       ▼
    FastAPI
       │
       │ enqueue
       ▼
    Worker
       │
       │ progress
       ▼
    Redis
       │
       ▼
    FastAPI
       │
       │ SSE
       ▼
    Browser

    즉 SSE를 사용한다고 해서 HTTP Endpoint에서 긴 작업을 직접 수행해야 하는 것은 아닙니다.


    8. 이제 Agent가 등장한다

    FastAPI는 분석 요청을 Agent에게 전달합니다.

    FastAPI
       │
       ▼
    Agent Runtime

    Agent의 역할은 단순히 OCR을 실행하는 것이 아닐 수 있습니다.

    예를 들어 다음과 같이 판단할 수 있습니다.

    파일 형식 확인
         │
         ▼
    PDF인가?
         │
         ├── Yes → PDF Parser
         │
         └── No
              │
              ▼
            Image?
              │
              ▼
            OCR / VLM

    그리고 결과에 따라 다른 Tool을 선택할 수 있습니다.

    Agent
      │
      ├── parse_document()
      │
      ├── extract_invoice()
      │
      └── validate_invoice()

    이 Tool들이 MCP Server에 있다고 가정해보겠습니다.


    9. Agent → MCP Server에서는 통신의 성격이 달라진다

    Agent가 MCP Tool을 호출합니다.

    Agent
      │
      │ tools/call
      ▼
    MCP Server

    예를 들어 다음과 같은 호출입니다.

    extract_invoice("invoice.pdf")

    이것은 Browser에게 진행 상태를 알려주는 것과 성격이 다릅니다.

    여기서는 명확한 RPC 관계가 있습니다.

    Request
    
    "extract_invoice를 실행해줘"
    
            ↓
    
    MCP Server
    
            ↓
    
    Response
    
    "추출 결과는 이것이야"

    즉 핵심은 Server → Client 스트리밍이 아니라,

    Request
       ↓
    Tool Execution
       ↓
    Response

    입니다.

    이 구간에서 Streamable HTTP가 자연스럽습니다.


    10. Streamable HTTP로 Tool 호출하기

    전체 구조를 단순화하면 다음과 같습니다.

    Agent                         MCP Server
      │                               │
      │──── POST /mcp ───────────────>│
      │                               │
      │       Tool Execution          │
      │                               │
      │<──── JSON Response ───────────│

    빠르게 끝나는 Tool이라면 일반 JSON Response면 충분합니다.

    예를 들어:

    get_vendor_info()

    같은 Tool이 100ms 안에 끝난다면 굳이 스트리밍할 이유가 없습니다.

    POST /mcp
        │
        ▼
    Tool
        │
        ▼
    JSON Response

    이것이 Streamable HTTP의 장점 중 하나입니다.

    모든 Tool 호출을 Streaming으로 만들 필요가 없습니다.


    11. 오래 걸리는 Tool이라면?

    이번에는 extract_invoice()가 15초 걸린다고 해보겠습니다.

    extract_invoice()
           │
           ▼
    Rendering
           │
           ▼
    VLM
           │
           ▼
    Extraction
           │
           ▼
    Validation

    필요하다면 서버는 스트리밍 Response를 사용할 수 있습니다.

    Agent                         MCP Server
      │                               │
      │──── POST /mcp ───────────────>│
      │                               │
      │<════ SSE Stream ══════════════│
      │<──── message ─────────────────│
      │<──── message ─────────────────│
      │<──── result ──────────────────│

    즉 같은 Streamable HTTP에서도 상황에 따라 다르게 처리할 수 있습니다.

                     Tool Call
                         │
                         ▼
                    MCP Server
                         │
               ┌─────────┴─────────┐
               │                   │
               ▼                   ▼
          빠른 작업             긴 작업
               │                   │
               ▼                   ▼
        JSON Response          SSE Stream

    12. 이제 두 종류의 Streaming이 보인다

    여기서 재미있는 부분이 나타납니다.

    우리 시스템에는 두 종류의 Streaming이 존재할 수 있습니다.

    첫 번째는:

    FastAPI ───── SSE ─────> Browser

    목적은 사용자 경험입니다.

    "분석 시작"
    
    "OCR 진행 중"
    
    "추출 중"
    
    "완료"

    두 번째는:

    MCP Server ─── Stream ───> Agent

    목적은 Agent와 Tool Server 사이의 프로토콜 통신입니다.

    둘 다 내부적으로 SSE를 사용할 수 있지만 목적은 전혀 다릅니다.

    Browser SSE
    
    목적:
    사용자에게 진행 상황 전달
    
    
    MCP Streaming
    
    목적:
    Agent와 MCP Server 사이 메시지 전달

    이 차이를 이해하는 것이 중요합니다.


    13. 전체 데이터 흐름을 다시 그려보자

    이제 전체 시스템을 하나의 그림으로 연결해보겠습니다.

    ┌──────────────┐
    │   Browser    │
    └──────┬───────┘
           │
           │ POST /analyze
           ▼
    ┌──────────────┐
    │   FastAPI    │
    └──────┬───────┘
           │
           │ Task
           ▼
    ┌──────────────┐
    │ Agent Worker │
    └──────┬───────┘
           │
           │ Streamable HTTP
           ▼
    ┌──────────────┐
    │  MCP Server  │
    └──────┬───────┘
           │
           ├── OCR / VLM
           ├── Extractor
           └── Validator

    그리고 사용자에게 진행 상황을 전달하는 별도의 흐름이 있습니다.

    Agent Worker
          │
          │ progress
          ▼
        Redis
          │
          ▼
       FastAPI
          │
          │ SSE
          ▼
       Browser

    두 흐름을 합치면 다음과 같습니다.

                             Streamable HTTP
                     ┌──────────────────────────┐
                     │                          ▼
    Browser ───> FastAPI ───> Agent Worker ───> MCP Server
       ▲                            │                │
       │                            │                ├── OCR
       │                            │                ├── Parser
       │                            │                └── Validator
       │                            │
       │                            │ progress
       │                            ▼
       │                          Redis
       │                            │
       └────────── SSE ─────────────┘

    이 그림이 이번 글의 핵심입니다.


    14. Redis는 왜 중간에 넣을까?

    Agent Worker에서 바로 Browser로 SSE를 보내면 되지 않을까요?

    Agent Worker ─────> Browser

    작은 시스템이라면 가능할 수 있습니다.

    하지만 운영 환경에서는 Worker와 Web API를 분리하는 경우가 많습니다.

    Web API
    
    Worker #1
    
    Worker #2
    
    Worker #3

    Browser는 FastAPI에 연결되어 있지만 실제 작업은 Worker #2가 수행하고 있을 수 있습니다.

    Browser
       │
       ▼
    FastAPI
    
    Worker #2

    두 프로세스는 서로 다른 서버에 있을 수도 있습니다.

    그래서 중간에 이벤트 전달 계층을 둘 수 있습니다.

    Worker
       │
       │ progress event
       ▼
    Redis
       │
       ▼
    FastAPI
       │
       ▼
    Browser

    Redis Streams나 Pub/Sub 같은 기능을 사용할 수 있습니다.

    예를 들어 Worker가 다음 이벤트를 발행합니다.

    {
      "task_id": "task-123",
      "type": "progress",
      "step": "ocr",
      "message": "OCR processing"
    }

    FastAPI는 해당 이벤트를 받아 SSE Client에게 전달합니다.


    15. Redis Streams와 Pub/Sub 중 무엇을 쓸까?

    진행 상황 전달만 필요하다면 Redis Pub/Sub도 사용할 수 있습니다.

    Worker
       │
       │ publish
       ▼
    Redis Pub/Sub
       │
       ▼
    FastAPI

    하지만 이벤트를 일정 기간 보존하거나 Consumer가 잠시 끊겼다가 다시 처리해야 한다면 Redis Streams가 더 적합할 수 있습니다.

    Worker
       │
       │ XADD
       ▼
    Redis Stream
       │
       ▼
    FastAPI

    이 둘의 차이를 아주 단순하게 표현하면 다음과 같습니다.

    Pub/Sub
    
    Worker ── publish ──> Redis ──> FastAPI
    
                          ↓
    
                    그 순간 구독자가
                    없으면 이벤트 소실
    
    
    Streams
    
    Worker ─── XADD ───> Redis Stream
                             │
                             ├── event 1
                             ├── event 2
                             ├── event 3
                             └── event 4
                                  │
                                  ▼
                               FastAPI

    따라서 단순히 현재 접속 중인 사용자에게 진행 상황만 보여주는 것이 목적이라면 Pub/Sub으로도 충분할 수 있습니다.

    반면 다음과 같은 요구사항이 있다면 Streams를 고려할 수 있습니다.

    • 이벤트를 일정 시간 보존해야 한다.
    • Consumer가 잠시 중단되어도 다시 읽어야 한다.
    • 작업 처리 이력을 남겨야 한다.
    • 여러 Consumer가 이벤트를 처리해야 한다.
    • 장애 이후에도 이벤트 처리를 이어가야 한다.

    중요한 것은 SSE와 Redis Streams를 같은 종류의 기술로 생각하지 않는 것입니다.

    Redis Streams
    
    Backend 내부의 이벤트 전달 / 저장
    
    
    SSE
    
    Backend → Browser 이벤트 전달

    서로 다른 계층에서 다른 문제를 해결합니다.


    16. 최종 결과는 어떻게 Browser까지 전달할까?

    이제 Agent의 작업이 완료됐다고 생각해보겠습니다.

    MCP Server가 구조화된 결과를 반환합니다.

    {
      "invoice_number": "INV-2026-001",
      "invoice_date": "2026-09-15",
      "vendor": "ABC Corporation",
      "total_amount": 1250.00,
      "currency": "USD"
    }

    이 결과는 먼저 Agent에게 전달됩니다.

    MCP Server
         │
         │ Tool Result
         ▼
       Agent

    Agent는 결과를 검증하거나 여러 Tool의 결과를 조합할 수도 있습니다.

    OCR Result
         │
         ├──────────┐
         │          │
         ▼          ▼
    Extractor    Validator
         │          │
         └────┬─────┘
              ▼
          Final Result

    최종 결과가 준비되면 Backend에 저장할 수 있습니다.

    Agent
      │
      │ save result
      ▼
    Database

    그리고 작업 완료 이벤트를 발행합니다.

    Agent
      │
      │ completed
      ▼
    Redis

    FastAPI는 이 이벤트를 받아 Browser에 전달합니다.

    Redis
      │
      ▼
    FastAPI
      │
      │ SSE
      ▼
    Browser

    예를 들어 마지막 SSE Event는 다음과 같을 수 있습니다.

    event: completed
    data: {
      "task_id": "task-123",
      "invoice_number": "INV-2026-001",
      "vendor": "ABC Corporation",
      "total_amount": 1250.00
    }

    Browser는 이 이벤트를 받으면 화면의 입력 필드를 자동으로 채웁니다.

    Invoice Number
    [ INV-2026-001          ]
    
    Vendor
    [ ABC Corporation       ]
    
    Total
    [ 1,250.00              ]
    
    Currency
    [ USD                    ]

    이제 사용자가 처음 눌렀던 자동 입력 버튼의 전체 작업이 완료됩니다.


    17. 그런데 최종 결과까지 SSE로 보내야 할까?

    여기서 설계 선택지가 하나 생깁니다.

    완료 이벤트에 최종 결과 전체를 담을 수도 있습니다.

    SSE
    
    event: completed
    data: { ... final result ... }

    하지만 다른 방법도 있습니다.

    완료 여부만 SSE로 전달하는 것입니다.

    event: completed
    data: {
      "task_id": "task-123"
    }

    그다음 Browser가 별도의 API를 호출합니다.

    Browser
       │
       │ GET /tasks/task-123/result
       ▼
    FastAPI
       │
       ▼
    Database
       │
       ▼
    JSON Result

    즉 다음과 같이 역할을 나눌 수 있습니다.

    SSE
    
    상태 변화 알림
    
    
    REST API
    
    최종 데이터 조회

    이 구조는 꽤 실용적입니다.

    SSE 연결이 중간에 끊겨도 최종 결과 자체는 Database에 남아 있기 때문입니다.

    SSE 연결 끊김
          │
          X
    
    하지만
    
    Database
       │
       └── Result 존재

    Browser는 다시 접속한 뒤 현재 작업 상태를 조회할 수 있습니다.

    GET /tasks/task-123

    응답:

    {
      "task_id": "task-123",
      "status": "completed"
    }

    그리고 결과를 다시 가져올 수 있습니다.

    GET /tasks/task-123/result

    실제 운영 환경에서는 이런 구조가 장애 복구 측면에서 더 안전할 수 있습니다.


    18. SSE 연결이 끊어지면 작업도 중단될까?

    여기서 아주 중요한 문제가 하나 있습니다.

    사용자가 Browser를 닫았다고 생각해봅시다.

    Browser
       │
       X
    SSE Disconnect

    그렇다면 Agent 작업도 중단해야 할까요?

    반드시 그렇지는 않습니다.

    SSE는 작업 실행 채널이 아니라 작업 상태를 관찰하는 채널이기 때문입니다.

    Browser
       │
       │ SSE
       ▼
    FastAPI
    
    
    Agent Worker
       │
       │ Task Processing
       ▼
    MCP Server

    Browser 연결과 실제 작업의 생명주기를 분리할 수 있습니다.

    따라서 Browser가 닫혀도:

    Browser
       X
    
    Agent Worker
       │
       ├── OCR
       ├── Extract
       ├── Validate
       └── Complete

    작업은 계속 수행될 수 있습니다.

    사용자가 다시 접속하면 현재 상태를 조회합니다.

    GET /tasks/task-123

    예를 들어:

    {
      "task_id": "task-123",
      "status": "completed"
    }

    이 구조에서 중요한 원칙이 하나 나옵니다.

    Client 연결의 생명주기와 Backend Task의 생명주기를 분리한다.

    Long-running AI 작업을 설계할 때 상당히 중요한 원칙입니다.


    19. 그렇다면 사용자가 작업을 취소하면?

    이번에는 사용자가 명시적으로 취소 버튼을 눌렀다고 생각해보겠습니다.

    [ 분석 취소 ]

    이것은 SSE로 보낼 필요가 없습니다.

    Client → Server 요청이기 때문입니다.

    일반 HTTP API로 충분합니다.

    Browser
       │
       │ POST /tasks/task-123/cancel
       ▼
    FastAPI

    FastAPI는 Task 상태를 변경합니다.

    RUNNING
    
       ↓
    
    CANCEL_REQUESTED

    그리고 Worker가 이를 확인합니다.

    Worker
       │
       │ cancel requested?
       ▼
      Yes
       │
       ▼
    Stop Processing

    최종 상태는 다음과 같이 바뀔 수 있습니다.

    CANCEL_REQUESTED
           │
           ▼
       CANCELLED

    그리고 다시 SSE로 Browser에 알립니다.

    FastAPI
       │
       │ SSE
       ▼
    Browser
    
    event: cancelled

    전체 흐름을 보면 재미있습니다.

                     HTTP POST
    Browser ─────────────────────> FastAPI
                 cancel
    
    
                        Backend
                           │
                           ▼
                        Worker
                           │
                        cancelled
                           │
                           ▼
    
    
                        SSE
    Browser <───────────────────── FastAPI
                cancelled

    즉 하나의 기능 안에서도 HTTP Request와 SSE가 함께 사용됩니다.


    20. Human-in-the-Loop가 들어가면 더 재미있어진다

    AI Agent가 항상 자동으로 모든 결정을 내릴 수 있는 것은 아닙니다.

    예를 들어 인보이스 금액이 너무 크거나 추출 신뢰도가 낮다고 생각해보겠습니다.

    Total Amount
    
    ₩ 95,000,000
    
    
    Confidence
    
    0.62

    Agent가 판단합니다.

    Confidence < 0.7
    
           ↓
    
    Human Review Required

    작업 상태를 변경합니다.

    RUNNING
       │
       ▼
    WAITING_HUMAN

    그리고 사용자에게 SSE 이벤트를 보냅니다.

    event: human_review_required
    data: {
      "task_id": "task-123",
      "reason": "low_confidence"
    }

    Browser에서는 검토 화면을 보여줍니다.

    AI가 추출한 값의 확인이 필요합니다.
    
    Vendor
    [ ABC Corporation ]
    
    Total
    [ 95,000,000 ]
    
    [ 승인 ]    [ 수정 ]    [ 거절 ]

    사용자가 승인합니다.

    이것은 다시 Client → Server 요청입니다.

    Browser
       │
       │ POST /tasks/task-123/approve
       ▼
    FastAPI

    Agent는 작업을 재개합니다.

    WAITING_HUMAN
          │
          │ approve
          ▼
       RUNNING
          │
          ▼
       COMPLETED

    전체 흐름은 다음과 같습니다.

    Agent
      │
      │ Human Review Required
      ▼
    Redis
      │
      ▼
    FastAPI
      │
      │ SSE
      ▼
    Browser
      │
      │ Approve
      ▼
    FastAPI
      │
      ▼
    Agent
      │
      ▼
    Continue

    이 구조를 보면 SSE와 HTTP Request의 역할이 아주 명확하게 나뉩니다.

    Server → Client 상태 알림
    
    SSE
    
    
    Client → Server 사용자 액션
    
    HTTP Request

    21. Agent와 MCP 사이에서도 HITL이 가능하다

    조금 더 깊게 들어가면 Human-in-the-Loop가 Agent Runtime 내부에 들어갈 수도 있습니다.

    Agent
      │
      │ Tool Call
      ▼
    MCP Server
      │
      ▼
    Invoice Tool
      │
      ▼
    Low Confidence

    Agent Runtime은 현재 상태를 Checkpoint에 저장합니다.

    Agent State
    
    {
      task_id,
      current_step,
      tool_result,
      extracted_fields,
      status
    }

    그리고 실행을 멈춥니다.

    RUNNING
       │
       ▼
    WAITING_HUMAN

    사용자 승인이 들어오면 저장된 상태에서 다시 시작합니다.

    Checkpoint
        │
        ▼
    Agent Resume
        │
        ▼
    Next Step

    이때 Transport와 Runtime을 구분해서 생각하는 것이 중요합니다.

    SSE
    
    상태 전달
    
    
    Streamable HTTP
    
    Agent ↔ MCP 통신
    
    
    Checkpoint
    
    Agent 실행 상태 저장

    각 기술이 해결하는 문제가 완전히 다릅니다.


    22. 실패 처리도 생각해야 한다

    실제 운영에서는 성공보다 실패 처리가 더 중요할 때가 많습니다.

    예를 들어 MCP Tool 호출이 실패했다고 생각해보겠습니다.

    Agent
      │
      │ tools/call
      ▼
    MCP Server
      │
      X
    VLM Timeout

    Agent는 Retry 정책을 적용할 수 있습니다.

    Attempt 1
       │
       X
    
    Retry
    
    Attempt 2
       │
       X
    
    Retry
    
    Attempt 3
       │
       ▼
    Success

    이 과정도 사용자에게 모두 보여줄 필요는 없습니다.

    Browser에서는 단순히:

    AI 분석 중...

    이라고 보여줄 수도 있습니다.

    즉 내부 이벤트와 사용자 이벤트를 분리하는 것이 좋습니다.

    Internal Event
    
    tool_retry
    mcp_timeout
    worker_retry
    model_fallback
    
    
    User Event
    
    processing
    review_required
    completed
    failed

    Backend 내부 구현 세부사항을 그대로 Browser에 노출하면 UI와 Backend가 지나치게 강하게 결합될 수 있습니다.


    23. Event를 계층별로 나누자

    실제 시스템에서는 이벤트를 다음과 같이 나누는 것이 좋습니다.

    Infrastructure Event

    worker_started
    worker_retry
    redis_error
    mcp_reconnect

    운영 및 모니터링 용도입니다.

    Agent Event

    tool_started
    tool_completed
    tool_failed
    human_review_required

    Agent Runtime의 상태를 표현합니다.

    User Event

    processing
    progress
    review_required
    completed
    failed

    사용자 UI에 전달하기 위한 이벤트입니다.

    전체 구조는 다음과 같습니다.

    Infrastructure
          │
          ▼
    Agent Runtime
          │
          ▼
    Application Event
          │
          ▼
    User Event
          │
          ▼
    SSE
          │
          ▼
    Browser

    이렇게 한 단계 추상화하면 Backend 내부 구현이 변경되어도 Frontend에 미치는 영향을 줄일 수 있습니다.


    24. SSE Event Schema도 미리 정의하는 것이 좋다

    처음에는 다음과 같이 문자열만 보내기 쉽습니다.

    data: OCR 진행 중

    하지만 시스템이 커지면 구조화된 이벤트가 필요해집니다.

    예를 들어:

    {
      "event": "progress",
      "task_id": "task-123",
      "step": "ocr",
      "progress": 40,
      "message": "OCR을 진행하고 있습니다."
    }

    완료 이벤트:

    {
      "event": "completed",
      "task_id": "task-123",
      "progress": 100
    }

    실패 이벤트:

    {
      "event": "failed",
      "task_id": "task-123",
      "error_code": "VLM_TIMEOUT",
      "message": "문서 분석에 실패했습니다."
    }

    이렇게 Schema를 정의해두면 Frontend 구현도 단순해집니다.

    event == progress
          ↓
    Progress UI
    
    
    event == completed
          ↓
    Result UI
    
    
    event == failed
          ↓
    Error UI

    25. Task 상태도 명확하게 정의하자

    Long-running 작업이라면 이벤트뿐만 아니라 Task 자체의 상태도 필요합니다.

    예를 들어:

    PENDING
    
    RUNNING
    
    WAITING_HUMAN
    
    COMPLETED
    
    FAILED
    
    CANCELLED

    상태 전이를 그려보면 다음과 같습니다.

    PENDING
       │
       ▼
    RUNNING
       │
       ├──────────────> FAILED
       │
       ├──────────────> CANCELLED
       │
       ├──> WAITING_HUMAN
       │          │
       │          ▼
       │       RUNNING
       │
       ▼
    COMPLETED

    이 상태는 Database에 저장하는 것이 좋습니다.

    tasks
    
    task_id
    status
    current_step
    progress
    result_id
    error_code
    created_at
    updated_at

    SSE는 이 상태 변화를 실시간으로 전달하는 역할을 합니다.

    다시 말해:

    SSE 자체를 상태 저장소로 사용해서는 안 됩니다.


    26. 연결이 끊겨도 복구할 수 있는 구조

    이제 시스템이 상당히 안정적으로 변했습니다.

    Browser의 SSE 연결이 끊겼다고 생각해봅시다.

    Browser
       X
    Network Error

    Agent 작업은 계속 진행됩니다.

    Agent Worker
       │
       ├── OCR
       ├── Extraction
       └── Validation

    상태는 Database에 저장됩니다.

    task-123
    
    status = COMPLETED

    사용자가 다시 페이지를 엽니다.

    Browser
       │
       │ GET /tasks/task-123
       ▼
    FastAPI

    서버가 현재 상태를 반환합니다.

    {
      "task_id": "task-123",
      "status": "completed"
    }

    Browser는 결과를 가져옵니다.

    GET /tasks/task-123/result

    즉 실시간 연결이 끊어져도 시스템의 상태는 사라지지 않습니다.

    이것이 운영 가능한 Long-running AI 시스템에서 매우 중요한 특성입니다.


    27. 전체 아키텍처를 완성해보자

    지금까지의 내용을 모두 합쳐보겠습니다.

                            ┌─────────────────┐
                            │     Browser     │
                            └───────┬─────────┘
                                    │
                        HTTP Request│
                                    ▼
                            ┌─────────────────┐
                            │     FastAPI     │
                            └───────┬─────────┘
                                    │
                                 enqueue
                                    │
                                    ▼
                            ┌─────────────────┐
                            │  Agent Worker   │
                            └───────┬─────────┘
                                    │
                         Streamable HTTP
                                    │
                                    ▼
                            ┌─────────────────┐
                            │   MCP Server    │
                            └───────┬─────────┘
                                    │
                      ┌─────────────┼─────────────┐
                      ▼             ▼             ▼
                    Parser        OCR/VLM      Validator
    
    
    Agent Worker
         │
         │ progress / status
         ▼
    ┌───────────────┐
    │ Redis Streams │
    └───────┬───────┘
            │
            ▼
        FastAPI
            │
            │ SSE
            ▼
         Browser
    
    
    Agent Worker
         │
         │ state / result
         ▼
    ┌───────────────┐
    │   Database    │
    └───────────────┘

    이제 각각의 통신 방식이 담당하는 역할이 명확하게 보입니다.

    Browser → FastAPI
        일반 HTTP Request
    
    FastAPI → Agent Worker
        Task 전달
    
    Agent Worker ↔ MCP Server
        Streamable HTTP
    
    Agent Worker → Redis
        Backend Event
    
    FastAPI → Browser
        SSE
    
    Agent Worker → Database
        Task 상태 / 최종 결과 저장

    중요한 것은 이 구조에서 어느 하나의 기술이 전체 시스템의 통신을 담당하지 않는다는 점입니다.

    각 구간의 요구사항에 가장 적합한 방식을 선택합니다.


    28. 요청부터 완료까지 전체 흐름

    이제 사용자가 자동 입력 버튼을 누르는 순간부터 화면에 데이터가 채워질 때까지 전체 과정을 순서대로 따라가 보겠습니다.

    Step 1. 사용자가 분석을 요청한다

    Browser
       │
       │ POST /invoices/analyze
       │ invoice.pdf
       ▼
    FastAPI

    FastAPI는 Task를 생성합니다.

    {
      "task_id": "task-123",
      "status": "pending"
    }

    그리고 바로 Browser에 반환합니다.

    HTTP 202 Accepted

    즉 파일 분석이 끝날 때까지 HTTP Request를 붙잡고 있지 않습니다.


    Step 2. Browser가 진행 상황을 구독한다

    Browser는 Task ID를 이용해 SSE Endpoint에 연결합니다.

    GET /tasks/task-123/events

    연결 구조는 다음과 같습니다.

    Browser
       │
       │ GET /events
       ▼
    FastAPI
       │
       │
       └════ SSE Stream ════> Browser

    이제 Browser는 서버에서 발생하는 상태 변화를 받을 준비가 됐습니다.


    Step 3. Worker가 작업을 시작한다

    FastAPI
       │
       │ enqueue
       ▼
    Agent Worker

    Task 상태가 변경됩니다.

    PENDING
       │
       ▼
    RUNNING

    Worker는 이벤트를 발행합니다.

    {
      "event": "progress",
      "step": "started",
      "progress": 5
    }

    이 이벤트가 Redis를 거쳐 Browser까지 전달됩니다.

    Worker
      │
      ▼
    Redis
      │
      ▼
    FastAPI
      │
      │ SSE
      ▼
    Browser

    Step 4. Agent가 필요한 Tool을 결정한다

    Agent가 문서를 확인합니다.

    Agent
    
    "What type of document is this?"
    
            │
            ▼
    
    Invoice PDF

    Agent는 필요한 Tool을 선택합니다.

    parse_document()
    
    extract_invoice()
    
    validate_invoice()

    Step 5. Agent가 MCP Tool을 호출한다

    Agent
      │
      │ tools/call
      ▼
    MCP Server

    이 구간에서는 Streamable HTTP가 사용됩니다.

    Agent                         MCP Server
      │                               │
      │──── POST /mcp ───────────────>│
      │                               │
      │       Tool Execution          │
      │                               │
      │<──── Result ──────────────────│

    빠른 작업이라면 일반 JSON Response가 반환될 수 있습니다.

    필요한 경우에는 Streaming Response를 사용할 수도 있습니다.


    Step 6. 작업 진행 상황을 사용자에게 전달한다

    Agent가 OCR 단계에 들어갑니다.

    Agent Worker
         │
         │ progress
         ▼
    Redis

    FastAPI가 이벤트를 전달합니다.

    FastAPI
       │
       │ SSE
       ▼
    Browser

    사용자 화면은 다음과 같이 변경됩니다.

    ✓ 파일 업로드 완료
    
    ✓ PDF 변환 완료
    
    ● OCR 분석 중...
    
    ○ 데이터 추출
    
    ○ 데이터 검증

    Step 7. 데이터 추출이 완료된다

    MCP Tool이 구조화된 데이터를 반환합니다.

    {
      "invoice_number": "INV-2026-001",
      "invoice_date": "2026-09-15",
      "vendor": "ABC Corporation",
      "total_amount": 1250.00,
      "currency": "USD"
    }

    Agent가 결과를 검증합니다.

    Extraction Result
           │
           ▼
       Validation
           │
           ▼
      Final Result

    Step 8. 결과를 저장한다

    Agent Worker
         │
         │ Final Result
         ▼
    Database

    Task 상태도 변경합니다.

    RUNNING
       │
       ▼
    COMPLETED

    Step 9. 완료 이벤트를 전달한다

    Agent Worker
         │
         ▼
    Redis
         │
         ▼
    FastAPI
         │
         │ SSE
         ▼
    Browser

    Browser가 다음 이벤트를 받습니다.

    event: completed
    data: {
      "task_id": "task-123"
    }

    Step 10. Browser가 최종 결과를 가져온다

    Browser
       │
       │ GET /tasks/task-123/result
       ▼
    FastAPI
       │
       ▼
    Database

    결과를 반환합니다.

    {
      "invoice_number": "INV-2026-001",
      "invoice_date": "2026-09-15",
      "vendor": "ABC Corporation",
      "total_amount": 1250.00,
      "currency": "USD"
    }

    그리고 화면에 자동으로 입력합니다.

    Invoice Number
    [ INV-2026-001       ]
    
    Invoice Date
    [ 2026-09-15         ]
    
    Vendor
    [ ABC Corporation    ]
    
    Total
    [ 1,250.00           ]
    
    Currency
    [ USD                 ]

    사용자 입장에서는 단순히 버튼 하나를 눌렀지만 Backend에서는 여러 종류의 통신이 협력하고 있었습니다.


    29. 왜 모든 것을 SSE로 만들지 않을까?

    여기까지 보면 이런 생각도 들 수 있습니다.

    이미 SSE 연결이 있는데 그냥 모든 데이터를 SSE로 주고받으면 안 될까?

    문제는 SSE 자체가 Server → Client 이벤트 전달을 위한 방식이라는 것입니다.

    Client가 분석을 시작하는 것은 명확한 Command입니다.

    POST /analyze

    작업을 취소하는 것도 Command입니다.

    POST /tasks/{id}/cancel

    승인하는 것도 Command입니다.

    POST /tasks/{id}/approve

    반면 진행 상황은 Event입니다.

    processing
    
    progress
    
    review_required
    
    completed

    그래서 역할을 다음처럼 나누면 구조가 명확해집니다.

    Command
    
    Browser ───── HTTP ─────> Server
    
    
    Event
    
    Browser <───── SSE ────── Server

    이 패턴은 꽤 이해하기 쉽습니다.

    Client의 의도는 HTTP Request로 전달하고, Server에서 발생하는 변화는 SSE Event로 전달한다.


    30. 왜 모든 것을 WebSocket으로 만들지 않을까?

    WebSocket으로도 구현할 수 있습니다.

    Browser <════════════════> Server
    
    analyze
    progress
    cancel
    review
    approve
    completed

    하지만 이 시스템에서는 Browser가 서버로 지속적인 실시간 데이터를 보내야 하는 상황이 많지 않습니다.

    대부분의 Client → Server 동작은 명확한 Command입니다.

    Analyze
    
    Cancel
    
    Approve
    
    Reject

    그리고 대부분의 Server → Client 데이터는 상태 변화입니다.

    Processing
    
    Progress
    
    Review Required
    
    Completed

    따라서 굳이 전체 시스템을 지속적인 Full-Duplex 연결로 만들 필요가 없다면,

    HTTP + SSE

    조합이 더 단순할 수 있습니다.

    물론 실시간 음성 대화나 공동 편집처럼 양쪽에서 지속적인 데이터가 발생한다면 이야기는 달라집니다.

    그때는 WebSocket이 더 자연스러울 수 있습니다.


    31. 왜 Browser가 MCP Server를 직접 호출하지 않을까?

    이런 구조도 생각할 수 있습니다.

    Browser
       │
       │ MCP
       ▼
    MCP Server

    하지만 일반적인 업무용 AI 시스템에서는 중간에 Application Backend를 두는 것이 자연스럽습니다.

    Browser
       │
       ▼
    FastAPI
       │
       ▼
    Agent
       │
       ▼
    MCP Server

    FastAPI와 Agent Runtime에는 다음과 같은 책임이 있기 때문입니다.

    Authentication
    
    Authorization
    
    Tenant Isolation
    
    Business Logic
    
    Task Management
    
    Rate Limiting
    
    Audit Logging
    
    Agent Orchestration
    
    HITL
    
    Usage Tracking

    MCP Server의 책임은 조금 다릅니다.

    Tool 제공
    
    Resource 제공
    
    외부 시스템 접근
    
    기능 실행

    즉 다음과 같이 책임을 나누는 것입니다.

    FastAPI
    
    Application Boundary
    
    
    Agent Runtime
    
    Decision / Orchestration
    
    
    MCP Server
    
    Tool Boundary

    이렇게 분리하면 MCP Tool을 다른 Agent에서도 재사용하기 쉬워집니다.


    32. FastAPI와 FastMCP의 역할도 명확해진다

    이 구조를 이해하면 자주 나오는 질문도 자연스럽게 해결됩니다.

    FastMCP를 사용하는데 FastAPI는 왜 필요한가?

    둘은 경쟁 관계가 아닙니다.

    FastAPI는 사용자가 접근하는 Application API를 담당할 수 있습니다.

    Browser
       │
       ▼
    FastAPI
    
    POST /login
    
    POST /documents
    
    POST /invoices/analyze
    
    GET /tasks/{id}
    
    GET /tasks/{id}/result

    FastMCP 기반 MCP Server는 Agent가 사용하는 Tool Interface를 담당할 수 있습니다.

    Agent
       │
       ▼
    MCP Server
    
    tools/list
    
    tools/call
    
    resources/read

    전체적으로 보면:

    User
     │
     ▼
    Web UI
     │
     ▼
    FastAPI
     │
     ▼
    Agent
     │
     ▼
    FastMCP
     │
     ▼
    Tools

    각 계층의 책임이 다릅니다.


    33. 결국 Transport는 계층별로 선택한다

    전체 시스템에서 사용된 통신 방식을 다시 정리해보겠습니다.

    Browser
       │
       │ HTTP Request
       ▼
    FastAPI

    사용자의 명령 전달입니다.

    FastAPI
       │
       │ Task Queue
       ▼
    Agent Worker

    장시간 작업을 API Process와 분리합니다.

    Agent
       │
       │ Streamable HTTP
       ▼
    MCP Server

    Agent가 Tool을 호출합니다.

    Agent Worker
       │
       │ Event
       ▼
    Redis Streams / PubSub

    Backend 내부에서 상태 변화를 전달합니다.

    FastAPI
       │
       │ SSE
       ▼
    Browser

    사용자에게 실시간 진행 상황을 전달합니다.

    어느 하나가 다른 것을 대체하는 관계가 아닙니다.

    각자의 역할이 있습니다.


    34. 선택 기준을 아주 단순하게 정리하면

    일반 HTTP

    이런 질문을 해봅니다.

    Client가 요청하고 결과를 받으면 끝나는가?

    그렇다면 일반 HTTP가 가장 단순합니다.

    Client ─── Request ───> Server
    Client <── Response ─── Server

    SSE

    이런 요구사항이라면 SSE를 고려합니다.

    Server에서 발생하는 데이터를 Client에게 계속 전달해야 하는가?

    Server ───────────────> Client

    예:

    LLM Streaming
    
    Progress
    
    Notification
    
    Agent Status

    WebSocket

    이런 요구사항이라면 WebSocket을 고려합니다.

    양쪽에서 지속적으로 실시간 메시지를 보내야 하는가?

    Client <══════════════> Server

    예:

    Realtime Chat
    
    Voice
    
    Game
    
    Collaborative Editing
    
    Realtime Control

    Streamable HTTP

    이런 요구사항이라면 Streamable HTTP가 잘 맞습니다.

    RPC Request/Response를 기본으로 하면서 필요할 때 Streaming도 필요한가?

    Request
       │
       ▼
    Response
    
    or
    
    Request
       │
       ▼
    Stream

    MCP가 대표적인 사례입니다.


    Redis Streams / PubSub

    이것은 Browser 통신 방식의 선택과는 다른 문제입니다.

    질문은 다음과 같습니다.

    Backend Process 사이에서 이벤트를 어떻게 전달할 것인가?

    Worker
       │
       ▼
    Redis
       │
       ▼
    API

    즉 애플리케이션 내부 메시징 계층의 문제입니다.


    35. 가장 중요한 설계 원칙

    이번 구조에서 몇 가지 중요한 원칙을 얻을 수 있습니다.

    첫 번째는:

    작업 실행과 Client 연결의 생명주기를 분리한다.

    SSE Disconnect
    
    ≠
    
    Task Cancel

    두 번째는:

    실시간 이벤트와 영구 상태를 분리한다.

    SSE / Redis
    
    Event
    
    
    Database
    
    State

    세 번째는:

    Client Command와 Server Event를 구분한다.

    Command
    
    Client ─── HTTP ───> Server
    
    
    Event
    
    Client <─── SSE ──── Server

    네 번째는:

    Agent와 Tool의 경계를 명확하게 한다.

    Agent
    
    판단 / Orchestration
    
    
    MCP Server
    
    Tool 제공 / 실행

    그리고 마지막으로:

    하나의 통신 기술로 모든 문제를 해결하려 하지 않는다.

    이 원칙이 가장 중요할 수 있습니다.


    마치며

    이번 시리즈는 SSE라는 비교적 단순한 기술에서 시작했습니다.

    1부

    HTTP 연결 하나로 데이터를 계속 보내는 SSE

    HTTP Response
       │
       ├── data
       ├── data
       ├── data
       └── end

    하나의 HTTP Response가 어떻게 데이터를 조금씩 전달할 수 있는지 살펴봤습니다.

    2부

    SSE만으로는 부족한가? 양방향 통신과 RPC의 문제

    Request
    
    Response
    
    Notification
    
    Streaming

    복잡한 AI 시스템에서는 단순한 Server → Client 스트리밍만으로는 충분하지 않다는 것을 살펴봤습니다.

    3부

    MCP는 왜 Streamable HTTP를 사용하는가

    HTTP Request / Response
              +
    필요할 때 Streaming
              =
    Streamable HTTP

    MCP가 왜 HTTP의 단순함을 유지하면서 필요할 때 스트리밍할 수 있는 Transport를 사용하는지 살펴봤습니다.

    그리고 이번 4부에서는 이 기술들을 실제 AI Agent 시스템 안에 배치해봤습니다.

    Browser
       │
       │ HTTP
       ▼
    FastAPI
       │
       ▼
    Agent Worker
       │
       │ Streamable HTTP
       ▼
    MCP Server
       │
       ├── Parser
       ├── OCR / VLM
       ├── Extractor
       └── Validator

    동시에 사용자에게 진행 상황을 전달합니다.

    Agent Worker
         │
         ▼
    Redis
         │
         ▼
    FastAPI
         │
         │ SSE
         ▼
    Browser

    결국 SSE, WebSocket, Streamable HTTP, Redis Streams는 서로 경쟁하는 기술이 아닙니다.

    각자 다른 문제를 해결합니다.

    HTTP
        Request / Response
    
    
    SSE
        Server → Client Streaming
    
    
    WebSocket
        Full-Duplex Communication
    
    
    Streamable HTTP
        RPC + Optional Streaming
    
    
    Redis Streams
        Backend Event Messaging

    AI 시스템이 복잡해질수록 중요한 것은 새로운 기술을 많이 사용하는 것이 아닙니다.

    각 통신이 무엇을 위해 존재하는지 구분하는 것입니다.

    사용자의 요청인지,

    서버의 이벤트인지,

    Agent의 Tool 호출인지,

    Backend 내부의 상태 변화인지,

    영구적으로 보존해야 하는 상태인지.

    이 경계를 명확하게 나누면 시스템의 구조도 자연스럽게 단순해집니다.

    그리고 그때 SSE와 Streamable HTTP가 어디에 필요한지도 훨씬 명확하게 보이기 시작합니다.

  • SSE와 Streamable HTTP 3부 — MCP는 왜 Streamable HTTP를 사용하는가

    SSE와 Streamable HTTP 3부 — MCP는 왜 Streamable HTTP를 사용하는가

    1부에서는 SSE가 하나의 HTTP Response를 유지하면서 데이터를 조금씩 전달하는 원리를 살펴봤습니다.

    2부에서는 한 단계 더 나아가 이런 질문을 던졌습니다.

    SSE만으로 복잡한 AI 시스템의 통신을 처리할 수 있을까?

    SSE는 Server → Client 방향의 스트리밍에는 매우 유용합니다.

    WebSocket을 사용하면 양방향 통신도 가능합니다.

    하지만 MCP 같은 RPC 기반 시스템에서 중요한 것은 단순히 단방향인가, 양방향인가의 문제가 아니었습니다.

    MCP에서는 다양한 형태의 메시지를 처리해야 합니다.

    Request
    Response
    Notification
    Streaming
    Session

    그리고 2부 마지막에 이런 질문을 남겼습니다.

    HTTP의 단순한 Request/Response 구조를 유지하면서, 필요한 순간에만 스트리밍할 수는 없을까?

    이번 글에서 살펴볼 Streamable HTTP가 바로 이 질문과 연결됩니다.


    1. 먼저 이름부터 살펴보자

    Streamable HTTP라는 이름을 처음 보면 흔히 이렇게 생각할 수 있습니다.

    SSE
     ↓
    새로운 스트리밍 기술
     ↓
    Streamable HTTP

    하지만 이렇게 이해하면 조금 어색합니다.

    Streamable HTTP는 SSE를 대체하는 새로운 스트리밍 포맷이라고 보기보다는,

    HTTP를 기본 전송 방식으로 사용하면서 필요할 때 스트리밍까지 사용할 수 있도록 구성한 MCP의 Transport 방식이라고 이해하는 편이 좋습니다.

    이름도 자세히 보면

    Streaming HTTP

    가 아니라

    Streamable HTTP

    입니다.

    항상 Streaming하는 HTTP가 아니라,

    필요하면 Stream할 수 있는 HTTP

    라는 관점입니다.


    2. 가장 단순한 경우부터 생각해보자

    MCP Client가 MCP Server에게 Tool 목록을 요청한다고 해보겠습니다.

    MCP Client                     MCP Server
        │                              │
        │──── tools/list ─────────────>│
        │                              │
        │<──── tool list ──────────────│
        │                              │

    이 요청은 일반적인 Request/Response로 충분합니다.

    굳이 장시간 연결을 유지하거나 지속적인 이벤트 스트림을 만들 필요가 없습니다.

    개념적으로는 평범한 HTTP 요청처럼 처리할 수 있습니다.

    POST /mcp
    Content-Type: application/json
    
    {
        "jsonrpc": "2.0",
        "id": 1,
        "method": "tools/list"
    }

    서버가 처리한 뒤 결과를 반환합니다.

    HTTP/1.1 200 OK
    Content-Type: application/json
    
    {
        "jsonrpc": "2.0",
        "id": 1,
        "result": {
            ...
        }
    }

    구조만 보면 우리가 오래전부터 사용해온 HTTP API와 크게 다르지 않습니다.

    Client
       │
       │ HTTP POST
       ▼
    Server
       │
       │ 처리
       ▼
    JSON Response

    여기까지만 보면 스트리밍은 필요하지 않습니다.


    3. 그런데 모든 Tool이 빨리 끝나는 것은 아니다

    이번에는 다른 Tool을 호출해보겠습니다.

    tools/call
        │
        ▼
    analyze_invoice()

    인보이스 분석 Tool 내부에서 다음과 같은 작업이 발생한다고 해봅시다.

    PDF
     │
     ▼
    Rendering
     │
     ▼
    OCR / VLM
     │
     ▼
    Field Extraction
     │
     ▼
    Validation
     │
     ▼
    Result

    이 작업이 20초 걸린다고 생각해봅시다.

    가장 단순한 방법은 20초를 기다린 뒤 결과를 반환하는 것입니다.

    Client                         Server
       │                              │
       │──── tools/call ─────────────>│
       │                              │
       │                              │
       │         20 seconds           │
       │                              │
       │                              │
       │<──── result ─────────────────│

    기술적으로 아무 문제 없습니다.

    하지만 경우에 따라 서버가 처리 과정에서 여러 메시지를 전달해야 할 수도 있습니다.

    processing...
    
    OCR completed
    
    extracting...
    
    validating...
    
    completed

    이제 단순 JSON Response 하나만으로는 표현하기 불편해집니다.

    이때 스트리밍이 필요해집니다.


    4. Streamable HTTP의 핵심 구조

    Streamable HTTP의 핵심 아이디어를 단순화하면 다음과 같습니다.

                      POST /mcp
    
    MCP Client ───────────────────────> MCP Server

    Client는 MCP 메시지를 HTTP POST로 보냅니다.

    그런데 서버의 Response는 상황에 따라 달라질 수 있습니다.

    단순한 요청이라면:

    MCP Client                     MCP Server
        │                              │
        │──── POST /mcp ──────────────>│
        │                              │
        │<──── JSON Response ──────────│

    스트리밍이 필요하다면:

    MCP Client                     MCP Server
        │                              │
        │──── POST /mcp ──────────────>│
        │                              │
        │<════ SSE Stream ═════════════│
        │<──── message ────────────────│
        │<──── message ────────────────│
        │<──── message ────────────────│
        │<──── result ─────────────────│

    즉 같은 HTTP 기반 Transport 안에서 상황에 따라 다른 Response 형태를 사용할 수 있습니다.

                     POST /mcp
                         │
                         ▼
                    MCP Server
                         │
                ┌────────┴────────┐
                │                 │
                ▼                 ▼
         JSON Response       SSE Stream

    이 구조가 Streamable HTTP를 이해하는 가장 중요한 그림입니다.


    5. 여기서 SSE가 사라진 것이 아니다

    이 부분에서 많이 헷갈립니다.

    MCP가 기존 SSE Transport에서 Streamable HTTP로 이동했다고 하면,

    “이제 MCP에서는 SSE를 사용하지 않는구나.”

    라고 생각할 수 있습니다.

    그렇지 않습니다.

    Streamable HTTP에서도 SSE가 사용될 수 있습니다.

    차이는 SSE가 Transport 전체를 지배하는 구조가 아니라는 것입니다.

    개념적으로 보면 다음과 같습니다.

    Streamable HTTP
          │
          ├── HTTP POST
          │
          ├── JSON Response
          │
          └── SSE Response

    즉 SSE는 사라진 것이 아니라 필요한 경우 사용할 수 있는 스트리밍 메커니즘으로 들어가 있습니다.

    그래서 이름이 꽤 정확합니다.

    HTTP
     +
    optional streaming
     =
    Streamable HTTP

    6. 기존 SSE Transport는 어떻게 동작했을까?

    이 차이를 이해하려면 기존 MCP의 HTTP+SSE Transport를 살펴보는 것이 좋습니다.

    단순화하면 Client는 먼저 SSE 연결을 만들었습니다.

    MCP Client                     MCP Server
        │                              │
        │──── GET /sse ───────────────>│
        │                              │
        │<════ SSE Connection ═════════│
        │                              │

    그리고 서버는 이 SSE 연결을 통해 Client가 메시지를 보낼 HTTP endpoint를 알려줄 수 있었습니다.

    개념적으로 다음과 같은 구조입니다.

                      SSE
    MCP Client <════════════════ MCP Server
        │
        │
        │ POST message
        └──────────────────────> MCP Server

    즉 메시지 흐름을 단순화하면:

    Client → Server
        HTTP POST
    
    Server → Client
        SSE

    였습니다.

    그래서 두 개의 통신 경로를 관리하게 됩니다.

              POST
    Client ─────────────> Server
    
              SSE
    Client <═════════════ Server

    동작은 가능하지만 구조가 조금 복잡합니다.


    7. Streamable HTTP에서는 구조가 단순해진다

    Streamable HTTP에서는 MCP 통신을 하나의 MCP HTTP endpoint 중심으로 구성할 수 있습니다.

    예를 들어:

    POST /mcp

    입니다.

    Client가 메시지를 보냅니다.

    Client
       │
       │ POST /mcp
       ▼
    MCP Server

    서버는 요청 특성에 따라 적절한 Response를 반환합니다.

                      POST /mcp
                          │
                          ▼
                     MCP Server
                          │
              ┌───────────┴───────────┐
              │                       │
              ▼                       ▼
      application/json        text/event-stream
              │                       │
              ▼                       ▼
         JSON Response            SSE Stream

    이렇게 보면 Streamable HTTP라는 이름이 훨씬 이해하기 쉬워집니다.


    8. 그런데 GET은 왜 필요할까?

    여기서 조금 더 깊이 들어가보겠습니다.

    Streamable HTTP에서 핵심은 POST이지만, 경우에 따라 Client가 서버에서 발생하는 메시지를 받기 위한 SSE Stream을 열 수 있습니다.

    개념적으로는 다음과 같습니다.

    MCP Client                     MCP Server
        │                              │
        │──── GET /mcp ───────────────>│
        │                              │
        │<════ SSE Stream ═════════════│
        │                              │

    이 연결을 통해 서버가 Client에게 메시지를 전달할 수 있습니다.

    즉 전체적으로 보면 이런 형태가 가능합니다.

                    POST /mcp
    Client ─────────────────────────> Server
    
    
                     GET /mcp
    Client ─────────────────────────> Server
    Client <════════ SSE ════════════ Server

    여기서 중요한 것은 모든 요청마다 반드시 SSE 연결이 필요한 것은 아니라는 점입니다.

    필요한 통신 패턴에 따라 사용할 수 있습니다.


    9. 하나의 Endpoint가 중요한 이유

    기존 구조를 다시 보겠습니다.

    /sse
    
    /messages

    처럼 통신 역할이 나뉘어 있을 수 있었습니다.

    Streamable HTTP에서는 개념적으로 다음처럼 단순화됩니다.

    /mcp

    그리고 HTTP Method가 역할을 구분합니다.

    POST /mcp
        │
        └── Client → Server message
    
    
    GET /mcp
        │
        └── Server → Client SSE stream

    이 구조는 일반적인 HTTP 인프라와도 잘 맞습니다.

    예를 들어:

    Client
       │
       ▼
    Load Balancer
       │
       ▼
    API Gateway / Reverse Proxy
       │
       ▼
    MCP Server

    기존 HTTP 운영 환경에서 다루기 훨씬 자연스러운 구조가 됩니다.


    10. HTTP 인프라를 그대로 활용할 수 있다

    WebSocket은 매우 강력하지만 일반 HTTP와 연결 생명주기가 다릅니다.

    HTTP
    
    Request
       ↓
    Response
       ↓
    End

    WebSocket은 연결을 Upgrade한 뒤 장시간 유지합니다.

    HTTP
     │
     │ Upgrade
     ▼
    WebSocket
     │
     │
     │ persistent connection
     │
     │
     ▼

    반면 Streamable HTTP는 기본적으로 HTTP의 세계에 남아 있습니다.

    HTTP POST
    
    HTTP GET
    
    HTTP Status
    
    HTTP Header
    
    Authentication
    
    Proxy
    
    Load Balancer

    따라서 기존 웹 인프라와 자연스럽게 통합할 수 있다는 장점이 있습니다.

    특히 MCP Server를 실제 운영 환경에 배포한다고 생각하면 이 차이가 중요해집니다.


    11. Stateless하게 사용할 수도 있다

    Streamable HTTP의 또 다른 중요한 특징은 반드시 모든 Client 연결에 대해 무거운 장기 세션 상태를 유지해야 하는 것은 아니라는 점입니다.

    예를 들어 아주 단순한 MCP Server라면:

    Client
       │
       │ POST tools/call
       ▼
    Server
       │
       │ Tool 실행
       ▼
    Response

    요청 하나가 끝나면 서버가 별도의 연결 상태를 유지하지 않아도 됩니다.

    이런 구조는 서버 확장에도 유리합니다.

                     Load Balancer
                           │
              ┌────────────┼────────────┐
              ▼            ▼            ▼
          MCP #1        MCP #2        MCP #3

    특정 Client가 반드시 같은 서버 프로세스에 계속 붙어 있어야 하는 구조보다 운영이 단순해질 수 있습니다.

    물론 실제 MCP 시스템에서는 세션이 필요한 경우도 있습니다.

    중요한 것은 Transport 자체가 모든 통신을 하나의 영구 연결에 강하게 묶지 않는다는 것입니다.


    12. Session이 필요한 경우도 있다

    반대로 Client와 Server 사이에 상태를 유지해야 하는 경우도 있습니다.

    예를 들어 Server가 Client에게 Session ID를 제공한다고 생각해봅시다.

    Client                         Server
       │                              │
       │──── initialize ─────────────>│
       │                              │
       │<──── Session ID: abc123 ─────│

    이후 Client는 해당 Session을 식별해서 요청할 수 있습니다.

    POST /mcp
    
    Mcp-Session-Id: abc123

    개념적으로 보면:

    Client
       │
       │ Session abc123
       │
       ├──── tools/list
       │
       ├──── tools/call
       │
       └──── resources/read
       │
       ▼
    MCP Server

    따라서 Streamable HTTP는 단순한 Stateless HTTP만을 의미하는 것도 아닙니다.

    필요한 경우 Session을 유지할 수도 있습니다.


    13. 그래서 Streamable HTTP는 양방향인가?

    여기서 재미있는 질문이 생깁니다.

    Streamable HTTP는 양방향 통신인가?

    WebSocket과 같은 의미의 Full-Duplex 양방향 연결이라고 생각하면 조금 다릅니다.

    WebSocket은 하나의 연결에서 양쪽이 자유롭게 메시지를 보냅니다.

    Client <════════════════════> Server

    Streamable HTTP는 기본적으로 HTTP Request와 Response 모델을 사용합니다.

    Client ───── Request ───────> Server
    Client <──── Response ─────── Server

    필요한 경우 서버 방향의 스트림을 추가할 수 있습니다.

    Client ───── GET ───────────> Server
    Client <════ SSE ════════════ Server

    따라서 통신 결과만 보면 양쪽 방향의 메시지를 처리할 수 있지만,

    WebSocket처럼 하나의 Full-Duplex 연결을 만드는 방식과는 구조적으로 다릅니다.


    14. 세 가지를 다시 비교해보자

    이제 SSE, WebSocket, Streamable HTTP를 한 번에 비교해보겠습니다.

    SSE

    Server ───────────────────> Client

    특징:

    • Server → Client 스트리밍
    • HTTP 기반
    • 단순한 이벤트 스트림
    • LLM 응답이나 진행 상태 전달에 적합

    WebSocket

    Server <══════════════════> Client

    특징:

    • Full-Duplex
    • 지속적인 연결
    • 양쪽에서 자유롭게 메시지 전송
    • 실시간 상호작용에 적합

    Streamable HTTP

    Client ───── POST ─────────> Server
    Client <──── JSON ────────── Server
    
    필요한 경우
    
    Client <════ SSE ═══════════ Server

    특징:

    • HTTP Request/Response 중심
    • 필요할 때 Streaming
    • SSE 사용 가능
    • RPC 형태의 통신에 적합
    • 기존 HTTP 인프라와 잘 맞음

    즉 셋은 누가 더 좋은 기술인가를 비교하는 관계가 아닙니다.

    해결하려는 문제가 다릅니다.


    15. 실제 AI 서비스에서는 어떻게 사용할까?

    이제 실제 시스템에 적용해봅시다.

    사용자가 웹에서 인보이스를 업로드하고 AI Agent가 이를 분석한다고 가정하겠습니다.

    전체 구조는 다음과 같습니다.

    Browser
       │
       │ POST /analyze
       ▼
    FastAPI
       │
       ▼
    Agent
       │
       │ MCP
       ▼
    MCP Client
       │
       │ Streamable HTTP
       ▼
    MCP Server
       │
       ├── OCR Tool
       ├── Invoice Parser
       └── Validation Tool

    여기서 두 종류의 스트리밍이 존재할 수 있습니다.

    첫 번째는 사용자 경험을 위한 스트리밍입니다.

    FastAPI
       │
       ├── "분석 시작"
       ├── "OCR 진행 중"
       ├── "필드 추출 중"
       └── "완료"
            │
            ▼
          Browser

    이 구간에서는 SSE가 좋은 선택이 될 수 있습니다.

    FastAPI ═════ SSE ═════> Browser

    반면 Agent와 MCP Server 사이에서는 Tool 호출이라는 RPC적인 통신이 발생합니다.

    Agent
      │
      │ tools/call
      ▼
    MCP Server
      │
      │ Tool 실행
      ▼
    Result

    여기에서는 Streamable HTTP가 자연스럽습니다.

    Agent ══ Streamable HTTP ══> MCP Server

    즉 같은 시스템 안에서도 서로 다른 통신 방식이 사용될 수 있습니다.


    16. SSE와 Streamable HTTP는 경쟁 관계가 아니다

    이 시리즈에서 가장 강조하고 싶은 부분입니다.

    처음에는 이렇게 생각하기 쉽습니다.

    SSE vs Streamable HTTP

    마치 Streamable HTTP가 SSE를 대체하기 위해 등장한 새로운 스트리밍 기술처럼 느껴집니다.

    하지만 실제 시스템에서는 이렇게 보는 편이 더 정확합니다.

    Web Application
    
    Browser
       │
       │ SSE
       ▼
    FastAPI
    
    
    Agent System
    
    Agent
       │
       │ Streamable HTTP
       ▼
    MCP Server

    두 기술은 서로 다른 구간에서 서로 다른 문제를 해결할 수 있습니다.

    Browser와 FastAPI 사이에서는 사용자가 작업 진행 상황이나 LLM의 생성 결과를 실시간으로 받아야 할 수 있습니다.

    Browser <════ SSE ════ FastAPI

    이때 SSE는 매우 단순하고 효과적인 방법입니다.

    반면 Agent와 MCP Server 사이에서는 단순한 이벤트 전달보다 Tool 호출, Request/Response, Notification, Session 같은 RPC적인 통신이 중요합니다.

    Agent ──── tools/call ──────> MCP Server
    Agent <──── result ────────── MCP Server

    이런 구간에서는 Streamable HTTP가 더 자연스럽습니다.

    따라서 둘의 관계를

    SSE
     ↓
    구식 기술
    
    Streamable HTTP
     ↓
    새로운 기술

    처럼 이해해서는 안 됩니다.

    오히려 다음과 같이 보는 편이 좋습니다.

    SSE
    │
    └── Server → Client Streaming
    
    
    Streamable HTTP
    │
    ├── HTTP Request / Response
    │
    └── 필요할 경우 SSE Streaming

    그리고 중요한 사실이 하나 있습니다.

    Streamable HTTP 자체도 필요할 때 SSE를 사용합니다.

    즉 SSE는 Streamable HTTP의 경쟁자가 아니라, Streamable HTTP가 스트리밍을 구현할 때 활용할 수 있는 메커니즘이기도 합니다.


    17. 왜 MCP는 이런 구조가 필요했을까?

    이제 다시 MCP의 목적을 생각해봅시다.

    MCP Server는 단순한 스트리밍 서버가 아닙니다.

    AI Agent에게 외부 기능을 제공하는 서버입니다.

    예를 들어 다음과 같은 Tool이 있다고 해보겠습니다.

    search_documents()
    
    analyze_invoice()
    
    send_email()
    
    query_database()
    
    generate_report()

    Agent는 필요한 순간에 특정 Tool을 호출합니다.

    Agent
      │
      │ tools/call
      ▼
    MCP Server
      │
      ▼
    Tool

    대부분의 Tool 호출은 매우 자연스러운 Request/Response 구조를 가집니다.

    Request
    
    "이 Tool을 실행해줘"
    
            ↓
    
    Tool 실행
    
            ↓
    
    Response
    
    "결과는 이것이야"

    그런데 Tool의 특성은 모두 다릅니다.

    어떤 Tool은 100ms 안에 끝날 수 있습니다.

    get_current_time()
    
          ↓
    
       100ms
    
          ↓
    
       Result

    어떤 Tool은 수십 초가 걸릴 수도 있습니다.

    analyze_invoice()
    
          ↓
    
    PDF Rendering
    
          ↓
    
    VLM Analysis
    
          ↓
    
    Field Extraction
    
          ↓
    
    Validation
    
          ↓
    
    Result

    따라서 MCP Transport는 두 가지 상황을 모두 다룰 수 있어야 합니다.

    짧은 작업
       │
       ▼
    Request / Response
    
    
    긴 작업
       │
       ▼
    Request / Streaming / Response

    Streamable HTTP는 바로 이런 특성에 잘 맞습니다.


    18. WebSocket을 기본 Transport로 사용하지 않는 이유도 보인다

    여기까지 이해하면 처음에 했던 질문으로 다시 돌아갈 수 있습니다.

    그냥 WebSocket을 사용하면 더 간단하지 않을까?

    WebSocket을 사용하면 물론 양방향 메시징을 구현할 수 있습니다.

    MCP Client <══════════════> MCP Server

    하지만 MCP의 대부분의 동작은 본질적으로 RPC에 가깝습니다.

    tools/list
    
    tools/call
    
    resources/read
    
    prompts/get

    즉 기본 패턴은 다음과 같습니다.

    Request
       │
       ▼
    Server Processing
       │
       ▼
    Response

    모든 요청을 처리하기 위해 반드시 영구적인 Full-Duplex 연결을 유지해야 하는 것은 아닙니다.

    HTTP가 이미 잘 처리하고 있는 문제를 굳이 다른 통신 모델로 바꿀 필요가 없는 것입니다.

    또 실제 운영 환경을 생각하면 HTTP가 가진 장점도 큽니다.

    Reverse Proxy
    
    Load Balancer
    
    Authentication
    
    HTTP Header
    
    HTTP Status
    
    Observability
    
    Rate Limiting
    
    Existing Infrastructure

    많은 인프라가 이미 HTTP를 중심으로 만들어져 있습니다.

    Streamable HTTP는 이런 생태계를 그대로 활용할 수 있습니다.


    19. 이름에 답이 있다

    이제 다시 이름을 보겠습니다.

    Streamable HTTP

    처음에는 조금 애매하게 느껴졌던 이름이 이제는 꽤 정확하게 보입니다.

    핵심은 이것입니다.

    HTTP를 사용한다. 그리고 필요한 경우 Stream할 수 있다.

    즉,

    HTTP
     │
     ├── 일반 Response 가능
     │
     └── Streaming Response 가능

    입니다.

    항상 연결을 유지하는 것도 아니고,

    항상 SSE를 사용하는 것도 아니며,

    항상 Streaming하는 것도 아닙니다.

    필요한 통신 방식에 따라 HTTP의 Response 형태를 선택할 수 있습니다.

    그래서 Streaming HTTP가 아니라 Streamable HTTP입니다.


    20. 세 기술을 한 문장으로 정리하면

    이제 SSE, WebSocket, Streamable HTTP를 아주 단순하게 정리해보겠습니다.

    SSE

    서버가 클라이언트에게 지속적으로 데이터를 보내고 싶다.

    Server ─────────────────> Client

    LLM 답변, 작업 진행 상황, 알림 등에 잘 맞습니다.


    WebSocket

    클라이언트와 서버가 지속적으로 서로 메시지를 주고받고 싶다.

    Server <════════════════> Client

    채팅, 게임, 협업 시스템처럼 지속적인 Full-Duplex 통신에 잘 맞습니다.


    Streamable HTTP

    HTTP Request/Response를 기본으로 사용하면서 필요한 경우 스트리밍도 하고 싶다.

    Client ───── Request ─────> Server
    Client <──── Response ───── Server
    
              또는
    
    Client ───── Request ─────> Server
    Client <════ SSE Stream ═══ Server

    RPC 기반의 MCP 통신에 잘 맞습니다.


    21. 실제 시스템에서는 함께 사용한다

    중요한 것은 하나의 기술을 선택해서 시스템 전체에 적용해야 하는 것이 아니라는 점입니다.

    예를 들어 AI 기반 인보이스 분석 서비스를 만든다고 생각해보겠습니다.

    ┌──────────────┐
    │   Browser    │
    └──────┬───────┘
           │
           │ HTTP
           ▼
    ┌──────────────┐
    │   FastAPI    │
    └──────┬───────┘
           │
           │
           ▼
    ┌──────────────┐
    │    Agent     │
    └──────┬───────┘
           │
           │ MCP
           ▼
    ┌──────────────┐
    │  MCP Server  │
    └──────┬───────┘
           │
           ├── OCR Tool
           ├── Parser Tool
           └── Validation Tool

    여기서 Browser와 FastAPI 사이에서는 사용자에게 진행 상황을 보여주고 싶을 수 있습니다.

    Browser <════ SSE ════ FastAPI
    
    "파일 업로드 완료"
    
    "OCR 진행 중"
    
    "데이터 추출 중"
    
    "검증 중"
    
    "완료"

    반면 Agent와 MCP Server 사이에서는 Tool 호출이 이루어집니다.

    Agent
      │
      │ tools/call
      ▼
    MCP Server
      │
      ▼
    OCR Tool

    이 구간에서는 Streamable HTTP를 사용할 수 있습니다.

    Browser
       │
       │ SSE
       ▼
    FastAPI
       │
       ▼
    Agent
       │
       │ Streamable HTTP
       ▼
    MCP Server

    이 그림을 보면 SSE와 Streamable HTTP를 왜 단순 비교해서는 안 되는지 명확해집니다.

    사용되는 계층과 해결하는 문제가 다르기 때문입니다.


    22. 결국 중요한 것은 Transport가 아니라 요구사항이다

    개발하다 보면 새로운 기술이 등장할 때마다 이런 질문을 하게 됩니다.

    SSE가 좋은가?
    
    WebSocket이 좋은가?
    
    Streamable HTTP가 좋은가?

    하지만 사실 이 질문에는 정답이 없습니다.

    먼저 물어야 하는 것은 이것입니다.

    데이터는 어느 방향으로 흐르는가?
    
    연결을 계속 유지해야 하는가?
    
    Request / Response 관계가 중요한가?
    
    서버가 임의의 시점에 메시지를 보내야 하는가?
    
    스트리밍이 항상 필요한가?
    
    세션 상태를 유지해야 하는가?
    
    기존 HTTP 인프라를 활용해야 하는가?

    이 요구사항이 정해진 뒤 Transport를 선택해야 합니다.

    예를 들어 단순한 LLM 스트리밍이라면:

    SSE

    만으로 충분할 수 있습니다.

    실시간 협업 시스템이라면:

    WebSocket

    이 자연스러울 수 있습니다.

    Agent와 Tool Server 사이의 RPC 통신이라면:

    Streamable HTTP

    가 좋은 선택이 될 수 있습니다.

    기술을 먼저 선택하고 시스템을 거기에 맞추는 것이 아니라,

    통신의 특성을 먼저 이해하고 그에 맞는 기술을 선택하는 것이 중요합니다.


    마치며

    이번 시리즈는 아주 단순한 질문에서 시작했습니다.

    HTTP는 Response를 한 번 보내는데 어떻게 데이터를 계속 전달할 수 있을까?

    1부에서는 그 답으로 SSE를 살펴봤습니다.

    HTTP Response
       │
       ├── data
       ├── data
       ├── data
       └── end

    그리고 2부에서는 SSE만으로 모든 통신 문제를 해결할 수 없다는 것을 살펴봤습니다.

    복잡한 AI 시스템에서는 단순한 스트리밍뿐 아니라 다음과 같은 메시지의 관계가 중요했습니다.

    Request
    
    Response
    
    Notification
    
    Streaming
    
    Session

    그리고 이번 3부에서는 MCP가 왜 Streamable HTTP라는 방식을 사용하는지 살펴봤습니다.

    Streamable HTTP의 핵심은 의외로 단순합니다.

    HTTP Request/Response를 기본으로 사용하고, 필요한 경우 스트리밍할 수 있도록 한다.

    그래서 일반적인 요청은 평범한 HTTP Response로 끝날 수 있습니다.

    Request
       │
       ▼
    JSON Response

    하지만 스트리밍이 필요하다면 SSE를 사용할 수도 있습니다.

    Request
       │
       ▼
    SSE Stream
       │
       ├── message
       ├── message
       ├── message
       └── end

    즉 Streamable HTTP는 SSE를 버린 것이 아닙니다.

    오히려 HTTP와 SSE를 필요한 상황에 맞게 활용할 수 있도록 Transport 구조를 정리한 것에 가깝습니다.

    그리고 이 구조는 MCP처럼 다양한 Tool을 호출하는 AI Agent 시스템과 잘 맞습니다.

    Browser
       │
       │ SSE
       ▼
    FastAPI
       │
       ▼
    Agent
       │
       │ Streamable HTTP
       ▼
    MCP Server
       │
       ├── Tool
       ├── Tool
       └── Tool

    결국 중요한 것은 어떤 기술이 더 최신인가가 아닙니다.

    어떤 구간에서 어떤 종류의 통신이 필요한가를 이해하는 것입니다.

    SSE, WebSocket, Streamable HTTP는 서로를 대체하기 위해 존재하는 기술이라기보다 각자 다른 통신 문제를 해결하기 위한 도구입니다.

    이 차이를 이해하면 AI Agent와 MCP 기반 시스템을 설계할 때 Transport를 훨씬 명확하게 선택할 수 있습니다.


    시리즈 정리

    1부

    HTTP 연결 하나로 데이터를 계속 보내는 SSE

    HTTP Response와 Streaming의 기본 원리를 살펴봤습니다.

    2부

    SSE만으로는 부족한가? 양방향 통신과 RPC의 문제

    SSE와 WebSocket의 차이, 그리고 MCP에서 Request/Response와 Notification이 왜 중요한지 살펴봤습니다.

    3부

    MCP는 왜 Streamable HTTP를 사용하는가

    HTTP Request/Response와 SSE Streaming을 함께 활용하는 Streamable HTTP의 구조와 MCP에서 이 방식이 필요한 이유를 살펴봤습니다.

  • SSE와 Streamable HTTP 2부 — SSE만으로는 부족한가? 양방향 통신과 RPC의 문제

    SSE와 Streamable HTTP 2부 — SSE만으로는 부족한가? 양방향 통신과 RPC의 문제

    1부에서는 SSE(Server-Sent Events)가 어떻게 하나의 HTTP Response를 이용해 서버에서 클라이언트로 데이터를 계속 전달할 수 있는지 살펴봤습니다.

    핵심은 단순했습니다.

    HTTP Response는 반드시 한 번에 전달될 필요가 없다.

    하나의 HTTP Response를 종료하지 않고 데이터를 조금씩 전달하면 서버는 클라이언트에게 지속적으로 이벤트를 보낼 수 있습니다.

    Client                         Server
       │                              │
       │──── HTTP Request ───────────>│
       │                              │
       │<──── data: message 1 ────────│
       │<──── data: message 2 ────────│
       │<──── data: message 3 ────────│
       │<──── data: done ─────────────│
       │                              │

    LLM의 답변 스트리밍이나 작업 진행 상태를 전달하는 용도라면 이 구조만으로도 상당히 많은 문제를 해결할 수 있습니다.

    그런데 시스템이 조금 더 복잡해지면 질문이 하나 생깁니다.

    서버만 계속 데이터를 보내면 충분할까?

    이번 글에서는 이 질문에서 시작해보겠습니다.


    1. SSE의 방향은 기본적으로 Server → Client다

    SSE의 데이터 흐름은 기본적으로 단방향입니다.

    Server ─────────────────────> Client

    서버가 이벤트를 생성하고 클라이언트가 이를 받습니다.

    예를 들어 LLM 서비스라면 이런 구조가 자연스럽습니다.

    Client
       │
       │ POST /question
       ▼
    Server
       │
       │ LLM 실행
       │
       ├──── token
       ├──── token
       ├──── token
       └──── done
             │
             ▼
           Client

    질문은 일반적인 HTTP Request로 보내고, 생성되는 결과는 스트림으로 받습니다.

    파일 분석 서비스도 비슷합니다.

    Client
       │
       │ PDF Upload
       ▼
    Server
       │
       ├── parsing...
       ├── OCR...
       ├── analyzing...
       ├── extracting...
       └── completed
             │
             ▼
           Client

    이런 상황에서는 서버에서 클라이언트 방향의 데이터 흐름이 대부분이기 때문에 SSE가 매우 잘 맞습니다.

    하지만 모든 시스템이 이렇게 단순하지는 않습니다.


    2. 클라이언트도 계속 메시지를 보내야 한다면?

    이번에는 채팅 시스템을 생각해봅시다.

    사용자가 메시지를 보내고 서버가 응답합니다.

    그런데 응답이 끝나기 전에 사용자가 작업을 취소할 수도 있습니다.

    Client                         Server
       │                              │
       │──── question ───────────────>│
       │                              │
       │<──── token ──────────────────│
       │<──── token ──────────────────│
       │                              │
       │──── cancel ─────────────────>│
       │                              │
       │<──── cancelled ──────────────│

    조금 더 복잡한 Agent 시스템에서는 이런 흐름도 생길 수 있습니다.

    Client                         Agent
       │                              │
       │──── task ───────────────────>│
       │                              │
       │<──── processing ─────────────│
       │                              │
       │<──── approval_required ──────│
       │                              │
       │──── approve ────────────────>│
       │                              │
       │<──── processing ─────────────│
       │                              │
       │<──── completed ──────────────│

    이제 통신 방향이 한쪽만이 아닙니다.

    Client <────────────────────> Server

    이쯤 되면 자연스럽게 떠오르는 기술이 있습니다.

    WebSocket입니다.


    3. 그러면 그냥 WebSocket을 쓰면 되지 않을까?

    WebSocket은 클라이언트와 서버가 하나의 연결을 유지하면서 양방향으로 메시지를 주고받을 수 있도록 합니다.

    Client                         Server
       │                              │
       │<═══════ WebSocket ═════════>│
       │                              │
       │──── message ────────────────>│
       │<──── message ────────────────│
       │──── message ────────────────>│
       │<──── message ────────────────│

    SSE와 비교하면 차이가 분명합니다.

    SSE
    
    Server ─────────────────────> Client
    
    
    WebSocket
    
    Server <────────────────────> Client

    실시간 채팅, 멀티플레이 게임, 공동 편집, 실시간 제어처럼 양쪽에서 지속적으로 메시지가 발생하는 시스템이라면 WebSocket은 매우 자연스러운 선택입니다.

    그렇다면 여기서 이런 의문이 생깁니다.

    MCP 같은 시스템도 Client와 Server가 계속 통신해야 하는데 그냥 WebSocket을 사용하면 되지 않을까?

    기술적으로는 가능합니다.

    하지만 여기에는 조금 다른 문제가 있습니다.


    4. 모든 통신이 양방향 스트림일 필요는 없다

    MCP Client가 MCP Server에게 Tool 목록을 요청한다고 생각해봅시다.

    MCP Client                    MCP Server
        │                             │
        │──── tools/list ────────────>│
        │                             │
        │<──── tool list ─────────────│
        │                             │

    이것은 전형적인 Request/Response입니다.

    Tool을 호출하는 경우도 비슷합니다.

    MCP Client                    MCP Server
        │                             │
        │──── tools/call ────────────>│
        │                             │
        │        Tool 실행            │
        │                             │
        │<──── result ────────────────│

    이런 요청을 처리하기 위해 반드시 장시간 유지되는 완전한 양방향 메시징 채널이 필요한 것은 아닙니다.

    HTTP가 이미 아주 잘하는 방식이 있습니다.

    Request
       │
       ▼
    Server
       │
       ▼
    Response

    그렇다면 기존 HTTP Request/Response 모델을 버릴 이유가 있을까요?

    오히려 필요한 것은 이런 구조일 수 있습니다.

    일반적인 요청
    
    Client ─── Request ─────────> Server
    Client <── Response ───────── Server
    
    
    스트리밍이 필요한 요청
    
    Client ─── Request ─────────> Server
    Client <── event ──────────── Server
    Client <── event ──────────── Server
    Client <── event ──────────── Server
    Client <── result ─────────── Server

    즉,

    평소에는 HTTP Request/Response를 사용하고, 필요할 때만 Response를 스트리밍할 수 있으면 어떨까?

    여기서 중요한 관점의 변화가 시작됩니다.


    5. MCP 통신은 단순한 채팅이 아니다

    MCP Client와 Server 사이에서는 다양한 종류의 메시지가 오갈 수 있습니다.

    예를 들어 다음과 같습니다.

    initialize
    
    tools/list
    
    tools/call
    
    resources/list
    
    resources/read

    그리고 모든 요청의 특성이 같지는 않습니다.

    어떤 요청은 즉시 끝날 수 있습니다.

    tools/list
        │
        ▼
    200 OK

    반면 어떤 Tool은 오래 걸릴 수 있습니다.

    tools/call
        │
        ▼
    PDF 분석
        │
        ▼
    OCR
        │
        ▼
    데이터 추출
        │
        ▼
    검증
        │
        ▼
    Result

    또 경우에 따라 서버에서 클라이언트로 별도의 메시지를 전달해야 할 수도 있습니다.

    즉 MCP 통신에는 다음과 같은 성격이 함께 존재합니다.

    Request / Response
    
    Notification
    
    Streaming

    이것이 단순한 SSE와 WebSocket의 선택 문제만으로 보기 어려운 이유입니다.


    6. RPC 관점에서 생각해보자

    여기서 RPC라는 개념을 잠깐 살펴볼 필요가 있습니다.

    RPC는 Remote Procedure Call의 약자입니다.

    이름 그대로 다른 프로세스나 다른 서버에 있는 기능을 마치 함수를 호출하듯 사용하는 개념입니다.

    로컬 Python 함수라면 다음과 같이 호출할 수 있습니다.

    result = analyze_invoice("invoice.pdf")

    하지만 analyze_invoice()가 다른 서버에 있다면 직접 호출할 수 없습니다.

    네트워크를 통해 요청해야 합니다.

    Agent
      │
      │ analyze_invoice("invoice.pdf")
      ▼
    Network
      │
      ▼
    MCP Server
      │
      ▼
    analyze_invoice()

    논리적으로는 함수 호출처럼 보이지만 실제로는 네트워크 메시지가 오갑니다.

    Client                           Server
       │                                │
       │──── method: analyze_invoice ──>│
       │                                │
       │            실행                │
       │                                │
       │<──── result ───────────────────│

    MCP 역시 이런 RPC적인 성격을 가지고 있습니다.

    Client가 Server에게 특정 기능의 실행을 요청하고 결과를 받습니다.


    7. 요청과 응답을 어떻게 구분할까?

    네트워크에서는 여러 요청이 동시에 발생할 수도 있습니다.

    Client                         Server
       │                              │
       │──── Request A ──────────────>│
       │──── Request B ──────────────>│
       │──── Request C ──────────────>│
       │                              │

    그런데 처리 시간이 모두 같다는 보장은 없습니다.

    Request A ───────────────── Result A
    
    Request B ─── Result B
    
    Request C ───────── Result C

    Request B가 A보다 늦게 들어왔지만 먼저 끝날 수도 있습니다.

    그래서 RPC에서는 요청을 식별할 수 있는 ID가 중요합니다.

    예를 들어 JSON-RPC에서는 개념적으로 다음과 같은 요청을 보낼 수 있습니다.

    {
      "jsonrpc": "2.0",
      "id": 10,
      "method": "tools/call",
      "params": {
        "name": "analyze_invoice"
      }
    }

    서버의 응답에는 같은 ID가 포함됩니다.

    {
      "jsonrpc": "2.0",
      "id": 10,
      "result": {
        "status": "completed"
      }
    }

    그러면 Client는 알 수 있습니다.

    Request id=10
          │
          ▼
      MCP Server
          │
          ▼
    Response id=10

    즉,

    이 Response는 내가 보냈던 id=10 요청의 결과구나.

    이렇게 Request와 Response를 연결할 수 있습니다.


    8. Notification은 조금 다르다

    모든 메시지가 Response를 요구하는 것도 아닙니다.

    상대방에게 어떤 사실을 알려주기만 하면 되는 메시지도 있습니다.

    Client                         Server
       │                              │
       │<──── Notification ───────────│
       │                              │

    Notification은 일반적인 RPC Request와 달리 응답을 요구하지 않습니다.

    따라서 통신 구조는 점점 다양해집니다.

    Request
       │
       └────────> Response
    
    
    Notification
       │
       └────────> No Response
    
    
    Long-running Request
       │
       ├────────> Progress
       ├────────> Progress
       ├────────> Progress
       └────────> Result

    이제 단순히

    Server → Client

    또는

    Server ↔ Client

    만으로 설명하기에는 부족합니다.


    9. 중요한 것은 방향만이 아니라 메시지의 성격이다

    SSE와 WebSocket을 비교하다 보면 흔히 통신 방향에만 집중하게 됩니다.

    SSE       : Server → Client
    
    WebSocket : Server ↔ Client

    물론 중요한 차이입니다.

    하지만 MCP 같은 RPC 시스템에서는 또 다른 질문이 중요합니다.

    이 메시지는 무엇을 의미하는가?

    예를 들어 다음을 구분해야 합니다.

    Request인가?
    
    Response인가?
    
    Notification인가?
    
    중간 진행 상황인가?
    
    최종 결과인가?

    즉 통신 채널뿐만 아니라 메시지의 의미와 생명주기도 관리해야 합니다.


    10. Agent 시스템에서는 더 복잡해진다

    AI Agent를 생각하면 이 문제가 더욱 명확해집니다.

    예를 들어 사용자가 인보이스 PDF를 업로드했다고 해봅시다.

    User
     │
     │ invoice.pdf
     ▼
    Agent

    Agent는 MCP Tool을 호출합니다.

    Agent
     │
     │ tools/call
     ▼
    MCP Server
     │
     ▼
    Invoice Tool

    그런데 분석 과정에서는 여러 단계가 발생할 수 있습니다.

    Invoice Tool
         │
         ▼
      Parsing
         │
         ▼
        OCR
         │
         ▼
    Field Extraction
         │
         ▼
     Validation
         │
         ▼
       Result

    어떤 작업은 100ms 만에 끝날 수도 있고, 어떤 작업은 20초가 걸릴 수도 있습니다.

    심지어 중간에 사용자 확인이 필요할 수도 있습니다.

    Agent
      │
      │ tools/call
      ▼
    MCP Server
      │
      ├── OCR
      │
      ├── Extraction
      │
      └── Human Review Required
                  │
                  ▼
                 User
                  │
               Approve
                  │
                  ▼
               Continue

    이런 시스템에서는 단순히 “연결 하나를 열어놓자”만으로 문제가 해결되지 않습니다.

    요청과 응답의 관계, 상태, 이벤트, 스트리밍 등을 함께 고려해야 합니다.


    11. 그렇다면 우리가 원하는 통신 방식은?

    지금까지의 요구사항을 정리해보겠습니다.

    우리는 기존 HTTP의 장점을 활용하고 싶습니다.

    POST
    GET
    HTTP Status
    Authentication
    Proxy
    Load Balancer

    단순한 요청이라면 평범하게 처리하고 싶습니다.

    Request
       │
       ▼
    Response

    하지만 필요한 경우에는 스트리밍도 하고 싶습니다.

    Request
       │
       ▼
    Response
       │
       ├── event
       ├── event
       ├── event
       └── result

    그리고 서버에서 발생하는 Notification도 처리할 수 있어야 합니다.

    결국 우리가 원하는 모습은 대략 이렇습니다.

                 HTTP
    
    Client ───── POST ───────────> Server
    Client <──── JSON ──────────── Server
    
    
           필요할 때 Streaming
    
    Client ───── Request ────────> Server
    Client <──── Event ─────────── Server
    Client <──── Event ─────────── Server
    Client <──── Result ────────── Server

    여기서 재미있는 질문이 하나 생깁니다.

    HTTP Request/Response의 단순함은 유지하면서 필요할 때만 스트리밍할 수는 없을까?

    바로 이 질문이 Streamable HTTP를 이해하는 출발점입니다.


    12. Streaming HTTP가 아니라 Streamable HTTP

    이름을 자세히 보면 재미있는 부분이 있습니다.

    Streaming HTTP가 아니라 Streamable HTTP입니다.

    이 차이가 꽤 중요합니다.

    모든 통신을 항상 스트리밍한다는 의미가 아닙니다.

    필요하다면 일반적인 HTTP Response를 사용할 수 있습니다.

    Request
       │
       ▼
    JSON Response

    그리고 필요한 경우에는 스트리밍 Response를 사용할 수도 있습니다.

    Request
       │
       ▼
    Streaming Response
       │
       ├── event
       ├── event
       ├── event
       └── end

    즉 핵심은 항상 Streaming이 아니라 Streamable, 다시 말해 필요하면 스트리밍할 수 있다는 것입니다.

    그리고 이것이 다음 편에서 살펴볼 핵심 주제입니다.


    마치며

    1부에서는 SSE를 통해 이런 사실을 확인했습니다.

    하나의 HTTP Response는 데이터를 조금씩 전달할 수 있다.

    이번 2부에서는 여기서 한 단계 더 나아갔습니다.

    SSE는 Server → Client 스트리밍에 매우 유용하지만, MCP 같은 RPC 시스템에서는 단순한 데이터 방향만으로는 충분하지 않습니다.

    우리가 다뤄야 하는 것은 다음과 같은 것들입니다.

    Request
    Response
    Notification
    Streaming
    Session

    WebSocket처럼 완전한 양방향 채널을 만드는 것도 하나의 방법입니다.

    하지만 모든 요청이 지속적인 양방향 통신을 필요로 하는 것은 아닙니다.

    오히려 이런 질문을 해볼 수 있습니다.

    HTTP의 단순한 Request/Response 구조는 그대로 사용하면서, 정말 필요한 순간에만 스트리밍할 수는 없을까?

    이 질문에 대한 답이 Streamable HTTP입니다.

    다음 3부에서는 드디어 Streamable HTTP의 구조를 본격적으로 살펴보겠습니다.

    왜 MCP가 이 방식을 사용하게 되었는지, 일반 HTTP 요청과 SSE가 어떻게 하나의 Transport 안에서 공존하는지, 그리고 기존 SSE 기반 MCP Transport와 무엇이 달라졌는지를 구조적으로 살펴보겠습니다.


    다음 편

    SSE와 Streamable HTTP 3부 — MCP는 왜 Streamable HTTP를 사용하는가

  • SSE와 Streamable HTTP 1부 — HTTP 연결 하나로 데이터를 계속 보내는 SSE

    SSE와 Streamable HTTP 1부 — HTTP 연결 하나로 데이터를 계속 보내는 SSE

    LLM을 이용한 서비스를 개발하다 보면 자연스럽게 스트리밍(Streaming)이라는 말을 접하게 됩니다.

    ChatGPT에 질문을 입력했을 때를 생각해봅시다. 답변 전체가 완성될 때까지 기다렸다가 한꺼번에 화면에 나타나는 것이 아니라, 생성되는 내용이 조금씩 화면에 나타납니다.

    Redis
    Redis Streams는
    Redis Streams는 메시지를
    Redis Streams는 메시지를 순서대로...

    서버에서는 아직 답변을 만들고 있는데 클라이언트는 이미 그 일부를 받고 있습니다. 이것이 우리가 흔히 말하는 스트리밍 응답(Streaming Response)입니다.

    그런데 여기서 한 가지 궁금증이 생깁니다.

    HTTP는 요청(Request)을 보내면 응답(Response)을 한 번 받는 프로토콜 아닌가?

    그렇다면 서버는 어떻게 하나의 HTTP 요청에 데이터를 여러 번 보내는 것처럼 동작할 수 있을까요? 이 질문을 이해하면 SSE(Server-Sent Events)의 동작 방식도 자연스럽게 이해할 수 있습니다.


    1. 우리가 익숙한 HTTP 요청과 응답

    일반적인 HTTP API는 다음과 같이 동작합니다.

    Client                              Server
       │                                   │
       │──── POST /question ──────────────>│
       │                                   │
       │                                   │ 처리
       │                                   │ 처리
       │                                   │ 처리
       │                                   │
       │<──────── Response ────────────────│
       │                                   │

    클라이언트가 요청을 보내면 서버가 작업을 수행합니다. 작업이 끝나면 서버는 결과를 응답으로 돌려줍니다.

    예를 들어 FastAPI에서 다음과 같은 API가 있다고 해봅시다.

    @app.post("/question")
    async def question():
        result = await generate_answer()
        return {"answer": result}

    generate_answer()가 10초 걸린다면 사용자는 10초 동안 아무것도 받지 못합니다.

    0초    질문 전송
     │
     │      서버 처리 중...
     │
    10초   전체 답변 수신

    일반적인 REST API에서는 별문제가 아닙니다. 하지만 LLM처럼 처리 시간이 길면서 중간 결과를 사용자에게 보여줄 수 있는 서비스에서는 이야기가 달라집니다.


    2. LLM은 이미 결과를 만들고 있다

    LLM이 다음과 같은 답변을 생성한다고 해봅시다.

    Redis Streams는 메시지를 순서대로 저장하고
    여러 Consumer가 이를 처리할 수 있도록 제공하는
    Redis의 메시징 기능입니다.

    모델이 10초 동안 아무것도 하지 않다가 마지막 순간에 문장 전체를 갑자기 만들어내는 것은 아닙니다. 출력 토큰은 순차적으로 생성됩니다.

    1초  → "Redis"
    2초  → " Streams는"
    3초  → " 메시지를"
    4초  → " 순서대로"
    ...

    그렇다면 서버는 전체 답변이 완성될 때까지 기다리지 않고, 생성되는 데이터를 클라이언트에게 바로 전달할 수 있습니다.

    LLM
     │
     ├── Redis
     ├── Streams는
     ├── 메시지를
     └── 순서대로...
           │
           ▼
         Client

    여기서 필요한 것이 HTTP Streaming입니다.


    3. HTTP 응답은 반드시 한 번에 보내야 할까?

    HTTP 요청 하나에는 HTTP 응답 하나가 대응합니다. 하지만 HTTP 응답 하나를 반드시 한 번에 전부 보내야 하는 것은 아닙니다.

    일반적인 응답은 다음과 같습니다.

    HTTP/1.1 200 OK
    Content-Type: application/json
    
    {"answer":"Redis Streams는 ..."}

    반면 서버가 응답을 바로 종료하지 않고 데이터를 조금씩 전달할 수도 있습니다.

    HTTP Response 시작
            │
            ├── 데이터 A
            ├── 데이터 B
            ├── 데이터 C
            ├── 데이터 D
            │
            └── Response 종료

    중요한 점은 응답을 네 번 보낸 것이 아니라는 것입니다. HTTP Response는 여전히 하나입니다.

    Request 1개
          │
          ▼
    Response 1개
          ├── chunk
          ├── chunk
          ├── chunk
          └── chunk

    단지 Response Body가 한꺼번에 전달되지 않고 점진적으로 전달되는 것입니다. 이 개념이 SSE를 이해하는 핵심입니다.


    4. SSE(Server-Sent Events)

    SSE는 서버에서 클라이언트 방향으로 이벤트를 전달하기 위한 방식입니다.

    Server ────────────────> Client

    서버는 HTTP 응답을 유지하면서 클라이언트에게 이벤트를 계속 전달합니다.

    Client                              Server
       │                                   │
       │──── GET /events ─────────────────>│
       │                                   │
       │<──── data: hello ─────────────────│
       │<──── data: processing ────────────│
       │<──── data: result ────────────────│
       │<──── data: done ──────────────────│
       │                                   │

    HTTP 요청이 계속 발생하는 것이 아닙니다. 처음 만들어진 HTTP 연결을 통해 하나의 Response가 계속 전달되고 있는 것입니다.


    5. SSE의 text/event-stream

    일반적인 JSON API는 다음과 같은 Content-Type을 사용합니다.

    Content-Type: application/json

    SSE에서는 다음을 사용합니다.

    Content-Type: text/event-stream

    실제 데이터는 대략 다음과 같은 형식으로 전달됩니다.

    data: hello
    
    data: processing
    
    data: result
    
    data: done

    각 이벤트는 빈 줄로 구분됩니다. 이벤트 이름과 JSON 데이터도 사용할 수 있습니다.

    event: progress
    data: {"progress": 30}
    
    event: progress
    data: {"progress": 70}
    
    event: complete
    data: {"result": "finished"}

    6. FastAPI에서는 어떻게 구현할까?

    FastAPI에서는 StreamingResponse를 이용할 수 있습니다.

    from fastapi import FastAPI
    from fastapi.responses import StreamingResponse
    import asyncio
    
    app = FastAPI()
    
    async def event_generator():
        for i in range(5):
            yield f"data: message {i}\n\n"
            await asyncio.sleep(1)
    
    @app.get("/stream")
    async def stream():
        return StreamingResponse(
            event_generator(),
            media_type="text/event-stream"
        )

    여기서 중요한 부분은 yield입니다. return은 값을 반환하고 함수를 종료하지만, yield는 값을 하나 내보낸 뒤 실행 상태를 유지합니다.

    event_generator()
           │
           ├── yield message 0
           │      잠시 중단
           ├── yield message 1
           │      잠시 중단
           ├── yield message 2
           │      ...
           └── 종료

    그래서 서버가 데이터를 생성하는 즉시 HTTP Response Body에 조금씩 전달하는 스트리밍 처리와 잘 어울립니다.


    7. LLM과 SSE가 잘 어울리는 이유

    개념적인 코드는 다음과 같습니다.

    async def generate():
        async for token in llm.stream(prompt):
            yield f"data: {token}\n\n"

    전체 데이터 흐름은 다음과 같습니다.

    LLM
     │ token 생성
     ▼
    Python Async Iterator
     │ yield
     ▼
    StreamingResponse
     │
     ▼
    HTTP
     │
     ▼
    Browser

    LLM이 데이터를 생성할 때마다 서버가 받아 클라이언트에게 바로 전달할 수 있습니다.


    8. SSE가 정말 데이터를 여러 번 보내는 것일까?

    겉으로는 서버가 메시지를 계속 보내는 것처럼 보입니다. 하지만 SSE는 기본적으로 하나의 HTTP Response를 이용합니다.

    Client
       │
       │ HTTP Request
       ▼
    Server
       │
       ▼
    HTTP Response
    ┌───────────────────────────────┐
    │ data: message 1               │
    │                               │
    │ data: message 2               │
    │                               │
    │ data: message 3               │
    │                               │
    │ data: message 4               │
    └───────────────────────────────┘

    새로운 Response가 계속 만들어지는 것이 아닙니다. 하나의 Response가 아직 끝나지 않은 것입니다.


    9. SSE는 양방향 통신이 아니다

    SSE 스트림 자체의 데이터 흐름은 기본적으로 서버에서 클라이언트 방향입니다.

    Server ────────────────> Client

    반면 WebSocket은 연결 이후 양쪽에서 메시지를 주고받을 수 있습니다.

    Client <──────────────> Server

    SSE를 사용하면서 클라이언트가 서버로 데이터를 보내야 한다면 별도의 HTTP 요청을 사용할 수 있습니다.

                 HTTP POST
    Client ──────────────────────> Server
    
                    SSE
    Client <────────────────────── Server

    이 차이는 이후 WebSocket과 Streamable HTTP를 이해할 때 중요합니다.


    10. SSE가 특히 잘 맞는 상황

    SSE는 서버에서 발생하는 정보를 클라이언트가 지속적으로 받아야 하는 상황에 잘 맞습니다.

    • LLM 답변 스트리밍
    • Agent 작업 진행 상태
    • 파일 분석 진행률
    • 실시간 알림
    • 로그 스트리밍
    • 장시간 작업 상태 전달

    예를 들어 AI 문서 분석 서비스에서는 다음과 같은 진행 상태를 전달할 수 있습니다.

    사용자
      │ PDF 업로드
      ▼
    Server
      │
      ├── 업로드 완료
      ├── OCR 시작
      ├── OCR 완료
      ├── 데이터 분석 중
      ├── 필드 추출 완료
      └── 분석 완료
            │
            ▼
          Browser

    11. 그렇다면 WebSocket을 쓰면 되지 않을까?

    WebSocket도 훌륭한 선택입니다. 특히 클라이언트와 서버가 지속적으로 양방향 메시지를 교환해야 한다면 WebSocket이 자연스러운 경우가 많습니다.

    하지만 모든 스트리밍 문제에 양방향 연결이 필요한 것은 아닙니다. LLM 답변처럼 대부분의 데이터가 서버에서 클라이언트 방향으로 흐른다면 HTTP 기반의 SSE만으로도 충분할 수 있습니다.


    12. 그런데 문제가 하나 있다

    AI Agent가 MCP Server와 통신한다고 생각해봅시다.

    Agent
      │
      ├── initialize
      ├── tools/list
      ├── tools/call
      └── tools/call
            │
            ▼
        MCP Server

    여기서는 단순한 Server → Client 스트리밍을 넘어 요청, 응답, 알림, 스트리밍, 세션 같은 통신 요구사항을 함께 생각해야 합니다.

    Request
    Response
    Notification
    Streaming
    Session

    그리고 여기서 Streamable HTTP 이야기가 시작됩니다.


    마치며

    SSE를 이해할 때 가장 중요한 것은 data: 문법이나 FastAPI의 StreamingResponse 사용법이 아닙니다.

    HTTP Response는 반드시 한 번에 전달될 필요가 없다.

    HTTP 요청 하나에 응답 하나가 대응한다는 기본 구조는 그대로 유지됩니다. 다만 그 하나의 Response를 바로 끝내지 않고 데이터를 조금씩 전달할 수 있습니다.

    Request
       │
       ▼
    Response
       │
       ├── data
       ├── data
       ├── data
       ├── data
       └── end

    SSE는 이 특성을 이용해 서버에서 클라이언트로 이벤트를 지속적으로 전달합니다. 그래서 LLM 스트리밍, 작업 진행 상태, Agent 실행 로그처럼 서버에서 계속 발생하는 데이터를 사용자에게 전달해야 하는 상황에서 유용합니다.

    다음 편에서는 SSE만으로는 무엇이 부족한지, WebSocket과는 어떤 차이가 있는지, 그리고 왜 MCP의 통신 구조를 이해하려면 단순한 Server → Client 스트리밍을 넘어 생각해야 하는지 살펴보겠습니다.


    다음 편

    SSE와 Streamable HTTP 2부 — SSE만으로는 부족한가? 양방향 통신과 RPC의 문제