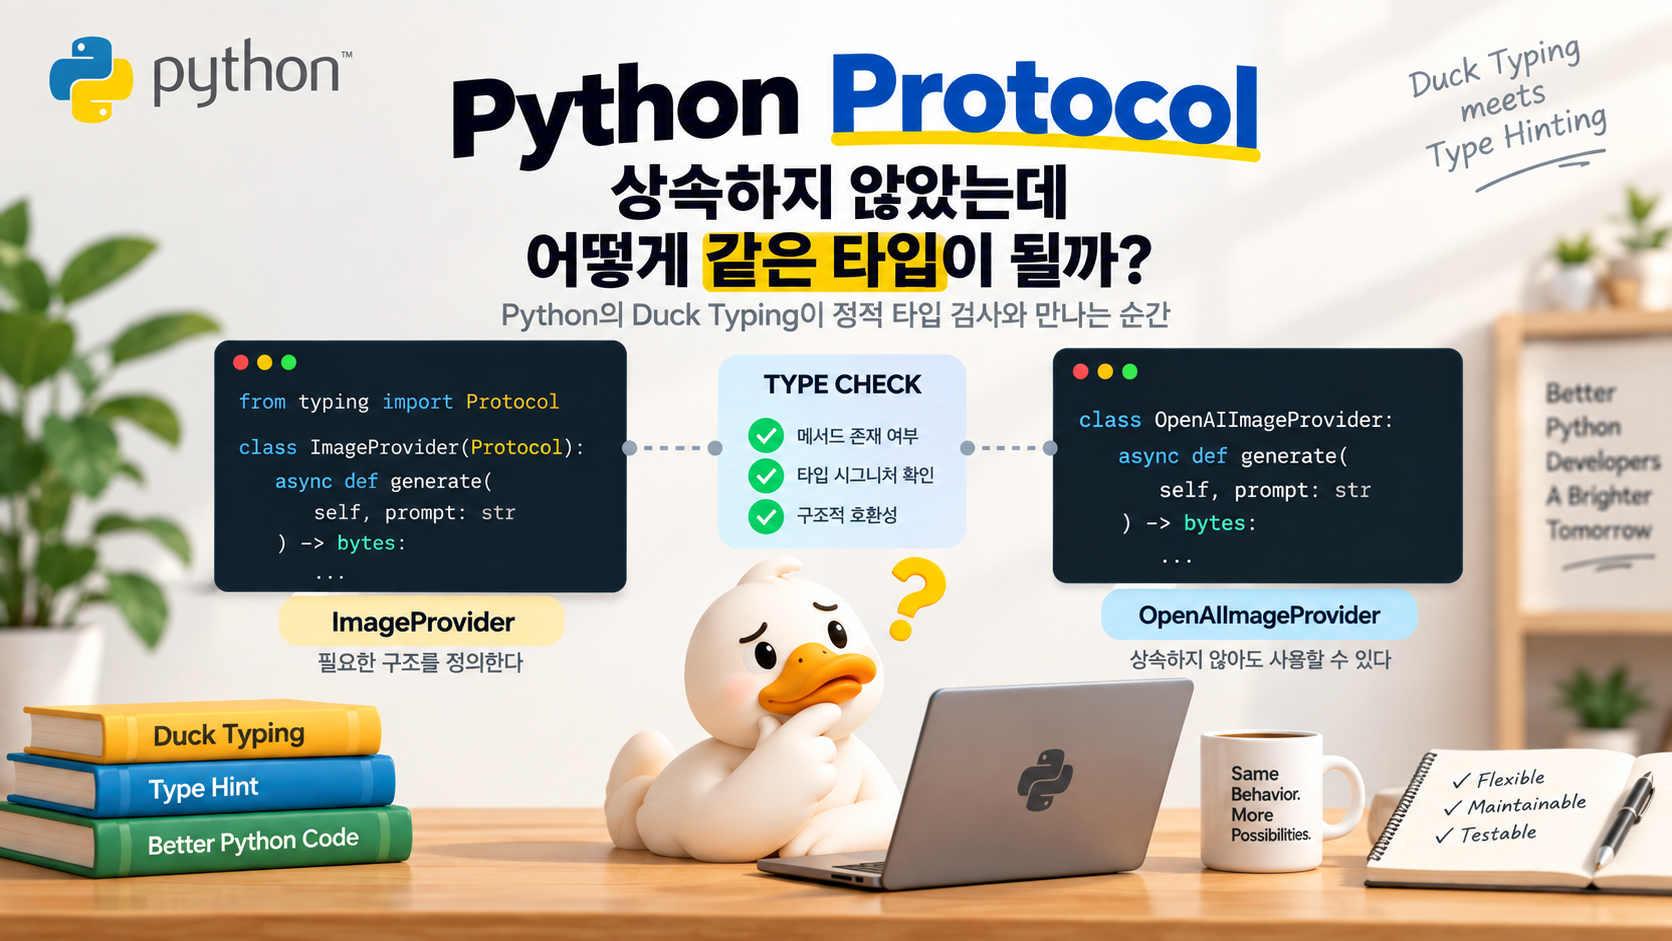
Python Protocol을 파헤쳐보다 — 1부
요즘은 직접 코드를 작성하는 시간보다 AI가 작성한 코드를 리뷰하는 시간이 점점 늘어나고 있다.
나 역시 최근에는 요구사항을 Codex에게 전달하고, 작성된 코드를 리뷰하면서 수정하거나 다음 작업을 지시하는 방식으로 개발하는 경우가 많다.
흔히 말하는 바이브 코딩(Vibe Coding)에 가까운 개발 방식이다.
그러던 중 평소에는 잘 사용하지 않던 코드를 발견했다.
from typing import Protocol

class ImageProvider(Protocol):
    async def generate(self, prompt: str) -> bytes:
        ...
그리고 실제 구현체는 이랬다.
class OpenAIProvider:
    async def generate(self, prompt: str) -> bytes:
        ...
이상했다.
OpenAIProvider는 ImageProvider를 상속하지 않는다.
상속이라면 다음처럼 관계가 명확하다.
class OpenAIProvider(ImageProvider):
    ...
이 코드는 보는 순간 “OpenAIProvider는 ImageProvider다”라고 이해할 수 있다.
그런데 Protocol에서는 그런 관계가 보이지 않는다.
조금 더 들여다보다가 오히려 더 근본적인 질문이 생겼다.
그런데 ImageProvider가 꼭 필요한가?
사실 ImageProvider는 없어도 된다
OpenAIProvider를 만드는 데 ImageProvider는 필요하지 않다.
class OpenAIProvider:
    async def generate(self, prompt: str) -> bytes:
        # OpenAI API 호출
        ...
이 클래스는 혼자서도 완전하다.
서비스에서도 바로 사용할 수 있다.
class CoverService:
    def __init__(self):
        self.provider = OpenAIProvider()

    async def create_cover(self, prompt: str) -> bytes:
        return await self.provider.generate(prompt)
아무 문제가 없다.
그렇다면 Codex는 왜 굳이 ImageProvider라는 것을 하나 더 만들었을까?
이 질문에서 시작하니 Protocol이 조금씩 이해되기 시작했다.
관점을 OpenAIProvider에서 CoverService로 바꿔보자
처음에는 ImageProvider를 OpenAIProvider의 부모 같은 것으로 생각했다.
하지만 관점을 사용하는 쪽, 즉 CoverService로 바꿔보자.
class CoverService:
    def __init__(self, provider):
        self.provider = provider

    async def create_cover(self, prompt: str) -> bytes:
        return await self.provider.generate(prompt)
Python에서는 이것으로 충분하다.
provider가 어떤 클래스인지는 중요하지 않다. generate()만 가지고 있으면 된다.
CoverService(OpenAIProvider())
CoverService(BedrockProvider())
CoverService(FakeProvider())
모두 generate(prompt: str) -> bytes를 제공한다면 사용할 수 있다.
이것이 Python에서 익숙한 Duck Typing이다.
Duck Typing은 자유롭지만 필요한 조건이 보이지 않는다
다시 생성자를 보자.
def __init__(self, provider):
이것만 보면 provider에 어떤 객체를 넣어야 하는지 알 수 없다.
결국 내부를 봐야 한다.
await self.provider.generate(prompt)
그제야 “generate()를 가진 객체가 필요하구나”라고 알 수 있다.
사람뿐 아니라 IDE와 정적 타입 검사기 역시 provider가 어떤 능력을 가져야 하는지 명확하게 알기 어렵다.
여기서 Protocol이 등장한다.
CoverService가 필요한 것을 타입으로 표현한다
CoverService가 원하는 것을 자연어로 표현하면 간단하다.
나는
generate(prompt: str) -> bytes를 제공하는 객체가 필요하다.
이 요구사항을 타입으로 표현한다.
from typing import Protocol

class ImageProvider(Protocol):
    async def generate(self, prompt: str) -> bytes:
        ...
그리고:
class CoverService:
    def __init__(self, provider: ImageProvider):
        self.provider = provider
이제 중요한 전제가 보인다.
ImageProvider는 OpenAIProvider를 만들기 위해 존재하는 것이 아니다.
OpenAIProvider는 ImageProvider 없이도 잘 동작한다.
ImageProvider는 오히려 CoverService가 자신에게 필요한 것이 무엇인지 타입으로 표현하기 위해 존재한다.
왜 ImageProvider에는 Protocol이 있고 OpenAIProvider에는 없을까?
둘의 역할이 다르기 때문이다.
ImageProvider
-------------
계약

"generate(prompt: str) -> bytes
를 제공해야 한다."
반면:
OpenAIProvider
--------------
실제 구현

"내가 generate()를 실제로 구현한다."
Protocol은 실제 작업을 수행한다는 표시가 아니다.
어떤 객체가 만족해야 할 구조를 정의하는 타입이다.
그래서 계약인 ImageProvider에는 Protocol을 사용하지만 실제 구현체인 OpenAIProvider에는 붙이지 않는다.
그런데 왜 상속하지 않아도 되는가?
class ImageProvider(Protocol):
    async def generate(self, prompt: str) -> bytes:
        ...

class OpenAIProvider:
    async def generate(self, prompt: str) -> bytes:
        ...
둘 사이에는 상속 관계가 없다.
그런데 정적 타입 검사 관점에서는 다음이 성립할 수 있다.
provider: ImageProvider = OpenAIProvider()
타입 검사기가 상속 관계가 아니라 구조를 비교하기 때문이다.
ImageProvider가 요구
generate(prompt: str) -> bytes

             ↕ 호환

OpenAIProvider가 제공
generate(prompt: str) -> bytes
이것이 Structural Subtyping, 구조적 서브타이핑이다.
상속과 Protocol의 질문은 다르다
상속:
OpenAIProvider
      │
      │ "나는 ImageProvider다"
      ▼
ImageProvider
상속은 명시적인 관계를 선언한다.
반면 Protocol은 이렇게 생각할 수 있다.
ImageProvider (Protocol)

"generate()를 할 수 있어야 함"
            │
            ▼
      generate(...) ?
        ▲       ▲       ▲
        │       │       │
     OpenAI  Bedrock   Fake
아주 단순하게 표현하면:
상속은 “너는 누구냐?”를 묻고, Protocol은 “너는 무엇을 할 수 있느냐?”를 묻는다.
이름을 바꿔보면 더 잘 보인다
이해를 위해 ImageProvider를 이렇게 바꿔보자.
class CanGenerateImage(Protocol):
    async def generate(self, prompt: str) -> bytes:
        ...
그리고:
class CoverService:
    def __init__(self, provider: CanGenerateImage):
        self.provider = provider
자연어처럼 읽으면 된다.
CoverService에는 이미지를 생성할 수 있는 무언가가 필요하다.
OpenAI든 Bedrock이든 Fake든 필요한 구조만 가지고 있으면 된다.
Protocol은 부모 클래스라기보다 필요한 능력을 표현하는 타입에 가깝다.
그러면 그냥 Duck Typing 아닌가?
상당히 비슷하다.
Duck Typing에서는:
def __init__(self, provider):
    self.provider = provider
라고 하고 실행할 때 generate()만 있으면 된다.
Protocol을 사용하면:
def __init__(self, provider: ImageProvider):
    self.provider = provider
그 조건을 정적 타입 시스템에 표현할 수 있다.
따라서 처음 이해할 때는 이렇게 생각해도 좋다.
Protocol은 Duck Typing의 유연함을 유지하면서 그 규칙을 정적 타입으로 표현하는 방법이다.
잘못된 객체를 넣으면 차이가 보인다
class EmailSender:
    async def send(self, message: str) -> None:
        ...
EmailSender에는 generate()가 없다.
타입이 없다면 다음처럼 전달하는 것 자체는 가능하다.
service = CoverService(EmailSender())
문제는 실행하면서 generate()를 호출할 때 발생한다.
반면 provider: ImageProvider라고 계약을 표현하면 mypy나 pyright 같은 정적 타입 검사기가 EmailSender가 필요한 구조를 만족하지 않는다는 것을 실행 전에 알려줄 수 있다.
Protocol의 주요 목적은 런타임에서 모든 타입을 강제하는 것이 아니라 정적 타입 검사기와 IDE가 객체 사이의 계약을 이해하도록 만드는 것이다.
그냥 OpenAIProvider 타입을 쓰면 되지 않을까?
물론 가능하다.
class CoverService:
    def __init__(self, provider: OpenAIProvider):
        self.provider = provider
OpenAI만 사용할 것이라면 오히려 더 명확할 수 있다.
선택지는 대략 세 가지다.
1. provider

자유로운 Duck Typing


2. provider: OpenAIProvider

구체적인 구현체에 의존


3. provider: ImageProvider

필요한 구조에 의존
Protocol은 세 번째 선택을 가능하게 해준다.
그렇다고 Protocol이 항상 필요한 것은 아니다
처음 질문으로 돌아가 보자.
ImageProvider가 없어도 OpenAIProvider를 만드는 데 아무 문제 없지 않나?
맞다.
상황에 따라서는 정말 없어도 된다.
구현체가 하나뿐이고, 교체 계획도 없고, Fake 구현체도 필요 없고, 서비스가 구체적인 구현체에 직접 의존해도 문제없다면:
class CoverService:
    def __init__(self, provider: OpenAIProvider):
        self.provider = provider
이것이 오히려 더 단순할 수도 있다.
Protocol을 사용했다고 무조건 좋은 설계가 되는 것은 아니다.
그래서 이제 처음 질문이 다른 의미로 돌아온다.
왜 Codex는 굳이 ImageProvider라는 Protocol을 만들었을까?
구현체를 교체하려는 것일까?
테스트에서 Fake Provider를 넣으려는 것일까?
외부 API와 서비스 로직을 분리하려는 것일까?
아니면 현재 상황에는 필요 없는 추상화를 AI가 추가한 것일까?
여기서부터 Protocol은 Python 문법의 문제가 아니라 소프트웨어 설계의 문제가 된다.
그냥 사용하는 것과 알고 사용하는 것은 다르다
사실 여기까지 몰라도 개발은 할 수 있다.
Codex가 코드를 작성하고 테스트가 통과한다면 그대로 사용할 수 있다.
하지만 Protocol을 이해하면 다음 코드를 보고:
class ImageProvider(Protocol):
    ...
단순히 “AI가 인터페이스 같은 것을 만들었나 보다”라고 넘어가는 대신 질문할 수 있다.
우리 코드에 이 추상화가 정말 필요한가?
이 질문을 할 수 있다는 차이가 크다.
AI가 코드를 작성하는 시대에는 모든 코드를 직접 타이핑하는 능력만큼 AI가 만든 코드의 의도를 읽고 그 선택이 적절한지 판단하는 능력도 중요해지고 있는 것 같다.
AI가 짜주는 대로 개발해도 된다.
하지만 모르고 사용하는 것과 알고 사용하는 것은 분명히 다르다.
이제 다음 질문이 남았다
1부에서는 가장 기본적인 질문에서 시작했다.
ImageProvider가 없어도 OpenAIProvider는 잘 동작하는데 왜 굳이 만들었을까?
그리고 몇 가지를 알게 됐다.
ImageProvider는 OpenAIProvider를 만들기 위해 존재하는 것이 아니다.
사용하는 쪽에서 필요한 능력을 타입으로 표현하기 위해 존재한다.
또 OpenAIProvider가 ImageProvider를 상속하지 않아도 되는 이유는 상속 관계가 아니라 구조를 기준으로 판단하기 때문이다.
그래서 Protocol은 Python의 Duck Typing과 자연스럽게 연결된다.
그런데 아직 중요한 질문 하나가 남았다.
그렇다면 Codex는 왜 구체적인 OpenAIProvider에 직접 의존하지 않고 ImageProvider라는 Protocol을 하나 더 만들었을까?
이제 Protocol이 무엇인지는 어느 정도 이해했다.
하지만 무엇인지 아는 것과 왜 사용하는지 아는 것은 또 다른 문제다.
다음 2부에서는 Provider 교체, Fake를 이용한 테스트, 외부 시스템과 비즈니스 로직의 분리, Dependency Injection과 Dependency Inversion까지 따라가면서 Codex가 왜 Protocol을 선택했는지 살펴본다.
그리고 더 중요한 질문도 함께 생각해본다.
Codex가 Protocol을 사용한 이유가 있다고 해서 우리 코드에도 반드시 필요한 것일까?
AI는 추상화를 몇 초 만에 만들어낼 수 있다.
하지만 코드를 만드는 비용이 낮아졌다고 그 구조를 이해하고 유지하는 비용까지 사라지는 것은 아니다.
다음 글
2부 — Why Did Codex Choose Python Protocol?
Protocol이 무엇인지는 알았다.
이제 왜 사용하는지를 파헤쳐보자.