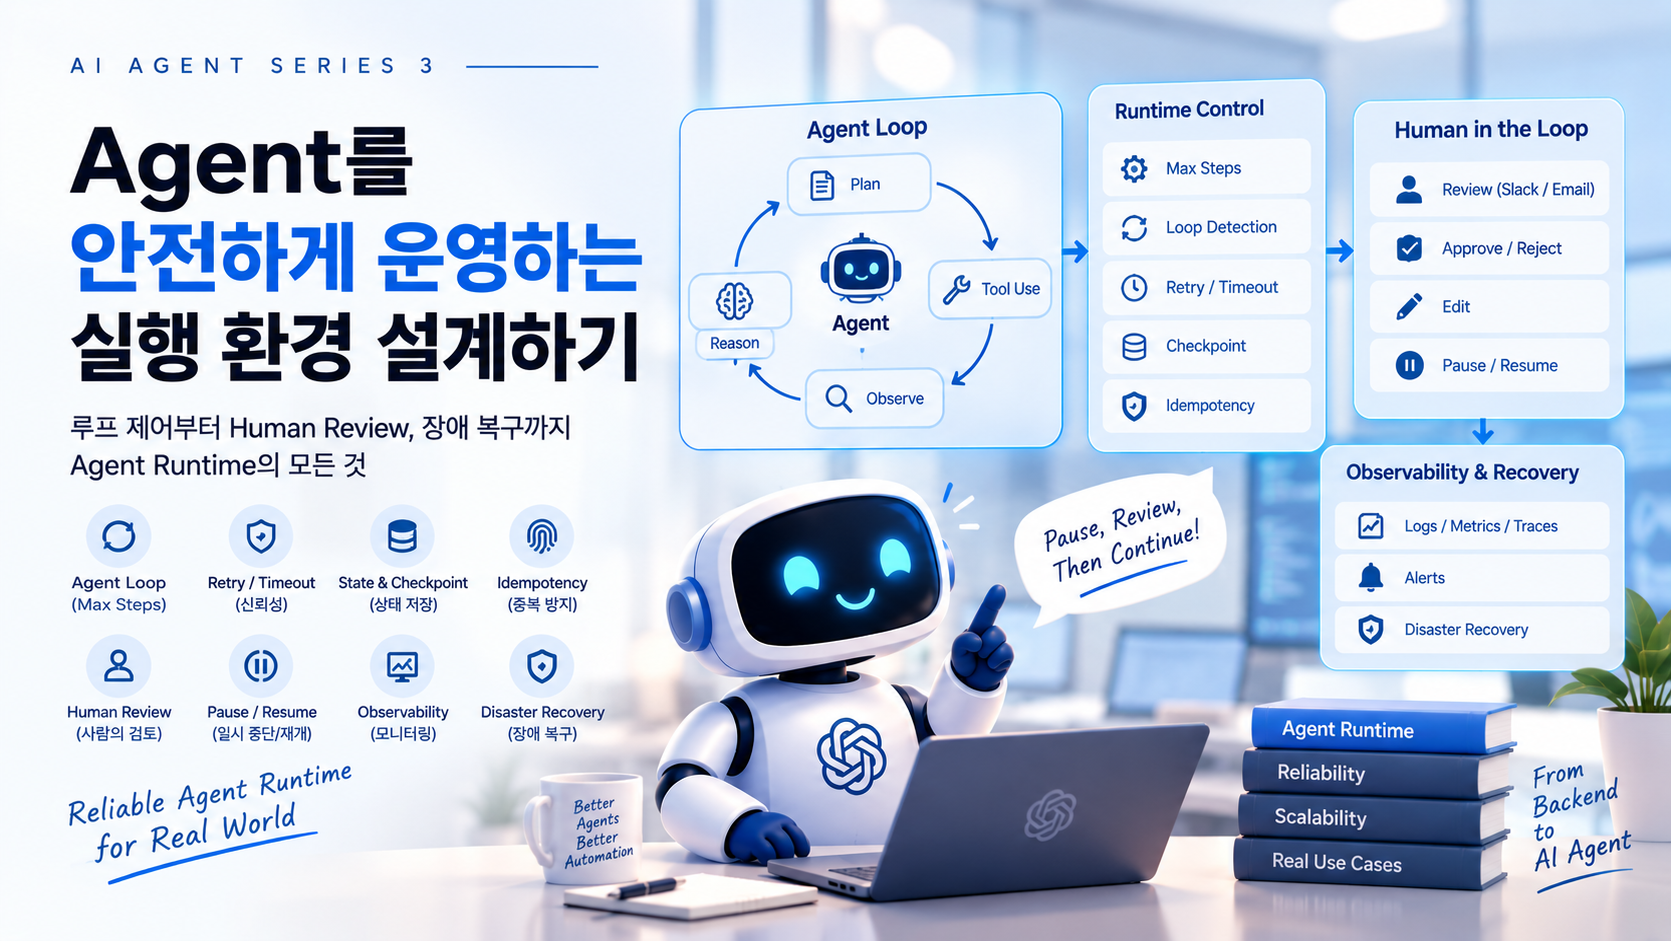
Agent Loop, 상태 관리, Retry 그리고 Human-in-the-Loop
1부에서는 Worker에서 Agent Orchestrator로 확장하는 이유를 살펴봤고, 2부에서는 Python 백엔드 기능을 MCP Tool로 제공했다.
이제 Agent에게 get_document, extract_document_content, run_ocr,
analyze_document, save_analysis, request_human_review 같은 능력이
생겼다.
그렇다면 Agent에게 “이 문서를 알아서 처리해”라고 하면 끝일까?
개발 데모에서는 가능하다. 하지만 운영 환경에서는 여기서부터 진짜 문제가 시작된다.
같은 Tool을 반복 호출하면?
잘못된 Tool을 선택하면?
Tool이 실패하면?
Worker가 죽으면?
이미 저장한 데이터를 다시 저장하면?
사람의 승인이 필요하면?
5시간 뒤 승인되면 어디서부터 다시 시작할까?
MCP Tool을 만드는 것과 운영 가능한 Agent 시스템을 만드는 것은 다른 문제다.
1. Agent의 본질은 Loop다
가장 단순한 Agent 실행 구조는 다음과 같다.
        ┌──────────────────┐
        │                  │
        ↓                  │
   LLM Decision            │
        ↓                  │
     Tool Call             │
        ↓                  │
    Tool Result ───────────┘
현재 State와 Tool 목록을 LLM에게 전달하고, LLM이 다음 Tool을 선택하고, 실행 결과를 다시 State에 넣는다.
async def run_agent(state):
    while True:
        decision = await llm.decide(
            state=state,
            tools=available_tools,
        )

        if decision.type == "finish":
            return state

        result = await call_tool(
            name=decision.tool_name,
            arguments=decision.arguments,
        )

        state.add_tool_result(
            tool_name=decision.tool_name,
            result=result,
        )
문제는 while True다. 실행 경로가 코드에 고정되어 있지 않기 때문에
Runtime이 Agent의 행동을 제한해야 한다.
2. 반드시 종료 조건이 있어야 한다
COMPLETED
FAILED
WAITING_HUMAN
MAX_STEPS_EXCEEDED
TIMEOUT
예를 들어 최대 Step을 제한한다.
MAX_STEPS = 10

async def run_agent(state):
    while state.step < MAX_STEPS:
        decision = await decide_next_action(state)

        if decision.type == "finish":
            state.status = "COMPLETED"
            return state

        result = await execute_tool(decision)
        state.add_result(result)
        state.step += 1

    state.status = "MAX_STEPS_EXCEEDED"
    return state
Agent에게 판단의 자유를 주더라도 실행 범위까지 무제한으로 주어서는 안 된다.
3. Max Steps만으로 충분하지 않다
다음처럼 같은 패턴을 반복할 수도 있다.
extract_document_content
        ↓
run_ocr
        ↓
extract_document_content
        ↓
run_ocr
        ↓
...
따라서 Loop Detection도 필요하다.
중요한 것은 Agent가 계속 행동하고 있다는 사실과 문제를 해결하고 있다는 사실은 다르다는 점이다.
4. Tool 실패와 Agent 실패는 다르다
Tool Failure
     ↓
Recoverable?
   ┌────┴────┐
   ↓         ↓
  YES        NO
   ↓         ↓
Retry /     Agent
Alternative FAILED
예를 들어 일시적인 OCR 오류는 복구 가능할 수 있다.
{
  "success": false,
  "reason": "OCR_TEMPORARY_ERROR",
  "retryable": true
}
지원하지 않는 파일 형식은 재시도해도 의미가 없을 수 있다.
{
  "success": false,
  "reason": "UNSUPPORTED_FILE_FORMAT",
  "retryable": false
}
5. Retry는 Agent가 할까, Tool이 할까?
네트워크 Timeout이나 일시적인 5xx 오류까지 LLM에게 판단시킬 필요는 없다.
async def run_ocr(document_id):
    for attempt in range(3):
        try:
            return await ocr_client.analyze(document_id)
        except TemporaryError:
            if attempt == 2:
                raise
            await asyncio.sleep(2 ** attempt)
반면 분석 결과의 신뢰도가 낮아 다른 Analyzer나 Human Review를 선택하는 것은 의미적 판단이다.
Technical Retry
      ↓
Tool / Service Layer

Semantic Retry
      ↓
Agent / Orchestrator
6. Timeout도 계층별로 나눈다
HTTP Timeout
LLM Timeout
Tool Timeout
Agent Step Timeout
Agent Run Timeout
Human Review Timeout
Human Review는 일반 Timeout과 다르다. 몇 시간 동안 프로세스를 붙잡아 두는 대신 Workflow를 Pause하는 편이 좋다.
7. Agent에게 State가 필요한 이유
{
  "run_id": "run_123",
  "document_id": "doc_123",
  "status": "RUNNING",
  "step": 3,
  "last_tool": "analyze_document",
  "document_type": "invoice",
  "confidence": 0.58,
  "retry_count": 0
}
Agent Runtime은 이 State를 기준으로 다음 행동을 결정한다.
8. State와 LLM Context는 같은 것이 아니다
LLM Context
- System Prompt
- Tool Definitions
- Previous Tool Results
- Current Task

Runtime State
- run_id
- status
- step
- retry_count
- last_tool
- checkpoint
- document_id
LLM Context는 모델의 판단을 위한 정보이고, Runtime State는 시스템이 Agent 실행을 관리하고 복구하기 위한 정보다.
9. State는 메모리에만 두면 안 된다
Worker가 죽어도 복구하려면 중요한 State를 외부 저장소에 기록해야 한다.
agent_runs
- run_id
- document_id
- status
- current_step
- last_tool
- retry_count
- created_at
- updated_at

agent_steps
- id
- run_id
- step_no
- tool_name
- input
- output
- status
- started_at
- finished_at
- error
10. Checkpoint를 만든다
Tool Execute
     ↓
Tool Result
     ↓
Save Checkpoint
     ↓
Next Decision
Worker가 죽으면 새 Worker가 마지막 Checkpoint를 불러와 Resume할 수 있다.
Worker Crash
     ↓
New Worker
     ↓
Load run_123
     ↓
Last Checkpoint
     ↓
Resume
11. Resume은 생각보다 어렵다
다음 상황을 보자.
Step 5
save_analysis
      ↓
Database INSERT 성공
      ↓
Worker Crash
      ↓
Checkpoint 저장 실패
DB에는 데이터가 있지만 State에는 성공 기록이 없다. 새 Worker는
save_analysis를 다시 호출할 수 있다.
그래서 Write Tool의 Idempotency가 중요하다.
12. Agent 시스템의 Idempotency
예를 들어 operation_id를 사용한다.
{
  "operation_id": "run_123_step_5",
  "document_id": "doc_123"
}
DB에서 operation_id를 Unique하게 관리하면 재호출 시 이전 결과를 반환할
수 있다.
First Call
run_123_step_5
      ↓
INSERT
      ↓
SUCCESS

Second Call
run_123_step_5
      ↓
Already Processed
      ↓
Return Previous Result
13. Human-in-the-Loop가 들어오면 구조가 달라진다
Invoice 분석 결과가 다음과 같다고 해보자.
{
  "document_type": "invoice",
  "confidence": 0.58,
  "amount": 12500000
}
Agent는 Human Review를 선택한다.
analyze_invoice
      ↓
confidence = 0.58
      ↓
request_human_review
사람이 10초 뒤 응답할지, 5시간 뒤 응답할지 알 수 없다. Worker를 계속 실행한 채 기다리는 것은 비효율적이다.
14. Human Review에서는 Agent를 Pause한다
Agent
  ↓
request_human_review
  ↓
Create Review Task
  ↓
Save Checkpoint
  ↓
status = WAITING_HUMAN
  ↓
Worker 종료
State는 다음처럼 저장할 수 있다.
{
  "run_id": "run_123",
  "document_id": "doc_123",
  "status": "WAITING_HUMAN",
  "current_step": 5,
  "last_tool": "request_human_review",
  "confidence": 0.58
}
이 상태에서는 Agent 프로세스가 존재할 필요가 없다.
15. 사람이 승인하면 Event가 Agent를 다시 깨운다
5시간 뒤 담당자가 승인했다고 해보자.
Human
  ↓
Approve
  ↓
Review API
  ↓
Event
Redis Streams를 사용한다면 다음과 같은 Resume Event를 만들 수 있다.
XADD agent:resume *
     run_id run_123
     action approved
Redis Stream
      ↓
Agent Worker
      ↓
Load run_123
      ↓
Resume Agent
파일 업로드 Event가 Agent를 처음 깨웠듯이 Human Approval Event가 Agent를 다시 깨운다.
16. Pause와 Resume을 코드로 생각해보자
async def run_agent(state):
    while True:
        decision = await decide_next_action(state)

        if decision.type == "human_review":
            await create_review_task(state)

            state.status = "WAITING_HUMAN"
            await save_checkpoint(state)

            return

        result = await execute_tool(decision)

        state.add_result(result)
        await save_checkpoint(state)
사람의 응답이 들어오면 별도 Handler가 실행된다.
async def resume_agent(run_id, human_result):
    state = await load_state(run_id)

    state.human_result = human_result
    state.status = "RUNNING"

    await save_checkpoint(state)
    await run_agent(state)
핵심은 await human_response()로 몇 시간 동안 기다리지 않는다는 것이다.
State를 저장하고 프로세스를 종료한 뒤 Event가 들어오면 다시 실행한다.
17. Human Review에도 Timeout이 필요하다
사람이 영원히 응답하지 않을 수도 있다.
{
  "review_id": "review_123",
  "run_id": "run_123",
  "status": "WAITING",
  "expires_at": "2026-09-14T12:00:00"
}
만료되면 EXPIRED로 바꾸거나 담당자에게 재알림을 보낼 수 있다.
WAITING_HUMAN
      ↓
TTL / Deadline
      ↓
Expired?
 ┌────┴────┐
 ↓         ↓
NO        YES
 ↓         ↓
Wait    Re-notify / EXPIRED
18. Human Review 결과도 구조화해야 한다
단순히 “승인”만 있는 것은 아니다.
APPROVE
REJECT
EDIT
EDIT라면 사람이 수정한 데이터도 함께 반환할 수 있다.
{
  "action": "EDIT",
  "data": {
    "vendor": "OpenAI Korea",
    "amount": 12500000
  }
}
Agent는 Human Result를 새로운 State로 받아 다음 작업을 이어간다.
19. Agent가 Resume될 때 LLM을 다시 호출해야 할까?
항상 그럴 필요는 없다.
사람의 승인 이후 다음 행동이 명확하다면 코드가 바로 실행할 수도 있다.
Human APPROVE
      ↓
Policy
      ↓
create_erp_record
반대로 사람이 수정한 내용에 따라 추가 검증이 필요하다면 Agent에게 다시 판단을 맡길 수 있다.
Human EDIT
      ↓
Agent
      ↓
Validate Again?
      ↓
Next Tool
여기에서도 같은 원칙이 적용된다.
결정적인 규칙은 코드가 처리하고, 의미적 판단이 필요한 지점에서 Agent를 사용한다.
20. Agent의 상태 머신을 명시적으로 만들어보자
Agent를 자유로운 Loop로만 생각하지 않고 상태 머신으로 보는 것도 유용하다.
CREATED
   ↓
RUNNING
   ├──→ COMPLETED
   ├──→ FAILED
   ├──→ WAITING_HUMAN
   │         ↓
   │       RESUME
   │         ↓
   └────── RUNNING
예를 들어 다음 상태를 정의할 수 있다.
CREATED
RUNNING
WAITING_HUMAN
COMPLETED
FAILED
EXPIRED
CANCELLED
상태 전이를 명확하게 정의하면 운영과 장애 복구가 쉬워진다.
21. Tool 실행과 Agent Decision을 모두 기록한다
Tool 실행 기록뿐 아니라 Agent가 어떤 결정을 내렸는지도 추적할 필요가 있다.
run_123

Step 1
Decision: get_document
Result: SUCCESS

Step 2
Decision: extract_document_content
Result: SUCCESS

Step 3
Decision: analyze_invoice
Result: confidence 0.58

Step 4
Decision: request_human_review
Result: WAITING

5 hours later

Step 5
Human: APPROVE

Step 6
Decision: create_erp_record
Result: SUCCESS
이런 실행 이력은 디버깅, 감사, 비용 분석, Agent 품질 평가에 모두 도움이 된다.
22. Observability에서 봐야 할 것
일반 API의 latency와 error rate만으로는 충분하지 않다.
Agent Run Count
Completion Rate
Failure Rate
Average Steps
Tool Calls per Run
LLM Calls per Run
Average Run Duration
Human Review Rate
Retry Rate
Loop Detection Count
Tool Error Rate
Token Usage
Cost per Run
예를 들어 Human Review 비율이 지나치게 높다면 Agent Prompt나 Analyzer 품질에 문제가 있을 수 있다.
평균 Step이 갑자기 증가한다면 Agent가 불필요한 Tool을 호출하기 시작했을 수도 있다.
23. Agent의 비용도 Runtime 문제다
Agent Loop에서는 LLM 호출이 여러 번 발생할 수 있다.
Decision 1 → LLM
Tool
Decision 2 → LLM
Tool
Decision 3 → LLM
Tool
Decision 4 → LLM
따라서 Run 단위로 다음을 기록하는 것이 좋다.
input_tokens
output_tokens
llm_calls
tool_calls
model
total_cost
Agent가 더 유연하다는 이유만으로 고정 Workflow보다 훨씬 많은 비용을 사용하고 있지는 않은지 확인해야 한다.
24. 모든 Tool Result를 LLM Context에 계속 넣어야 할까?
Agent가 오래 실행되면 Context가 계속 커질 수 있다.
Step 1 Result
Step 2 Result
Step 3 Result
...
Step 30 Result
Runtime State와 LLM Context를 분리하면 이 문제를 다루기 쉬워진다.
DB에는 전체 이력을 보관하되 LLM에는 현재 판단에 필요한 요약된 State만 전달할 수 있다.
Full History
    ↓
Database

Relevant State
    ↓
LLM Context
이것은 비용과 Context Window 관리에도 중요하다.
25. MCP Server는 Agent Runtime이 아니다
역할을 다시 구분해보자.
Agent Runtime
- State
- Loop
- Retry
- Pause / Resume
- Checkpoint

Orchestrator
- Next Action 결정
- Tool 선택

MCP
- Tool 연결
- Tool Schema
- Tool 호출

Tool
- 실제 업무 수행
MCP가 Agent의 상태를 저장하거나 Workflow를 복구해주는 것은 아니다.
MCP는 Capability Interface이고, Agent Runtime은 실행 엔진이다.
이 둘을 구분해야 아키텍처가 명확해진다.
26. 전체 Runtime 구조
                    Event
                      │
                      ↓
                 Agent Worker
                      │
                      ↓
                Load / Create State
                      │
                      ↓
                 Agent Runtime
                      │
              ┌───────┴───────┐
              ↓               ↓
         Orchestrator       State Store
              │
              ↓
          LLM Decision
              │
              ↓
           MCP Client
              │
              ↓
           MCP Server
              │
              ↓
             Tool
              │
              ↓
          Service Layer
              │
              ↓
        External Systems
Tool Result가 돌아오면 Checkpoint를 저장하고 다음 Decision을 수행한다.
27. Invoice 예제로 전체 흐름을 따라가 보자
사용자가 Invoice PDF를 업로드한다.
Invoice Upload
      ↓
FastAPI
      ↓
Object Storage
      ↓
Redis Stream
      ↓
Agent Worker
Agent Run을 생성한다.
{
  "run_id": "run_123",
  "document_id": "doc_123",
  "status": "RUNNING",
  "step": 0
}
Agent가 문서를 조회한다.
Step 1
get_document
      ↓
SUCCESS
내용을 추출한다.
Step 2
extract_document_content
      ↓
SUCCESS
Invoice를 분석한다.
Step 3
analyze_invoice
      ↓
confidence = 0.58
신뢰도가 낮다.
Step 4
request_human_review
      ↓
WAITING_HUMAN
Checkpoint를 저장하고 Worker는 종료된다.
28. 5시간 뒤
담당자가 검토 화면에서 내용을 확인한다.
금액과 거래처가 맞다.
Human
  ↓
APPROVE
Resume Event가 발생한다.
XADD agent:resume *
     run_id run_123
     action APPROVE
새 Worker가 State를 읽는다.
Load run_123
      ↓
status = WAITING_HUMAN
      ↓
human_result = APPROVE
      ↓
status = RUNNING
이제 다음 작업을 실행한다.
create_erp_record
      ↓
SUCCESS
최종 State를 저장한다.
{
  "run_id": "run_123",
  "document_id": "doc_123",
  "status": "COMPLETED",
  "last_tool": "create_erp_record"
}
전체 흐름은 다음과 같다.
Invoice Upload
      ↓
Agent Start
      ↓
Extract
      ↓
Analyze
      ↓
Confidence = 0.58
      ↓
Human Review
      ↓
Agent Pause

      ... 5시간 후 ...

Human Approve
      ↓
Resume Event
      ↓
Agent Resume
      ↓
ERP Registration
      ↓
Completed
이제 Agent는 단순히 LLM이 Tool 몇 개를 호출하는 프로그램이 아니다.
29. 실제 운영에서는 Agent를 “오래 실행되는 함수”로 만들지 않는다
다음과 같은 구현은 피하는 편이 좋다.
async def process_invoice():
    result = await analyze()

    human_result = await wait_for_human()

    await register_erp(human_result)
wait_for_human()이 5시간 동안 Worker를 붙잡고 있을 수 있기 때문이다.
대신 실행을 작은 구간으로 나눈다.
Execution Segment 1
Upload → Analyze → Human Review
                 ↓
               PAUSE

Execution Segment 2
Human Event → Resume → ERP
Agent Run이라는 논리적 실행은 계속되지만 실제 프로세스는 필요할 때만 살아난다.
30. Queue와 Agent는 경쟁 관계가 아니다
Agent를 도입했다고 Redis Streams나 SQS가 필요 없어지는 것은 아니다.
오히려 Event Driven Architecture와 잘 결합된다.
Upload Event
     ↓
Agent Start

Human Event
     ↓
Agent Resume

Retry Event
     ↓
Agent Retry

Timeout Event
     ↓
Agent Expire
Queue는 언제 실행할 것인가를 전달하고 Agent는 실행된 뒤 무엇을 할 것인가를 판단한다.
31. 어디까지 Agent에게 맡겨야 할까?
다음은 코드가 처리하는 편이 좋다.
Permission Check
File Size Limit
Retry Count Limit
Unique Constraint
Timeout
State Transition Validation
Idempotency
다음은 Agent가 개입할 가치가 있다.
Document Classification
Tool Selection
Alternative Analysis Strategy
Semantic Validation
Additional Information 필요 여부
Human Review 필요 여부
Agent를 많이 사용하는 것이 좋은 아키텍처는 아니다.
불확실성이 있는 곳에만 Agent를 넣는 것이 더 중요하다.
32. Agent Runtime에서 최소한 필요한 안전장치
운영 시스템이라면 최소한 다음을 고려해야 한다.
Max Steps
Loop Detection
Tool Timeout
Agent Run Timeout
Retry Policy
Idempotency
State Persistence
Checkpoint
Tool Permission
Human Approval
Audit Log
Observability
Cost Tracking
이것들이 없으면 Agent는 똑똑한 자동화 도구가 아니라 예측하기 어려운 백엔드 프로세스가 될 수 있다.
33. 결국 Agent는 새로운 형태의 Workflow Runtime이다
전통적인 Workflow는 실행 경로가 미리 정해져 있다.
A → B → C → D
Agent Workflow는 일부 경로가 런타임에 결정된다.
             ┌→ B → D
             │
A → Agent ───┼→ C → E
             │
             └→ Human → F
하지만 운영 시스템의 관점에서는 여전히 State, Retry, Timeout, Checkpoint, Resume, Audit이 필요하다.
즉 Agent가 기존 Workflow Engine의 문제를 없애는 것이 아니다.
오히려 Workflow Runtime 위에 LLM 기반 의사결정을 추가한다고 보는 편이 정확하다.
34. 1부부터 다시 연결해보자
1부의 시작은 아주 단순했다.
File Upload
    ↓
Worker
    ↓
Analyze
    ↓
Save
업무가 복잡해지면서 판단을 분리했다.
File Upload
    ↓
Agent Orchestrator
    ↓
Tools
2부에서는 Tool을 MCP로 제공했다.
Agent
  ↓
MCP Client
  ↓
MCP Server
  ↓
Tools
3부에서는 Agent가 실제 운영 환경에서 살아남기 위한 Runtime을 추가했다.
                  Agent Runtime
                       │
        ┌──────────────┼──────────────┐
        ↓              ↓              ↓
      State        Orchestrator    Checkpoint
                       │
                       ↓
                      MCP
                       │
                       ↓
                     Tools
                       │
        ┌──────────────┼──────────────┐
        ↓              ↓              ↓
      Retry          Human          Audit
                     Review
이제 처음의 단순한 Worker가 꽤 다른 형태의 시스템으로 발전했다.
마치며
MCP Tool을 Agent에게 연결하는 것 자체는 어렵지 않다.
어려운 것은 Agent에게 자유를 준 이후다.
언제 멈출 것인가?
실패하면 어떻게 복구할 것인가?
같은 Tool을 다시 호출해도 안전한가?
Worker가 죽으면 어디서 다시 시작할 것인가?
사람을 기다려야 하면 어떻게 Pause할 것인가?
몇 시간 뒤 어떻게 Resume할 것인가?
Agent가 무엇을 했는지 어떻게 추적할 것인가?
비용이 얼마나 들었는지 어떻게 알 것인가?
이 문제들을 해결하면서 Agent는 단순한 Tool Calling 프로그램에서 상태를 가진 Workflow Runtime으로 바뀐다.
그리고 여기서 중요한 원칙은 하나다.
Agent에게 판단을 맡기되, 실행의 통제권까지 모두 넘기지는 않는다.
LLM은 의미적 판단과 Tool 선택에 강점이 있다.
반면 Timeout, Retry Limit, Idempotency, Permission, State Transition 같은 규칙은 코드가 더 잘한다.
둘을 적절하게 결합하는 것이 운영 가능한 Agent 시스템의 핵심이다.
다음 글
4부 — Agent Runtime을 실제 Python 코드로 만들어보기
Redis Streams + State Store + MCP로 Pause/Resume 가능한 Agent 구현
다음 편에서는 지금까지의 개념을 실제 코드 구조로 내려볼 수 있다.
FastAPI
   ↓
Redis Streams
   ↓
Agent Worker
   ↓
Agent Runtime
   ├── State Store
   ├── Orchestrator
   └── MCP Client
          ↓
       MCP Server
          ↓
        Tools
그리고 다음 시나리오를 실제 구현 대상으로 삼을 수 있다.
Invoice Upload
      ↓
Agent 실행
      ↓
분석
      ↓
Human Review 요청
      ↓
WAITING_HUMAN
      ↓
Worker 종료

      ... 승인 Event ...

Agent Resume
      ↓
ERP 등록
      ↓
COMPLETED
여기까지 구현하면 지금까지 설명한 Agent Architecture가 실제 동작하는 백엔드 프로그램의 형태를 갖추게 된다.