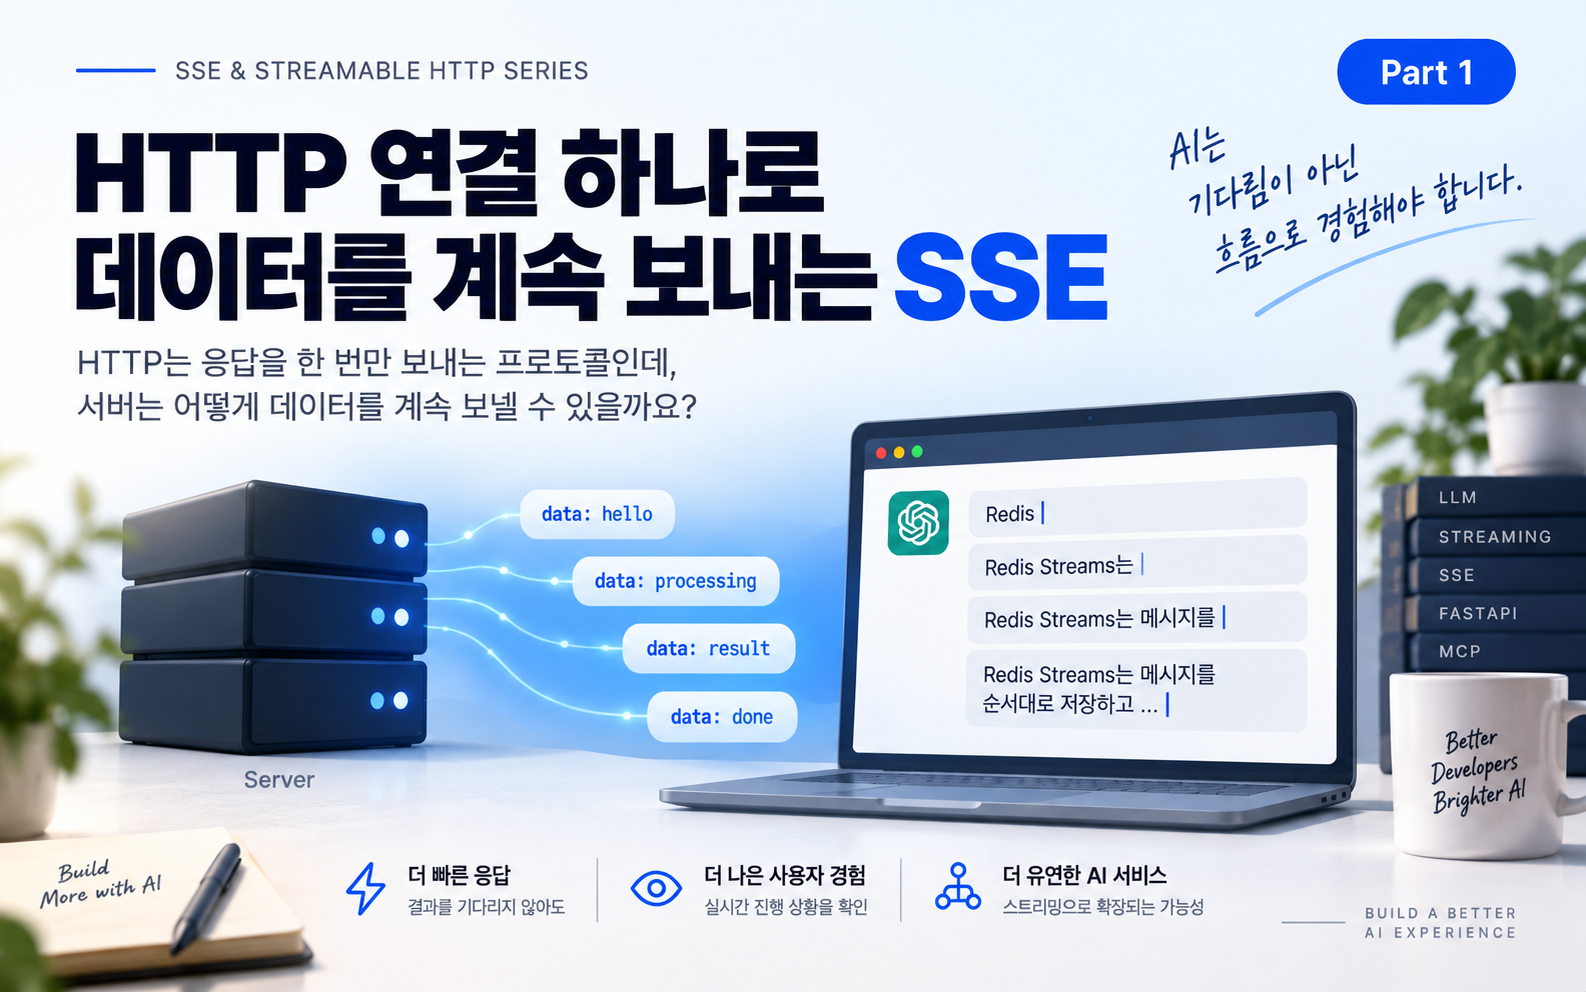
LLM을 이용한 서비스를 개발하다 보면 자연스럽게 스트리밍(Streaming)이라는 말을 접하게 됩니다.
ChatGPT에 질문을 입력했을 때를 생각해봅시다. 답변 전체가 완성될 때까지 기다렸다가 한꺼번에 화면에 나타나는 것이 아니라, 생성되는 내용이 조금씩 화면에 나타납니다.
Redis
Redis Streams는
Redis Streams는 메시지를
Redis Streams는 메시지를 순서대로...
서버에서는 아직 답변을 만들고 있는데 클라이언트는 이미 그 일부를 받고 있습니다. 이것이 우리가 흔히 말하는 스트리밍 응답(Streaming Response)입니다.
그런데 여기서 한 가지 궁금증이 생깁니다.
HTTP는 요청(Request)을 보내면 응답(Response)을 한 번 받는 프로토콜 아닌가?
그렇다면 서버는 어떻게 하나의 HTTP 요청에 데이터를 여러 번 보내는 것처럼 동작할 수 있을까요? 이 질문을 이해하면 SSE(Server-Sent Events)의 동작 방식도 자연스럽게 이해할 수 있습니다.
1. 우리가 익숙한 HTTP 요청과 응답
일반적인 HTTP API는 다음과 같이 동작합니다.
Client                              Server
   │                                   │
   │──── POST /question ──────────────>│
   │                                   │
   │                                   │ 처리
   │                                   │ 처리
   │                                   │ 처리
   │                                   │
   │<──────── Response ────────────────│
   │                                   │
클라이언트가 요청을 보내면 서버가 작업을 수행합니다. 작업이 끝나면 서버는 결과를 응답으로 돌려줍니다.
예를 들어 FastAPI에서 다음과 같은 API가 있다고 해봅시다.
@app.post("/question")
async def question():
    result = await generate_answer()
return {"answer": result}generate_answer()가 10초 걸린다면 사용자는 10초 동안
아무것도 받지 못합니다.
0초    질문 전송
 │
 │      서버 처리 중...
 │
10초   전체 답변 수신
일반적인 REST API에서는 별문제가 아닙니다. 하지만 LLM처럼 처리 시간이 길면서 중간 결과를 사용자에게 보여줄 수 있는 서비스에서는 이야기가 달라집니다.
2. LLM은 이미 결과를 만들고 있다
LLM이 다음과 같은 답변을 생성한다고 해봅시다.
Redis Streams는 메시지를 순서대로 저장하고
여러 Consumer가 이를 처리할 수 있도록 제공하는
Redis의 메시징 기능입니다.
모델이 10초 동안 아무것도 하지 않다가 마지막 순간에 문장 전체를 갑자기 만들어내는 것은 아닙니다. 출력 토큰은 순차적으로 생성됩니다.
1초  → "Redis"
2초  → " Streams는"
3초  → " 메시지를"
4초  → " 순서대로"
...
그렇다면 서버는 전체 답변이 완성될 때까지 기다리지 않고, 생성되는 데이터를 클라이언트에게 바로 전달할 수 있습니다.
LLM
 │
 ├── Redis
 ├── Streams는
 ├── 메시지를
 └── 순서대로...
       │
       ▼
     Client
여기서 필요한 것이 HTTP Streaming입니다.
3. HTTP 응답은 반드시 한 번에 보내야 할까?
HTTP 요청 하나에는 HTTP 응답 하나가 대응합니다. 하지만 HTTP 응답 하나를 반드시 한 번에 전부 보내야 하는 것은 아닙니다.
일반적인 응답은 다음과 같습니다.
HTTP/1.1 200 OK
Content-Type: application/json

{"answer":"Redis Streams는 ..."}
반면 서버가 응답을 바로 종료하지 않고 데이터를 조금씩 전달할 수도 있습니다.
HTTP Response 시작
        │
        ├── 데이터 A
        ├── 데이터 B
        ├── 데이터 C
        ├── 데이터 D
        │
        └── Response 종료
중요한 점은 응답을 네 번 보낸 것이 아니라는 것입니다. HTTP Response는 여전히 하나입니다.
Request 1개
      │
      ▼
Response 1개
      ├── chunk
      ├── chunk
      ├── chunk
      └── chunk
단지 Response Body가 한꺼번에 전달되지 않고 점진적으로 전달되는 것입니다. 이 개념이 SSE를 이해하는 핵심입니다.
4. SSE(Server-Sent Events)
SSE는 서버에서 클라이언트 방향으로 이벤트를 전달하기 위한 방식입니다.
Server ────────────────> Client서버는 HTTP 응답을 유지하면서 클라이언트에게 이벤트를 계속 전달합니다.
Client                              Server
   │                                   │
   │──── GET /events ─────────────────>│
   │                                   │
   │<──── data: hello ─────────────────│
   │<──── data: processing ────────────│
   │<──── data: result ────────────────│
   │<──── data: done ──────────────────│
   │                                   │
HTTP 요청이 계속 발생하는 것이 아닙니다. 처음 만들어진 HTTP 연결을 통해 하나의 Response가 계속 전달되고 있는 것입니다.
5. SSE의
text/event-stream
일반적인 JSON API는 다음과 같은 Content-Type을 사용합니다.
Content-Type: application/jsonSSE에서는 다음을 사용합니다.
Content-Type: text/event-stream실제 데이터는 대략 다음과 같은 형식으로 전달됩니다.
data: hello

data: processing

data: result

data: done
각 이벤트는 빈 줄로 구분됩니다. 이벤트 이름과 JSON 데이터도 사용할 수 있습니다.
event: progress
data: {"progress": 30}

event: progress
data: {"progress": 70}

event: complete
data: {"result": "finished"}
6. FastAPI에서는 어떻게 구현할까?
FastAPI에서는 StreamingResponse를 이용할 수
있습니다.
from fastapi import FastAPI
from fastapi.responses import StreamingResponse
import asyncio

app = FastAPI()

async def event_generator():
    for i in range(5):
        yield f"data: message {i}\n\n"
        await asyncio.sleep(1)

@app.get("/stream")
async def stream():
    return StreamingResponse(
        event_generator(),
        media_type="text/event-stream"
    )
여기서 중요한 부분은 yield입니다. return은
값을 반환하고 함수를 종료하지만, yield는 값을 하나 내보낸
뒤 실행 상태를 유지합니다.
event_generator()
       │
       ├── yield message 0
       │      잠시 중단
       ├── yield message 1
       │      잠시 중단
       ├── yield message 2
       │      ...
       └── 종료
그래서 서버가 데이터를 생성하는 즉시 HTTP Response Body에 조금씩 전달하는 스트리밍 처리와 잘 어울립니다.
7. LLM과 SSE가 잘 어울리는 이유
개념적인 코드는 다음과 같습니다.
async def generate():
    async for token in llm.stream(prompt):
        yield f"data: {token}\n\n"
전체 데이터 흐름은 다음과 같습니다.
LLM
 │ token 생성
 ▼
Python Async Iterator
 │ yield
 ▼
StreamingResponse
 │
 ▼
HTTP
 │
 ▼
Browser
LLM이 데이터를 생성할 때마다 서버가 받아 클라이언트에게 바로 전달할 수 있습니다.
8. SSE가 정말 데이터를 여러 번 보내는 것일까?
겉으로는 서버가 메시지를 계속 보내는 것처럼 보입니다. 하지만 SSE는 기본적으로 하나의 HTTP Response를 이용합니다.
Client
   │
   │ HTTP Request
   ▼
Server
   │
   ▼
HTTP Response
┌───────────────────────────────┐
│ data: message 1               │
│                               │
│ data: message 2               │
│                               │
│ data: message 3               │
│                               │
│ data: message 4               │
└───────────────────────────────┘
새로운 Response가 계속 만들어지는 것이 아닙니다. 하나의 Response가 아직 끝나지 않은 것입니다.
9. SSE는 양방향 통신이 아니다
SSE 스트림 자체의 데이터 흐름은 기본적으로 서버에서 클라이언트 방향입니다.
Server ────────────────> Client반면 WebSocket은 연결 이후 양쪽에서 메시지를 주고받을 수 있습니다.
Client <──────────────> ServerSSE를 사용하면서 클라이언트가 서버로 데이터를 보내야 한다면 별도의 HTTP 요청을 사용할 수 있습니다.
             HTTP POST
Client ──────────────────────> Server

                SSE
Client <────────────────────── Server
이 차이는 이후 WebSocket과 Streamable HTTP를 이해할 때 중요합니다.
10. SSE가 특히 잘 맞는 상황
SSE는 서버에서 발생하는 정보를 클라이언트가 지속적으로 받아야 하는 상황에 잘 맞습니다.
- LLM 답변 스트리밍
- Agent 작업 진행 상태
- 파일 분석 진행률
- 실시간 알림
- 로그 스트리밍
- 장시간 작업 상태 전달
예를 들어 AI 문서 분석 서비스에서는 다음과 같은 진행 상태를 전달할 수 있습니다.
사용자
  │ PDF 업로드
  ▼
Server
  │
  ├── 업로드 완료
  ├── OCR 시작
  ├── OCR 완료
  ├── 데이터 분석 중
  ├── 필드 추출 완료
  └── 분석 완료
        │
        ▼
      Browser
11. 그렇다면 WebSocket을 쓰면 되지 않을까?
WebSocket도 훌륭한 선택입니다. 특히 클라이언트와 서버가 지속적으로 양방향 메시지를 교환해야 한다면 WebSocket이 자연스러운 경우가 많습니다.
하지만 모든 스트리밍 문제에 양방향 연결이 필요한 것은 아닙니다. LLM 답변처럼 대부분의 데이터가 서버에서 클라이언트 방향으로 흐른다면 HTTP 기반의 SSE만으로도 충분할 수 있습니다.
12. 그런데 문제가 하나 있다
AI Agent가 MCP Server와 통신한다고 생각해봅시다.
Agent
  │
  ├── initialize
  ├── tools/list
  ├── tools/call
  └── tools/call
        │
        ▼
    MCP Server
여기서는 단순한 Server → Client 스트리밍을 넘어 요청,
응답, 알림, 스트리밍, 세션 같은 통신 요구사항을 함께 생각해야
합니다.
Request
Response
Notification
Streaming
Session
그리고 여기서 Streamable HTTP 이야기가 시작됩니다.
마치며
SSE를 이해할 때 가장 중요한 것은 data: 문법이나
FastAPI의 StreamingResponse 사용법이 아닙니다.
HTTP Response는 반드시 한 번에 전달될 필요가 없다.
HTTP 요청 하나에 응답 하나가 대응한다는 기본 구조는 그대로 유지됩니다. 다만 그 하나의 Response를 바로 끝내지 않고 데이터를 조금씩 전달할 수 있습니다.
Request
   │
   ▼
Response
   │
   ├── data
   ├── data
   ├── data
   ├── data
   └── end
SSE는 이 특성을 이용해 서버에서 클라이언트로 이벤트를 지속적으로 전달합니다. 그래서 LLM 스트리밍, 작업 진행 상태, Agent 실행 로그처럼 서버에서 계속 발생하는 데이터를 사용자에게 전달해야 하는 상황에서 유용합니다.
다음 편에서는 SSE만으로는 무엇이 부족한지, WebSocket과는 어떤 차이가 있는지, 그리고 왜 MCP의 통신 구조를 이해하려면 단순한 Server → Client 스트리밍을 넘어 생각해야 하는지 살펴보겠습니다.
다음 편
SSE와 Streamable HTTP 2부 — SSE만으로는 부족한가? 양방향 통신과 RPC의 문제